تقنية VocabX تخفض تكلفة استنتاج النماذج اللغوية الصغيرة بنسبة 77%
تعتمد Dharma-AI على إعادة بناء قاموس الرموز (Tokenizer) بدلاً من التركيز على التردد، لتقليل التكاليف التشغيلية للنماذج المتخصصة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحدي الكفاءة في النماذج المتخصصة
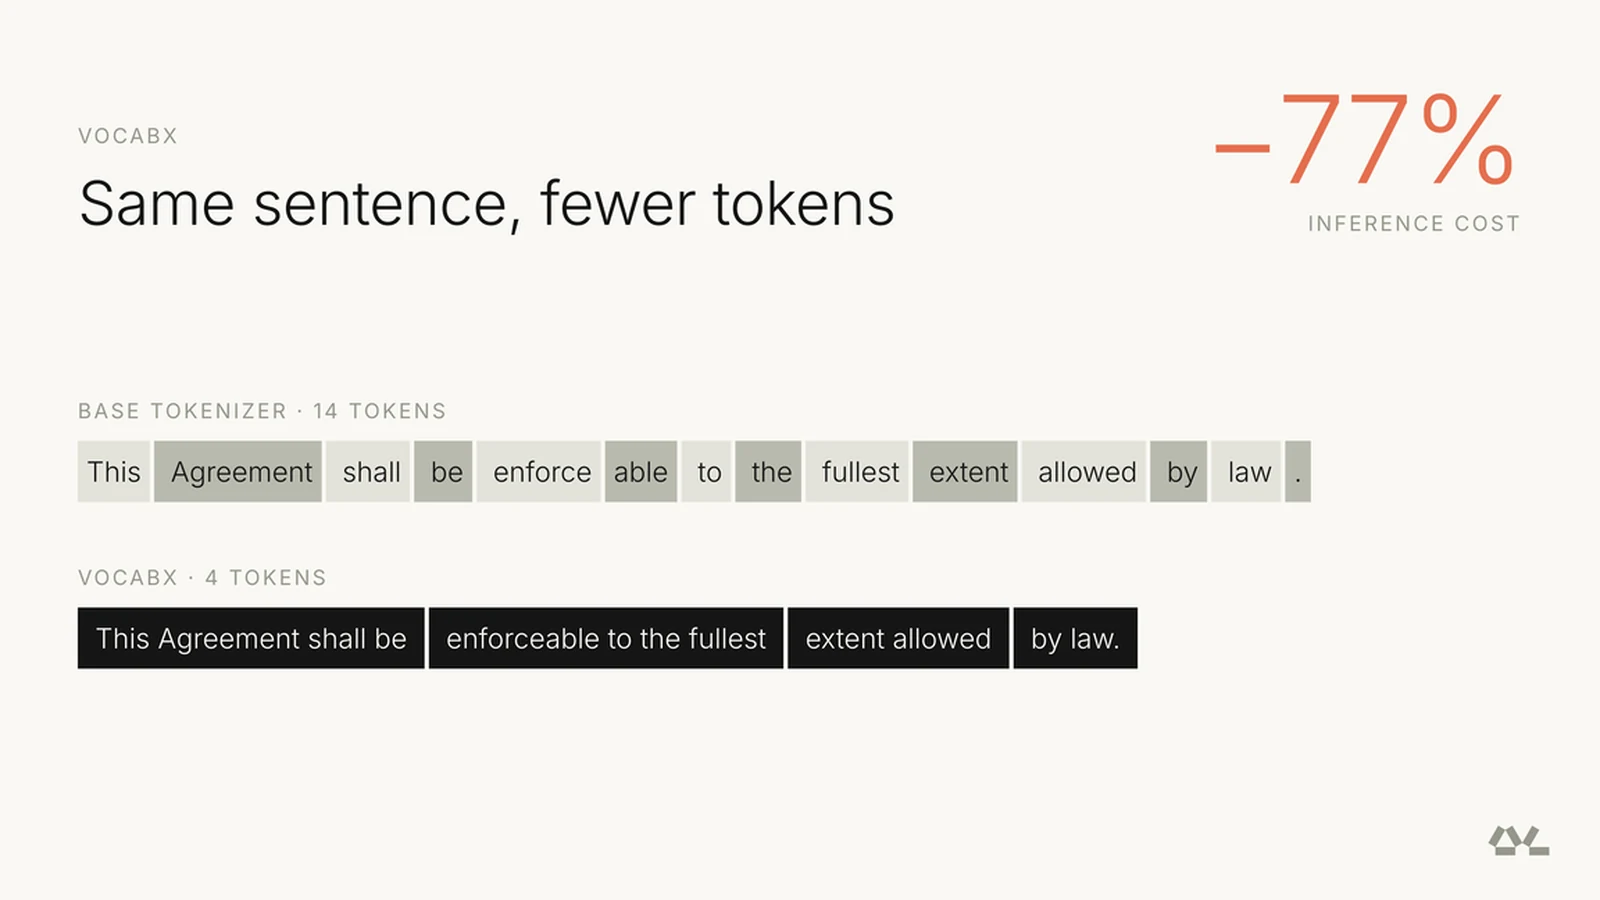
تواجه النماذج اللغوية المفتوحة المصدر، مثل Qwen وGemma، تحدياً كبيراً عند تخصيصها لمهام محددة. فعندما يتم ضبط هذه النماذج على مجال معين، فإنها تحتفظ بقاموس رموز (Vocabulary) مصمم لتغطية لغات ومجالات متنوعة. هذا القاموس العام يؤدي إلى كفاءة منخفضة في التطبيقات المتخصصة، حيث يتم تقسيم النصوص المتكررة في المجال المستهدف إلى عدد كبير من الرموز غير الضرورية. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
أوضحت شركة Dharma-AI في مدونة تقنية منشورة على منصة Hugging Face أن هذا القاموس العام يمثل أحد أكبر عوامل التكلفة في النماذج الصغيرة. في نظام التصحيح الآلي للأكواد البرتغالية الذي تشغله الشركة، كان النموذج يستخدم قاموس Qwen3-4B الأصلي المصمم لـ 151,669 رمزاً، رغم أن المهمة تتطلب لغة واحدة وصيغة إجابة محددة. هذا أدى إلى زيادة عدد الرموز المطلوبة لكل طلب، مما رفع التكلفة التشغيلية دون إضافة قيمة حقيقية.
آلية عمل VocabX
طورت Dharma-AI تقنية جديدة تسمى VocabX لإعادة بناء قاموس الرموز. بدلاً من الاعتماد على تكرار ظهور الكلمات في البيانات التدريبية، تركز التقنية على تكلفة كل رمز في عملية الاستنتاج. هذا النهج يميز بين الرموز التي تظهر في مدخلات النموذج وتلك التي تظهر في مخرجاته، مع الأخذ في الاعتبار أن توليد الرمز الواحد يكلف أكثر بكثير من قراءته.
تعمل التقنية على تقليل حجم طبقة LM Head (رأس النموذج اللغوي) التي تحسب احتمالات كل رمز. في النموذج الأصلي، كانت هذه الطبقة تحتوي على حوالي 152,000 صف من المعاملات، بينما انخفضت إلى حوالي 65,000 صف بعد تطبيق VocabX. هذا التقليل المباشر في حجم المصفوفة يقلل من كمية البيانات التي يجب نقلها من الذاكرة إلى المعالج في كل خطوة من خطوات التوليد، مما يحسن الكفاءة بشكل كبير.
لماذا التكلفة أعلى من التردد؟
تشرح Dharma-AI أن عملية الاستنتاج تتكون من مرحلتين: التمهيد (Prefill) والتفكيك (Decode). في مرحلة التمهيد، يعالج النموذج المدخلات دفعة واحدة، حيث تكون الحوسبة هي العنق الزجاجة. أما في مرحلة التفكيك، فيولد النموذج الإجابة رمزاً تلو الآخر، وتصبح عرضة الذاكرة (Memory Bandwidth) هي العامل المحدد للأداء. في النظام الذي اختبرته الشركة، تبيّن أن تكلفة توليد رمز واحد تكافئ تكلفة قراءة 7.4 رموز.
هذا الفرق في التكلفة يعني أن تقليل عدد الرموز في المخرجات (الإجابة) له تأثير أكبر بكثير على التكلفة الإجمالية مقارنة بتقليل الرموز في المدخلات. الأساليب التقليدية التي تحاول ضغط المدخلات والمخرجات بالتساوي تفشل في تحقيق أقصى توفير ممكن. لذلك، صمم VocabX ليعطي أولوية للرموز التي تظهر بكثرة في المخرجات، لأنها الأكثر تكلفة في التشغيل.
مقارنة مع الأساليب السابقة
لم تكن فكرة تكييف قاموس النموذج جديدة، حيث توجد أساليب مثل Fast Vocabulary Transfer (FVT) وMulti-word Tokenization (MWT). كما توجد تقنيات مثل التوسعة في الموقع (In-place Tokenizer Expansion) التي تستمر في تدريب BPE من القاموس الأصلي. ومع ذلك، وجدت Dharma-AI أن هذه الأساليب تعاني من قيودين رئيسيتين عند تطبيقها على مهام متخصصة.
أولاً، تختار هذه الأساليب الرموز بناءً على التردد فقط، مما قد يؤدي إلى إهمال عبارات مهمة في المخرجات إذا كانت أقل تكراراً في المدخلات. ثانياً، تعمل هذه الأساليب غالباً على طبقة واحدة فقط، إما بتعديل طريقة تقطيع الكلمات أو بدمج العبارات الكاملة. لم يجمع أي من هذه الأساليب بين هاتين المهمتين تحت معيار موحد يراعي التكلفة الفعلية للاستنتاج.
النتائج العملية والتطبيق الميداني
في الاختبارات الميدانية على نظام التصحيح الآلي، حققت تقنية VocabX انخفاضاً بنسبة 77% في تكلفة الاستنتاج المقاسة. تم تحقيق هذا الإنجاز مع الحفاظ على النموذج الأساسي (Qwen3-4B) وبيانات التدريب وخطة التدريب دون تغيير. هذا يعني أن التحسين جاء حصرياً من إعادة هيكلة قاموس الرموز، مما يجعل التقنية قابلة للتطبيق على نطاق واسع دون الحاجة إلى إعادة تدريب النموذج بالكامل.
تؤكد الشركة أن هذه النتائج تأتي من النسخة الحالية من الورقة البحثية التي لا تزال قيد المراجعة، وقد تتغير الأرقام النهائية قبل النشر الرسمي. ومع ذلك، فإن الاتجاه العام يشير إلى أن تخصيص القاموس بناءً على التكلفة هو رافعة قوية لتقليل التكاليف في النماذج اللغوية الصغيرة التي تعمل في بيئات إنتاجية حقيقية.
آفاق التقنية المستقبلية
تقدم تقنية VocabX حلاً عملياً لمشكلة شائعة في مجال الذكاء الاصطناعي، وهي التكلفة العالية لتشغيل النماذج المتخصصة. من خلال التركيز على كفاءة الذاكرة والحوسبة بدلاً من مجرد تقليل عدد الرموز، توفر هذه التقنية مساراً واضحاً لتحسين الأداء الاقتصادي للنماذج اللغوية الصغيرة. هذا النهج قد يفتح الباب لتطبيقات أوسع في مجالات تتطلب استجابة سريعة وتكلفة منخفضة.
يظل التحدي الأكبر هو تعميم هذه التقنية على مجالات أخرى لغوية أو تقنية. ومع ذلك، فإن نجاحها في نظام التصحيح الآلي للأكواد البرتغالية يثبت جدواها العملية. كما تشير الشركة إلى أن تقليل حجم طبقة LM Head له تأثير مباشر على استهلاك الذاكرة، مما يجعل النماذج المخصصة أكثر ملاءمة للتشغيل على أجهزة ذات موارد محدودة.
المصادر
- Hugging Face BlogHow Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
تابع التسلسل الزمني
أخبار مرتبطة
Liquid AI تكشف عن LFM3: نماذج متعددة الوسائط مخصصة للأجهزة الطرفية
تطلق Liquid AI جيل LFM3 الجديد من النماذج الأساسية، مدمجاً النص والصوت والرؤية في بنية موحدة بحجم 2 مليار معلمة، مما يتيح تخصيص الذكاء الاصطناعي على جهاز واحد.
إطلاق نموذج DSpark لتسريع نماذج الرؤية واللغة في LFM2.5
أعلنت Liquid AI عن إطلاق نموذج DSpark التجريبي لتسريع نموذج الرؤية واللغة LFM2.5-VL-3B، مع دعم فوري لعدة منصات لتحسين كفاءة الاستدلال.
Liquid AI تطلق نماذج d1 المفتوحة للقرارات الذكية على الحافة
تُطلق Liquid AI نماذج d1-3B و d1-omni-600M المفتوحة، وهي نماذج متعددة الوسائط سريعة تستجيب في أقل من 50 مللي ثانية على أجهزة الحافة، متفوقةً على المنافسين في جودة القرار.
إطلاق نموذج الذكاء الاصطناعي المفتوح Apertus 1.5 بقدرات متعددة الوسائط
أعلنت مبادرة الذكاء الاصطناعي السويسرية عن إطلاق نموذج Apertus 1.5 بنسختيه 8B و70B، متضمناً فهماً للصور والصوت ووضع تفكير مخصص للقدرات الاستدلالية.