Liquid AI تطلق نماذج d1 المفتوحة للقرارات الذكية على الحافة
أعلنت شركة Liquid AI عن إطلاق نسختين من عائلة نماذج d1 للقرارات، مصممة لتقديم استجابات فورية ودقيقة دون الحاجة إلى توليد نصوص طويلة، مما يجعلها مثالية للتطبيقات الحساسة للزمن.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق نماذج قرارات مفتوحة المصدر
أعلنت شركة Liquid AI رسمياً عن إطلاق نموذجين مفتوحين ضمن عائلة نماذج d1 للقرارات، وهما d1-3B و d1-omni-600M (تجريبي). وتهدف هذه النماذج إلى سد الفجوة بين النماذج التوليدية الضخمة والحاجة إلى قرارات فورية وموثوقة في بيئات الحوسبة على الحافة. وتتميز هذه النماذج بأنها مفتوحة الأوزان ومتاحة للتحميل الفوري من منصة Hugging Face، مما يتيح للمطورين والباحثين الوصول إليها بسهولة.
تفوق في جودة القرار والسرعة
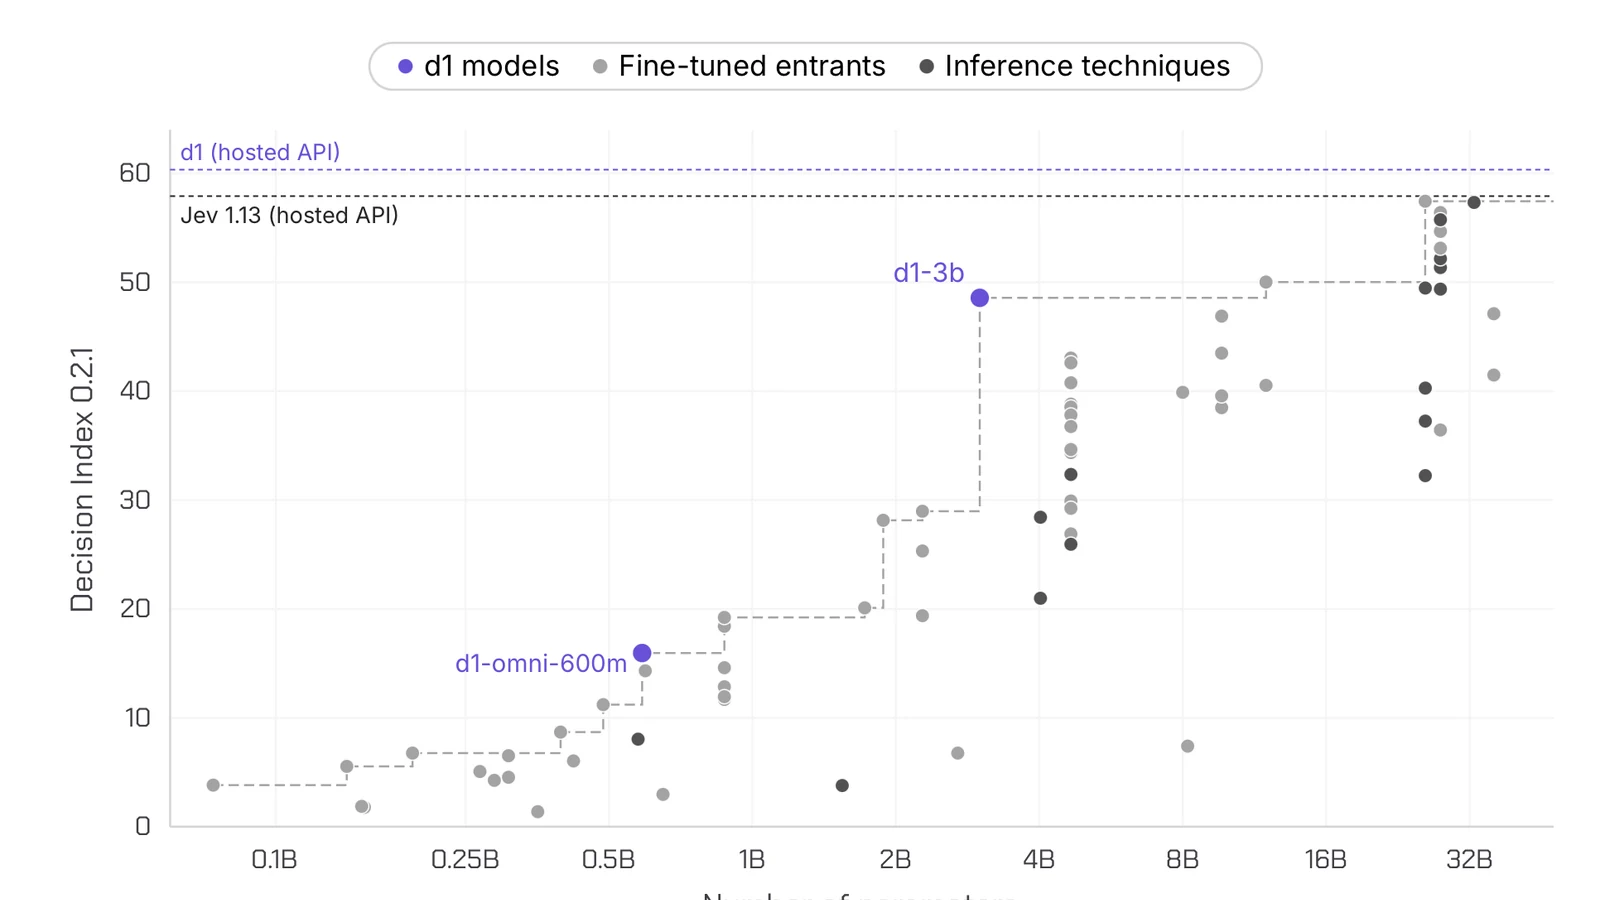
تُعد سرعة الاستجابة وجودة القرار المقياسين الأهم لهذه النماذج. وحسب البيانات المنشورة، حقق نموذج d1-3B نتيجة 48.57 في مؤشر القرار (Decision Index) الإصدار 0.2.1، متفوقاً على جميع النماذج ذات الحجم 4B و 9B، وكذلك على نموذج Decider 35B-A3B الذي سجل 47.11. كما أظهر النموذج أداءً قوياً في الاختبارات العامة، حيث حقق متوسط نقاط بلغ 82.9 عبر سبع مجموعات بيانات عامة تغطي الفهم القرائي وكشف السمية وتصنيف النية والأسئلة الطبية والفهم المتعدد اللغات.
أما النموذج التجريبي d1-omni-600M، فقد سجل 78.4 نقطة، متجاوزاً نموذج Decider 2B (77.1) رغم أنه يمتلك ربع عدد المعاملات فقط. وتؤكد الشركة أن هذه النتائج تعكس كفاءة البنية التحتية للنماذج في تقديم إجابات هيكيلية سريعة دون الحاجة إلى معالجة رموز متعددة.
تقنية Liquid Foundation Models
تعتمد نماذج d1 على تقنية Liquid Foundation Models (LFMs) التي طورتها Liquid AI. وعلى عكس النماذج التوليدية التقليدية التي تولد النص رمزاً تلو الآخر، تعمل نماذج القرار هذه من خلال تمريرة أمامية واحدة (single forward pass) لإنتاج الإجابة النهائية. هذا التصميم يقلل بشكل كبير من زمن الاستجابة ويقلل من استهلاك الطاقة، مما يجعلها مناسبة للتطبيقات التي تتطلب معالجة فورية للبيانات.
دعم متعدد الوسائط
تتميز النماذج الجديدة بدعمها لمدخلات متعددة الوسائط. فيُقبل نموذج d1-3B مدخلات النص والصورة، بينما يدعم d1-omni-600M إما النص مع الصورة أو النص مع الصوت. وقد تم تدريب d1-3B على أساس LFM2.5-VL-3B، وهو نموذج رؤية-لغة (VLM) يعتمد على معالج وحيد الاتجاه (decoder-only). أما d1-omni-600M فقد تم تدريبه على LFM2.5-Encoder-350M، وهو معالج ثنائي الاتجاه يضيف وحدات ترميز للرؤية والصوت لمعالجة جميع الوسائط الثلاث. وتجدر الإشارة إلى أن d1-omni-600M لا يزال في مرحلة البحث المبكر وتخضع لتطوير إضافي.
الأداء على أجهزة NVIDIA
في تعاون مع شركة NVIDIA، تم تقييم أداء d1-3B عبر مجموعة من الأجهزة تشمل NVIDIA GeForce RTX 4090 وأجهزة Jetson. أظهرت النتائج أن النموذج يستجيب لسؤال واحد في أقل من 50 مللي ثانية على جميع الأجهزة المقاسة. تحديداً، استغرق 16 مللي ثانية على Jetson AGX Thor، و 26 مللي ثانية على Jetson AGX Orin، و 50 مللي ثانية على Jetson Orin Nano. وعند معالجة ثلاثة أسئلة متتالية، زادت المدة إلى 1.3 مرة فقط من مدة سؤال واحد، مما يدل على كفاءة عالية في المعالجة المتوازية.
على مستوى وحدات معالجة الرسوميات (GPU)، يستجيب d1-3B لسؤال في أقل من 10 مللي ثانية، ويعالج صورة بدقة 384 بكسل في أقل من 18 مللي ثانية على المنصتين. ولم تُعلن الشركة عن أرقام سرعة للنموذج d1-omni-600M نظراً لكونه إصداراً بحثياً مبكراً.
التوفر والاستخدام
أصبحت كلا النماذج متاحة الآن كأوزان مفتوحة على Hugging Face. ولتسهيل تجربة المستخدمين، وفرت الشركة عروضاً تفاعلية في مساحة System One Arcade. ويتطلب تشغيل هذه النماذج استخدام مكتبة transformers بإصدار 5.14 أو أحدث، مع تفعيل خيار trust_remote_code=True لتحميل الكود المرافق للنموذج. وتوفر الشركة أمثلة استخدام مفصلة لنموذج d1-3B، بينما تشير إلى بطاقة النموذج (model card) للحصول على تعليمات تشغيل d1-omni-600M.
المصادر
- Hugging Face BlogMultimodal open d1 decision models for the edge
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
إطلاق نموذج DSpark لتسريع نماذج الرؤية واللغة في LFM2.5
أعلنت Liquid AI عن إطلاق نموذج DSpark التجريبي لتسريع نموذج الرؤية واللغة LFM2.5-VL-3B، مع دعم فوري لعدة منصات لتحسين كفاءة الاستدلال.
غياب OpenAI عن تحالف Nvidia لوقف وكلاء الذكاء الاصطناعي الخارجين عن السيطرة
تعمل OpenAI سرًا مع Nvidia رغم غيابها العلني عن منصة Open Agent Safety Platform، في خطوة تهدف إلى معالجة أزمات الوكلاء الخارجين عن السيطرة.
NVIDIA DGX Spark 64GB: منصة محلية لتوسيع قدرات الذكاء الاصطناعي
تطلق NVIDIA إصداراً جديداً من DGX Spark بذاكرة موحدة 64GB، يتيح للمطورين تشغيل نماذج ذكاء اصطناعي محلية وتوسيعها عبر تجميع الوحدات دون الحاجة للسحابة.
إطلاق Olmo-core 3: بنية تحتية مفتوحة لتدريب نماذج MoE الضخمة
أطلقت مؤسسة Ai2 إطار Olmo-core 3، وهو نظام مفتوح المصدر مصمم لتدريب نماذج مزيج الخبراء (MoE) بكفاءة عالية، مما يوسع نطاق الوصول لأبحاث الذكاء الاصطناعي المتقدمة.