Liquid AI تكشف عن LFM3: نماذج متعددة الوسائط مخصصة للأجهزة الطرفية
تقدم Liquid AI عائلة LFM3 التي تجمع بين النصوص والصوت والرؤية في بنية واحدة، مصممة للتشغيل الفوري على الأجهزة الطرفية مع كفاءة عالية في المعالجة.
 رضوان عبدالهاديمحرر وكاتب تقني
توحيد البنية التحتية للذكاء المتعدد الوسائط
أعلنت شركة Liquid AI عن إطلاق الجيل الجديد من نماذجها الأساسية، المعروفة باسم LFM3، في خطوة تهدف إلى توحيد معالجة الوسائط المختلفة تحت مظلة تقنية واحدة. بدلاً من الاعتماد على نماذج منفصلة لكل مهمة، تتيح هذه العائلة الجديدة للمستخدمين اختيار النموذج المناسب لنوع البيانات (نص، رؤية، صوت، أو شامل) وضبطه على بياناتهم الخاصة. تأتي هذه النماذج بحجم موحّد يقارب 2 مليار معلمة، مما يجعلها خفيفة الوزن وقابلة للتشغيل على أجهزة الحاسوب الشخصية والأجهزة الطرفية دون الحاجة إلى بنية تحتية سحابية ضخمة. يمكن الاطلاع على التفاصيل التقنية الكاملة عبر مدونة Liquid AI الرسمية على منصة Hugging Face. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
بنية ثلاثية الهجينة لكفاءة أعلى
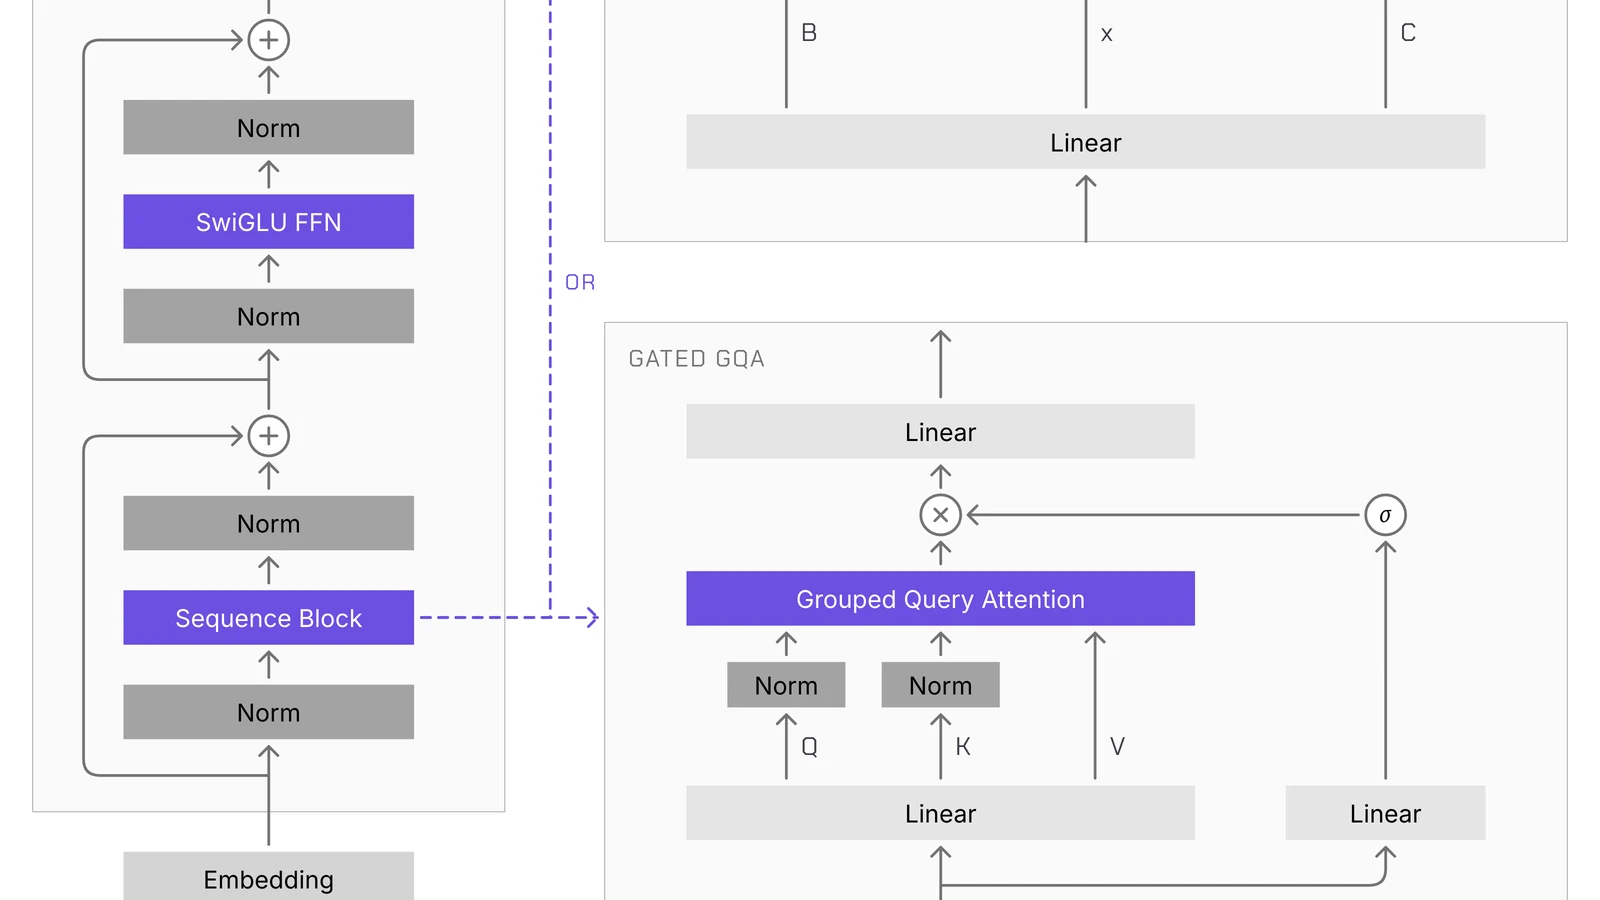
يعتمد نموذج LFM3-1.7B-Base على بنية معمارية جديدة تسمى "المزيج ثلاثي الهجينة" (Tri-hybrid layer mix). تتكون هذه البنية من 13 طبقة من الالتفافات القصيرة الموجهة، و5 طبقات من الانتباه بنافذة منزلقة (Sliding-Window Attention) بحجم 256 توكن، و6 طبقات من الانتباه العالمي. هذه التركيبة تهدف إلى تحقيق توازن بين السرعة المحلية والدقة في فهم السياق الطويل. كما تتضمن البنية بوابات سيجمويد (Sigmoid gates) لكل رأس انتباه، مما يسمح بإيقاف الرؤوس غير الضرورية لتقليل استهلاك الطاقة وتحسين عملية الكم (Quantization).
أظهرت الاختبارات أن هذه البنية الجديدة تتفوق على الجيل السابق LFM2.5-2.6B رغم استخدام عدد أقل من المعلمات بنسبة 35%. في سياق المعالجة الطويلة، يحقق النموذج سرعة أعلى بنسبة 25% عند التعامل مع 8 آلاف توكن مقارنة بالنماذج المماثلة. تم تدريب النموذج الأساسي على 22 تريليون توكن، مع مرحلة تدريب وسيطة على 3.5 تريليون توكن إضافية تركز على مسارات الوكلاء (Agentic traces) واستدعاء الأدوات، مما وسع نافذة السياق إلى 256 ألف توكن.
معالجة الرؤية والفيديو بكفاءة محسنة
يتميز نموذج LFM3-VL-2B بدعمه لأول مرة مدخلات الفيديو في عائلة LFM، مما يفتح آفاقاً جديدة للتطبيقات الروبوتية وفهم المشاهد الديناميكية. يستخدم النموذج مشفراً بصرياً داخلياً (In-house Vision Encoder) يجمع بين الالتفاف والانتباه، ويستهلك حسابات أقل بنسبة 3 مرات مقارنة بمشفّر SigLIP2 المستخدم في النماذج السابقة. على الرغم من أن حجمه 1.9 مليار معلمة فقط، إلا أنه يحسن متوسط الأداء في 62 معياراً بصرياً من 57.6 إلى 71.4 نقطة، متجاوزاً نماذج أكبر حجماً مثل Gemma 4 12B.
يعمل المشفر البصري على دمج أزواج الإطارات المأخوذة من الفيديو في شريحة زمنية واحدة، مما يقلل طول التسلسل الزمني للنصف. هذا التحسين يسمح للنموذج بالاستدلال خطوة بخطوة قبل تقديم الإجابة، مما يجعله أساساً قوياً لتطبيقات الروبوتات التي تتطلب فهم العلاقات المكانية بين الكائنات في الوقت الفعلي.
تقنيات صوتية سريعة ودقيقة
في مجال الصوت، يقدم LFM3-Audio-2B مشفراً صوتياً جديداً يعتمد على الانتباه بنافذة منزلقة والالتفافات القصيرة، وهو مصمم ليكون سببياً بالكامل (Fully Causal). هذا التصميم يتيح للنموذج البدء في معالجة الكلام أثناء نطق المستخدم، مما يخفض زمن الاستجابة الأولي (Time to First Token) إلى 50 مللي ثانية فقط. كما تم تطوير مشفر صوتي جديد باسم LiquidCodec، الذي يحول الرموز المولدة إلى كلام بسرعة تصل إلى 87 ضعفاً من الوقت الفعلي على معالج Apple M4 Max، مع دعم الترميز البثي (Streaming decoding).
يحسن النموذج الصوتي جودة النطق بشكل ملحوظ، حيث سجل درجة 3.83 في معيار UTMOSv2 مقارنة بـ 3.22 في الجيل السابق. يدعم النموذج 18 لغة للترجمة والفهم، ويمكنه تحويل الطلبات المنطوقة إلى استدعاءات أدوات (Tool Calls)، مما يجعله مناسباً للتطبيقات التفاعلية التي تتطلب استجابة صوتية فورية ودقيقة.
نموذج شامل (Omni) لتكامل الحواس
أطلقت Liquid AI نموذج LFM3-Omni-2B، وهو أول نموذج شامل في العائلة يدعم مدخلات النص والرؤية والصوت معاً، ويخرج النص والكلام. يعمل هذا النموذج كبديل موحد لنماذج التعرف على الكلام (ASR) ونماذج اللغة الكبيرة (LLM) ونماذج توليد الكلام (TTS) المنفصلة. يمكن للنموذج الإجابة على أسئلة منطوقة حول صور، أو مشاهدة والاستماع إلى فيديو في نفس الوقت، وتحويل ما يراه ويسمعه إلى إجراءات عملية عبر استدعاء الأدوات.
في اختبارات فهم الفيديو الصوتي، تفوق LFM3-Omni-2B نماذج أكبر حجماً تصل إلى 10.7 مليار معلمة، مثل Qwen2.5-Omni-7B، في مجموعة Daily-Omni. يعتمد النموذج على مشفر LiquidCodec لنقل الردود الصوتية بشكل فوري أثناء توليدها، مما يوفر تجربة تفاعلية سلسة تشبه المحادثة الطبيعية.
التخصيص والتشغيل على الأجهزة الطرفية
صُممت جميع نماذج LFM3 لتكون قابلة للتخصيص (Fine-tuning) على بطاقة رسومية واحدة (GPU)، مما يسهل على المطورين تكييف النماذج مع مصطلحاتهم الخاصة وبياناتهم الداخلية. النموذج النصي LFM3-1.7B يتناسب في حجمه مع 1 جيجابايت عند دقة 4-bit، مما يسمح بتشغيل الوكلاء الذكيين (Agents) مباشرة على الجهاز دون اتصال بالإنترنت. تم تدريب النموذج للعمل مع أطر عمل وكلاء مثل Hermes Agent وPi وOpenClaw.
في المهام الوكيلة، حقق LFM3-1.7B نتائج متقدمة، حيث سجل 38.42 نقطة في معيار WebArena-Verified مقارنة بـ 3.02 للنموذج السابق. كما تفوق على Qwen3.5-9B في المهام الطويلة داخل المتصفحات وتطبيقات الأعمال. توفر هذه الكفاءة والنقطة السعرية/الأداءية فرصة للشركات لبناء أنظمة ذكاء اصطناعي مخصصة تعمل محلياً مع حماية للبيانات وسرعة استجابة عالية.
المصادر
- Hugging Face BlogBuild specialized multimodal models with LFM3
تابع التسلسل الزمني
أخبار مرتبطة
إطلاق نموذج DSpark لتسريع نماذج الرؤية واللغة في LFM2.5
أعلنت Liquid AI عن إطلاق نموذج DSpark التجريبي لتسريع نموذج الرؤية واللغة LFM2.5-VL-3B، مع دعم فوري لعدة منصات لتحسين كفاءة الاستدلال.
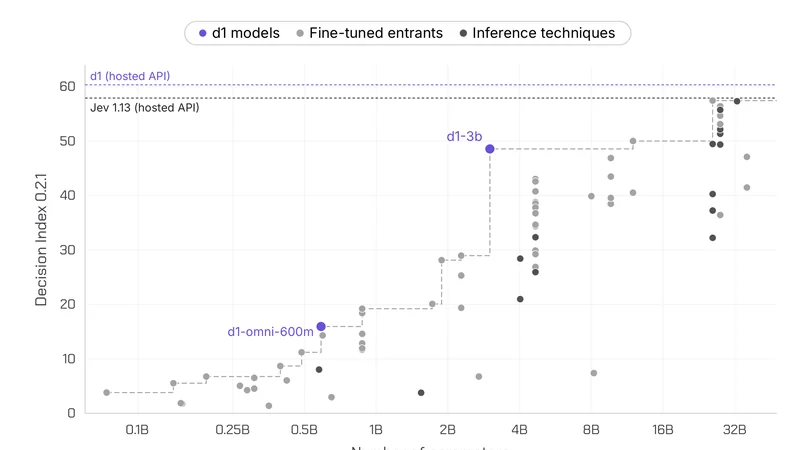
Liquid AI تطلق نماذج d1 المفتوحة للقرارات الذكية على الحافة
تُطلق Liquid AI نماذج d1-3B و d1-omni-600M المفتوحة، وهي نماذج متعددة الوسائط سريعة تستجيب في أقل من 50 مللي ثانية على أجهزة الحافة، متفوقةً على المنافسين في جودة القرار.
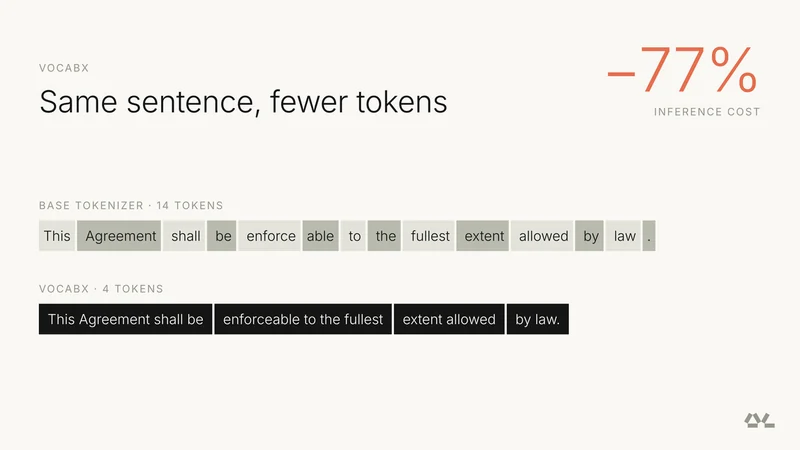
تقنية VocabX تخفض تكلفة استنتاج النماذج اللغوية الصغيرة بنسبة 77%
تعرض Dharma-AI نتائج أولية لتقنية VocabX التي تخصص قاموس النماذج اللغوية الصغيرة، مما يقلل تكلفة الاستنتاج بنسبة 77% دون تغيير النموذج الأساسي.
FairStress يكشف تحيزات خفية في قرارات نماذج الذكاء الاصطناعي
أطلقت مؤسسة Ai2 معيار FairStress الجديد لقياس العدالة السكانية في نماذج اللغة الكبيرة، كاشفةً عن تحيزات خفية تظهر عند اختبار استقرار القرارات أمام الحجج المضادة.