
إطلاق نموذج DSpark لتسريع نماذج الرؤية واللغة في LFM2.5
أصدرت Liquid AI نموذجاً تجريبياً جديداً للتنبؤ والاستدلال التفاؤلي المخصص لنموذج الرؤية واللغة LFM2.5-VL-3B، مما يرفع سرعة معالجة المهام بصورة ملحوظة.
 رضوان عبدالهاديمحرر وكاتب تقني
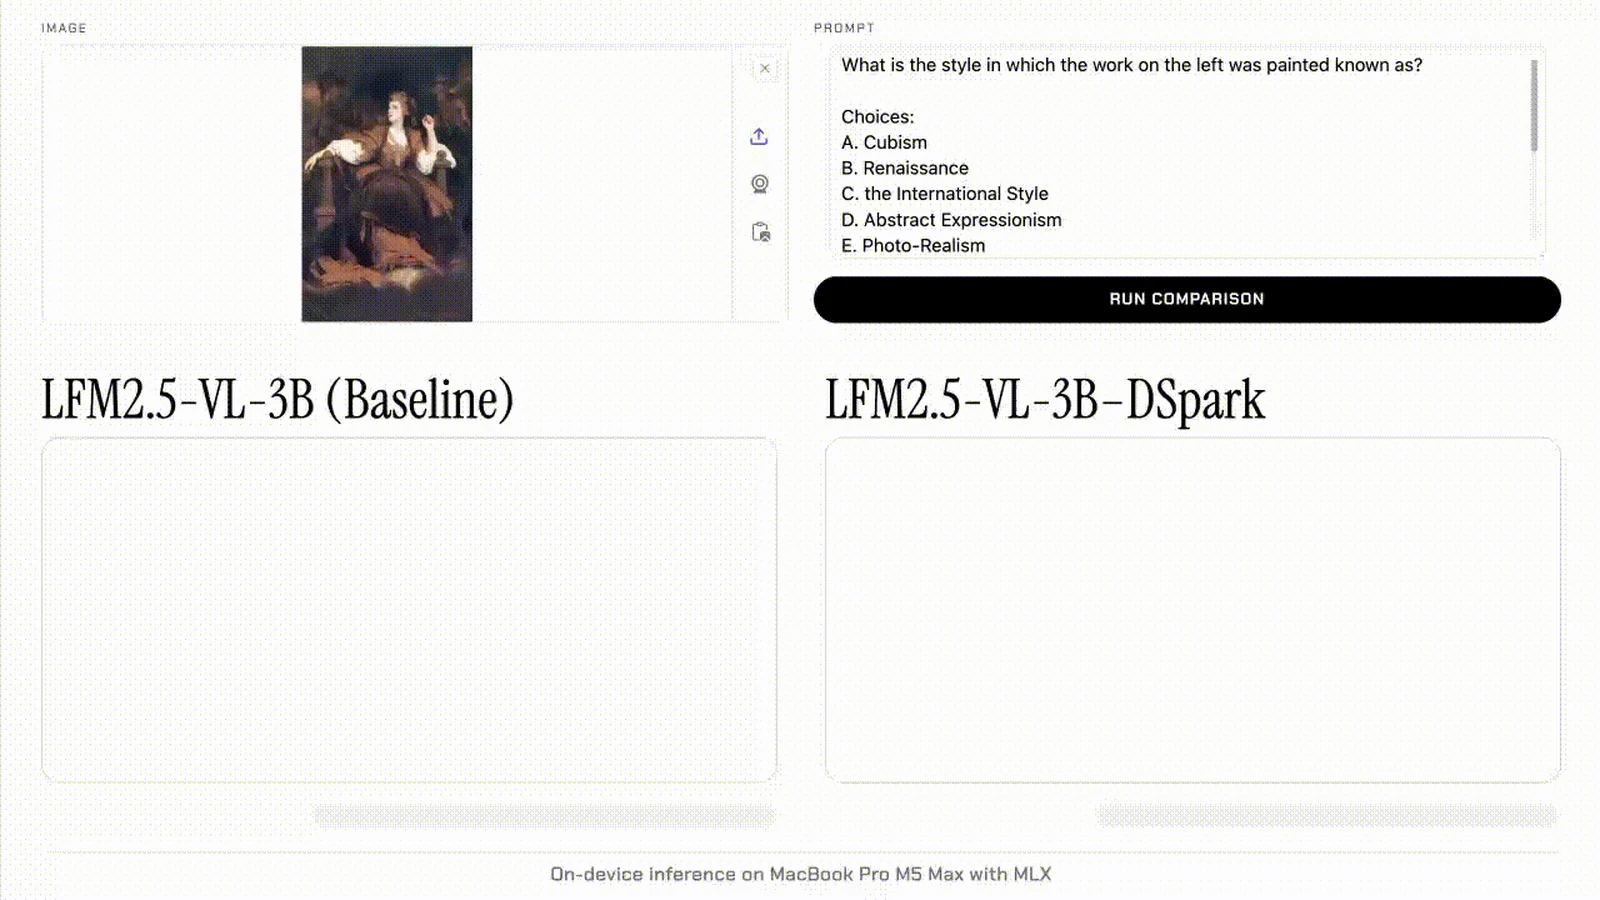
تسريع نماذج الرؤية واللغة
أعلنت المدونة الرسمية لـ Hugging Face Blog عن إصدار نموذج تجريبي يعتمد على تقنية DSpark والموجه لنموذج الرؤية واللغة LFM2.5-VL-3B. يضيف هذا النموذج مسار فك ترميز تفاؤلي يتيح زيادة طفيفة في الذاكرة مقابل تحقيق تسريع أكبر في الأداء دون إحداث أي تغيير يُذكر على جودة المخرجات النهائية للنموذج.
تعتمد التقنية الجديدة على إضافة مسار استدلال تفاؤلي مصمم خصيصاً للتعامل مع البيانات البصرية واللغوية المتكاملة. وبحسب التفاصيل التقنية، فإن بنية النموذج الجديد تتيح له التقاط الحالات المخفية للنموذج المستهدف عند طبقات محددة، مما يسهل عملية التنبؤ بكتلة من الرموز المرشحة بكفاءة عالية.
أداء الاستدلال ومكاسب السرعة
أظهرت القياسات التقنية التي أجرتها الشركة على نماذج DSpark تحسناً ملحوظاً في سرعات فك الترميز؛ حيث تراوحت سرعة فك الترميز على الأجهزة بين 2.30x و3.13x حسب طبيعة المهمة، بينما وصلت المكاسب الشاملة من البداية للنهاية إلى نطاق يتراوح بين 1.56x و2.62x عند التشغيل عبر حواسيب أبل باستخدام بيئة MLX على معالجات M5 Max.
أما على صعيد وحدات معالجة الرسومات المخصصة لمراكز البيانات، فقد سجل النموذج على شرائح H100 تحسينات في سرعة فك الترميز تتراوح بين 2.04x و2.66x، في حين بلغت التحسينات الشاملة للاستدلال ما بين 1.64x و2.27x، مما يعكس كفاءة التصميم الجديد عبر منصات الأجهزة المختلفة.
البنية التقنية واستهلاك الذاكرة
تتميز البنية المعتمدة للنموذج بكونها مبسطة وتعتمد على الانتباه فقط، وتتألف من 4 طبقات بحجم كتلة يبلغ 9 رموز. وقد صُمم المكون بحيث يتم إسقاط بقع الصور ورموز النصوص في تمثيل مشترك موحد قبل الطبقات العميقة، مما يجعله قادراً على التعامل مع متجهات الحالة المخفية بنفس الأبعاد بغض النظر عن النمط المدخل.
من الناحية المادية، يضيف النموذج المساعد نحو 280 مليون بارامتر، وهو ما يمثل زيادة طفيفة بنسبة 8.9% فقط فوق إجمالي بارامترات النموذج المستهدف البالغة 3 مليارات بارامتر، مما يحافظ على بصمة ذاكرة منخفضة نسبياً مقارنة بحجم التسريع المحقق.
التكامل والدعم الفوري للأنظمة
يحظى نموذج DSpark الجديد بدعم فوري من اليوم الأول عبر عدة أطر عمل وبرمجيات شائعة في مجتمع الذكاء الاصطناعي والمفتوح المصدر، وتشمل هذه القائمة أدوات مثل llama.cpp وMLX-VLM بالإضافة إلى إطار العمل SGLang.
تتيح هذه التكاملات للمطورين إمكانية دمج النموذج بسهولة في بيئات الإنتاج الحالية والاستفادة من آليات الاستدلال التفاؤلي عبر تمرير العلامات والأوامر البرمجية المناسبة لكل منصة، مع بقاء مخرجات النموذج دقيقة ومطابقة للاستدلال القياسي بفضل التحقق الدقيق من الرموز المقترحة.
القيود والتحديات المرتبطة بأحمال الرؤية
على الرغم من المكاسب الواضحة في سرعة فك الترميز، تشير التحليلات المتعلقة بأحمال العمل البصرية إلى وجود قيود تحكمها قوانين الأداء العامة مثل قانون أمدال. ففي نماذج الرؤية واللغة، تمر الصور أولاً عبر مُشفّر بصري، ثم يعالج المحور اللغوي مئات الرموز البصرية بالتزامن مع النصوص.
وبما أن الاستدلال التفاؤلي يعمل على تسريع مرحلة فك الترميز وحدها دون تسريع مرحلة المعالجة الأولية للصور أو التحضير، فإن الأجهزة الطرفية التي تفتقر لقدرات مراكز البيانات الضخمة قد تواجه وقتاً نسبياً أطول في الاستجابة الأولى، رغم التقدم الذي تحققه المسرعات العصبية الحديثة في تضييق الفجوة.
التوافر والإتاحة
أصبحت نماذج DSpark المخصصة للرؤية متاحة للمطورين والباحثين عبر منصة Hugging Face بصيغتي Safetensors وGGUF، مما يتيح إمكانية تنزيلها وتعديلها ونشرها دون قيود معقدة ضمن عائلة نماذج LFM2.5 المصممة لتوفير ذكاء اصطناعي يعمل بكفاءة في مختلف البيئات.
المصادر
- Hugging Face BlogAccelerating vision-language models with LFM2.5-VL-DSpark