دراسة Ai2 تكشف عدم موثوقية نماذج الذكاء الاصطناعي في تقييم حداثة الأفكار البحثية
تُظهر نتائج جديدة من معهد Allen Institute for AI أن الاعتماد على نماذج الذكاء الاصطناعي كقضاة لتمييز الأفكار البحثية الجديدة عن القديمة يواجه تحديات منهجية كبيرة.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق معيار جديد لتقييم الحداثة العلمية
أعلن معهد Allen Institute for AI (Ai2) عن إطلاق دراسة جديدة تحمل عنوان "Old Ideas, Novel Problems"، تهدف إلى قياس مدى موثوقية نماذج اللغة الكبيرة (LLMs) في تقييم حداثة الأفكار البحثية العلمية. وتأتي هذه المبادرة ضمن جهود المعهد لتطوير أنظمة ذكاء اصطناعي تدعم مراحل الاكتشاف العلمي المختلفة، بدءاً من استكشاف البيانات وصولاً إلى توليد الفرضيات واختبارها.
يشمل الإصدار الجديد ورقة بحثية، ومجموعة بيانات (Benchmark)، وأدوات برمجية مفتوحة المصدر تختبر "قضاة الحداثة"، بالإضافة إلى خط أنابيب آلي يمكن للباحثين استخدامه لبناء مجموعات تقييم جديدة. وتهدف هذه الأدوات إلى معالجة فجوة مهمة في أتمتة الاكتشاف العلمي، حيث لا يكفي توليد الأفكار فقط، بل يجب التأكد من أنها تقدم مساهمة جديدة فعلاً ولا تعيد تدوير أعمال سابقة. ويمكن الرجوع إلى DataVoyager للاطلاع على التفاصيل الأصلية للمصدر.
تحدٍ منهجي في تقييم الأفكار
يواجه الباحثون صعوبة في التحقق من صحة "قضاة الحداثة"، وهي النماذج التي تُسند إليها مهمة تقييم ما إذا كانت فكرة بحثية جديدة مقارنة بالأعمال السابقة. ولا توجد طريقة قياسية موحدة لبناء هذه القضاة، حيث يختار كل فريق نموذجاً مختلفاً، وصياغة أوامر (Prompts)، وميزانية استدلال، وأحياناً أنظمة استرجاع أدبيات. وتُظهر الدراسة أن هذه الاختيارات التقنية يمكن أن تؤثر بشكل جوهري على الحكم النهائي.
المشكلة الأساسية التي كشفتها Ai2 هي أن هذه القضاة غالباً ما تُختبر على أبحاث بشرية مكتوبة يدوياً، بينما الهدف الفعلي هو تقييم أفكار تولدها أنظمة الذكاء الاصطناعي. هذا الفارق بين بيئة الاختبار والبيئة التطبيقية يخلق شكوكاً حول مدى صلاحية هذه النماذج في الاستخدامات العملية الحقيقية.
بناء مجموعات بيانات مبنية على المراجعات
لضمان جودة التقييم، اعتمد فريق Ai2 على مراجعات الأقران لمؤتمر ICLR 2026 لبناء مجموعات بيانات موثوقة. بدلاً من اعتبار قبول الورقة دليلاً على حداثتها، قام الباحثون بتعدين المراجعات لاستخراج المقاطع التي ناقش فيها المراجعون أصالة المساهمة صراحةً. هذا التمييز مهم لأن الورقة قد تُقبل لكونها قوية تقنياً دون أن تكون جديدة، والعكس صحيح.
أُنشئت مجموعة "عالية الحداثة" تضم 154 فكرة بحثية بشرية من أوراق مقبولة ضمن أعلى 10% تقييماً في مجالها، حيث أشاد المراجعون بحداثتها دون اعتراض. وبالمقابل، أُنشئت مجموعة "منخفضة الحداثة" تضم 145 فكرة من أوراق مرفوضة ضمن أدنى 10% تقييماً، حيث أثار المراجعون مخاوف بشأن الأصالة. وأظهرت مراجعة مستقلة أن المقيمين وافقوا على إشارة الحداثة المستخرجة في 47 من أصل 50 حالة، مما يؤكد دقة المنهجية.
اختبار الأفكار البشرية مقابل المولدة آلياً
لم يقتصر التقييم على الأفكار البشرية، بل شمل أيضاً أفكاراً مولدة آلياً. تم إقران الأفكار البشرية الـ154 مع 154 فكرة أخرى تولدها نموذج لغة بسيط، بافتراض أن الأفكار المولدة أقل حداثة. لم يتلقَ المولد أدوات بحث أو تكرار، مما يجعل المقارنة حذرة وعادلة. كما خضعت 30 زوجة من هذه الأفكار لمراجعة خبير مستقل، الذي فضّل الفكرة البشرية في جميع الحالات ولم يعتبر أي فكرة مولدة جديدة.
تشير هذه النتائج إلى أن عدم الاستقرار في الأحكام لا يعتمد بالضرورة على صحة التسميات (Labels)، بل على ثبات النموذج نفسه. فعندما تعطي إعدادات تقييم معقولة إجابات متناقضة لنفس الزوج من الأفكار، فإن هذا التباين يكشف عن عدم استقرار جوهري في قدرة النموذج على التمييز.
حساسية عالية للتغييرات الطفيفة
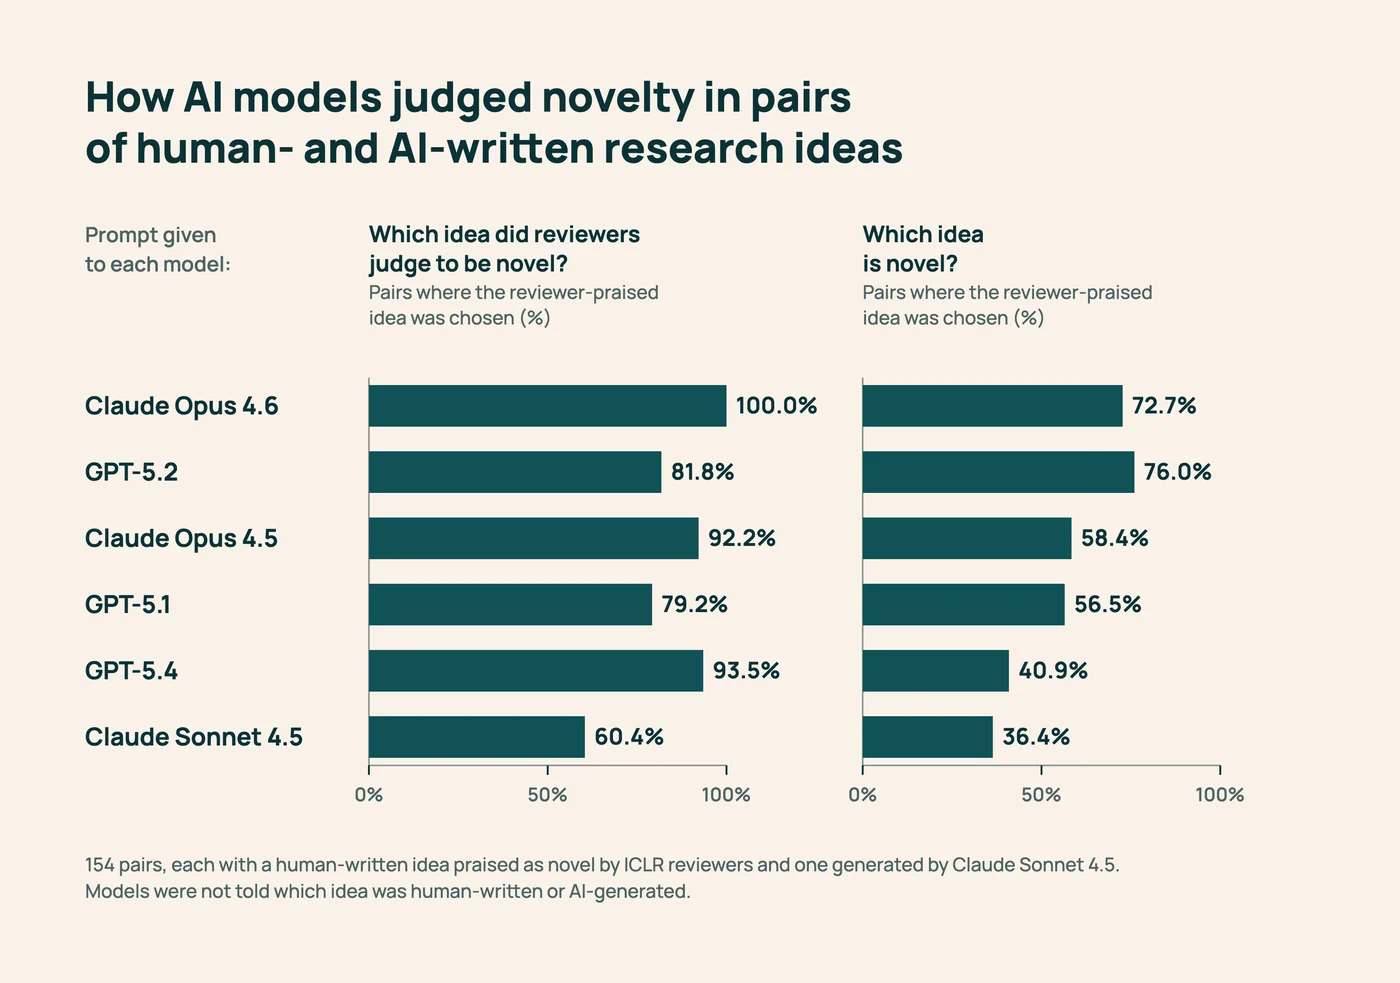
اختبر الباحثون ستة قضاة من نماذج اللغة الكبيرة، بما في ذلك إصدارات GPT-5 وClaude Sonnet وOpus، عبر تقييمات نقطية وزوجية. وكشفت النتائج أن التغييرات الصغيرة في صياغة الأوامر البرمجية (Prompting) أحدثت أكبر التغيرات في الأداء. على سبيل المثال، عند اختبار GPT-5.4 على أزواج من الأفكار، انخفضت دقة النموذج من 93.5% إلى 40.9% بمجرد تبسيط صياغة السؤال، وهو مستوى أدنى من الصدفة العشوائية.
في المقابل، كان التأثير محدوداً على مجموعة الأفكار البشرية فقط، مما يوحي بأن القضاة قد يبدون مستقرين عند التعامل مع نصوص بشرية، لكنهم يتصرفون بشكل مختلف تماماً عند مواجهة أفكار مولدة آلياً. كما لم تحسّن أنظمة الاسترجاع أو زيادة ميزانية الاستدلال من جودة الأحكام بشكل متسق.
أداء أنظمة التقييم المتخصصة
فاجأت النتائج أداء أنظمة التقييم المصممة خصيصاً لهذا الغرض، حيث أدت أسوأ من خط الأساس البسيط الذي يعتمد على نموذج Claude Opus 4.6 مع أوامر مباشرة. هذا يشير إلى أن التعقيد الإضافي في بنية التقييم لا يضمن بالضرورة دقة أعلى، بل قد يضيف ضجيجاً يعيق الحكم الصحيح.
توفر Ai2 الآن هذه الأدوات والبيانات للباحثين لدراسة هذه المشكلة بعمق. وتؤكد الدراسة أن الطريق نحو الاعتماد الكامل على الذكاء الاصطناعي في اكتشاف الأفكار الجديدة ما زال طويلاً، ويحتاج إلى طرق أكثر موثوقية للتمييز بين الابتكار الحقيقي وإعادة التغليف للأعمال القديمة.
المصادر
- Hugging Face BlogCan we trust LLMs to judge whether a research idea is novel?
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
FairStress يكشف تحيزات خفية في قرارات نماذج الذكاء الاصطناعي
أطلقت مؤسسة Ai2 معيار FairStress الجديد لقياس العدالة السكانية في نماذج اللغة الكبيرة، كاشفةً عن تحيزات خفية تظهر عند اختبار استقرار القرارات أمام الحجج المضادة.
StateBench يكشف حدود نماذج الذكاء الاصطناعي في تتبع التغيرات الطويلة
أطلقت Ai2 معيار StateBench لتقييم قدرة نماذج اللغة على تتبع حالة الكيانات في المستندات الطويلة، كاشفةً عن فجوات أداء حادة بين البنى العصبية المختلفة.
نظام LitPivot من Ai2 يعيد تشكيل تطوير الأفكار البحثية
أطلقت Ai2 نظام LitPivot الذي يربط بين تطوير الأفكار البحثية والمراجع الأدبية ديناميكياً، مما يساعد الباحثين على تحسين جودة أبحاثهم عبر تقييم دقيق للسياق.
HiRO-ACEv2 يحاكي الطقس المتطرف بدقة 3 كم بتكلفة أقل
أطلقت Ai2 نظام HiRO-ACEv2 لمحاكاة المناخ بدقة 3 كم، متفوقاً في دقة الأحداث النادرة وتقليل التكلفة بنسبة 300 مرة مقارنة بالنماذج التقليدية.