إطلاق FLUX.3 Image Klein في مكتبة Diffusers مع التحكم بالترتيب
يجمع النموذج الجديد بين توليد الصور من النص والتحرير متعدد المراجع، مع ميزة مبتكرة لتحديد مواقع العناصر بدقة.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق رسمي وميزات أساسية
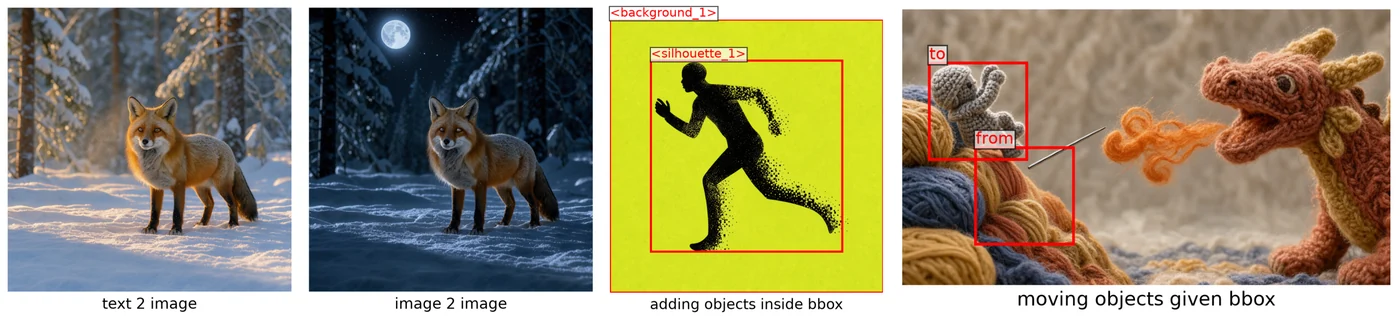
أعلنت Black Forest Labs عن توفر نموذج FLUX.3 Image Klein رسمياً ضمن مكتبة Diffusers، مما يتيح للمطورين والمبدعين الوصول الفوري إلى قدرات توليد الصور المتقدمة. يميز هذا الإصدار دمج ثلاث وظائف رئيسية في نموذج واحد: التوليد من النص، والتحرير متعدد المراجع، وميزة جديدة كلياً تسمى "التحكم بالتخطيط" (Layout Control). تسمح هذه الميزة للمستخدمين بكتابة إحداثيات صناديق محددة داخل الأمر النصي (Prompt) لتحديد موقع كل عنصر في الصورة النهائية، أو لتحديد الأجزاء التي يجب نقلها من صورة مرجعية إلى أخرى. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
تتوفر نقاط التحقق المفتوحة (Open Checkpoints) ضمن مجموعة خاصة على منصة Hugging Face، مما يسهل الوصول إليها وتحميلها. كما يمكن للمستخدمين تجربة النموذج مباشرة عبر مساحة Hugging Face التفاعلية لتوليد صور فورية دون الحاجة إلى إعداد بيئة تطوير معقدة.
الأداء التقني وسرعة المعالجة
يتميز النموذج الموزون (Distilled Checkpoint) بسرعة معالجة استثنائية، حيث يستغرق توليد صورة بدقة 1024 × 1024 حوالي ثانيتين فقط على بطاقة NVIDIA H100. يعتمد هذا الأداء على 16 خطوة استنتاجية افتراضياً، مع إمكانية تعديل الارتفاع، العرض، وعدد الخطوات عبر معاملات محددة. توفر هذه السرعة مرونة عالية في التطبيقات التي تتطلب استجابة فورية أو معالجة دفعات كبيرة من الصور.
لتسهيل التشغيل على أجهزة الرسوميات (GPUs) ذات الذاكرة المحدودة، يدعم النموذج تحميل الأوزان المكممة بصيغتي NVFP4 وFP8 باستخدام الدالة from_single_file. هذا يتيح للمطورين الاستفادة من قدرات النموذج المتقدم دون الحاجة إلى بنية تحتية باهظة التكلفة، مما يوسع نطاق الوصول إلى تقنيات الذكاء الاصطناعي التوليدي.
آلية التحكم بالتخطيط والإحداثيات
تعتمد ميزة التحكم بالتخطيط على إدخال قائمة JSON تحتوي على مناطق محددة بعد الوصف النصي. كل منطقة تتضمن معرّفاً (id)، وصندوق إحداثيات (bbox)، ووصفاً (desc). تُكتب الإحداثيات على مقياس من 0 إلى 1000، مع وضع محور Y أولاً، مما يجعل الصناديق قابلة للتطبيع والعمل بدقة على أي حجم صورة. هذا النظام يوفر دقة عالية في تحديد مواقع العناصر دون الحاجة إلى أدوات تحرير خارجية.
في عمليات التحرير، يحدد كل منطقة مصدر المحتوى (src_bbox) من الصورة المرجعية والموقع المستهدف (tgt_bbox) في الصورة الناتجة. إذا تطابق الصندوقان، يبقى العنصر في مكانه الأصلي. يتيح هذا النظام سيناريوهات تحرير متقدمة، مثل نقل عنصر معين إلى موقع جديد مع تثبيت الخلفية والعناصر الأخرى، مما يوفر تحكماً دقيقاً غير مسبوق في عمليات توليد الصور.
البنية المعمارية للنموذج
يعمل FLUX.3 كنموذج تدفق في الفضاء الكامن (Latent-space flow model)، حيث يستقبل المدخلات الكامنة وينتج مخرجات كامنة يتم فك تشفيرها لاحقاً إلى بكسلات باستخدام VAE. يستخدم النموذج نفس بنية VAE من الإصدار السابق Flux.2، والذي يضغط الصورة بنسبة 8x في كل اتجاه إلى 32 قناة، ثم يجمع كل بقعة 2x2 في رمز واحد يحتوي على 128 قناة. وبالتالي، يغطي الرمز الواحد بقعة بكسلات 16x16، وتتحول صورة 1024x1024 إلى شبكة من 4096 رمزاً.
يعتمد النموذج على مشفر النصوص Qwen3-VL، وهو نموذج لغوي بصري. بدلاً من استخدام الطبقة الأخيرة فقط، يقرأ FLUX.3 الحالات المخفية من ثماني طبقات محددة (4، 8، ...، 32) من أصل 36 طبقة، ويجمعها لتكوين متجه ذي أبعاد 20,480 لكل رمز نصي، قبل إسقاطه خطياً إلى عرض محول FLUX.3 البالغ 3072. هذا النهج يوفر للمحول ميزات من أعماق متعددة لنموذج اللغة، مما يعزز فهم السياق البصري والنصي.
معالجة الرموز والمراحل
يمر المعالج (Transformer) بالرموز في مرحلتين رئيسيتين. في المرحلة الأولى، تمر كل تدفقات (النص، الصورة الضجيجية، الصور المرجعية) عبر 5 كتل ذات أوزان مستقلة، حيث ينتبه كل تدفق لنفسه فقط. في المرحلة الثانية، يتم دمج التدفقات في تسلسل واحد يمر عبر 28 كتل مشتركة الأوزان، حيث يمكن لكل عنصر الانتباه إلى الآخرين. هذا التصميم يسمح بتكرير كل نوع من الرموز بشكل مستقل أولاً، ثم دمجها لتعلم التفاعلات بين النص والصورة والمرجعيات.
على عكس FLUX.2 الذي سمح للنص والصورة بالانتباه لبعضهما من البداية، يفصل FLUX.3 التدفقات تماماً في البداية ثم يدمجها. في النهاية، يتم إسقاط رموز النص والمرجعيات، ولا تمر رموز الصورة فقط عبر طبقة الإخراج النهائية. هذا الهيكل يحسن كفاءة المعالجة ويقلل من التداخل غير المرغوب فيه بين أنواع البيانات المختلفة.
التخصيص وتدريب LoRA
نظراً لأن FLUX.3 يدعم كل من التوليد من النص والتحرير من صورة إلى صورة، فهو قاعدة مثالية لتدريب نماذج LoRA مخصصة. توفر مكتبة Diffusers سكريبتات تدريب DreamBooth LoRA لكلا المهمتين. على سبيل المثال، يمكن تدريب النموذج على أسلوب بطاقات التاروت باستخدام مجموعة بيانات عامة، مع تفعيل التدريب عبر كلمة محفزة محددة. كما يمكن استخدام أدوات خارجية مثل Ostris' AI Toolkit للتدريب.
لتقليل استهلاك الذاكرة أثناء التدريب، توفر السكريبتات أعلاماً تحسينية مثل --gradient_checkpointing لإعادة حساب التفعيلات، و--cache_latents لتشفير الصور مسبقاً، و--use_8bit_adam للحفاظ على حالات المُحسِّن بدقة 8 بت. كما يمكن تجربة رتب LoRA مختلفة ومُحسِّنات متنوعة للحصول على أفضل النتائج، مع توثيق شامل للخيارات في دليل DreamBooth FLUX.3.
المصادر
- Hugging Face BlogWelcome FLUX.3 Image Klein in Diffusers
تابع التسلسل الزمني
أخبار مرتبطة
Hugging Face تطلق TorchTPU لتشغيل نماذج الذكاء الاصطناعي على TPU
أعلنت Hugging Face عن دعم TorchTPU، مما يتيح تشغيل نماذج Transformers وDiffusers على وحدات معالجة TPU من Google بشكل أصلي وسريع.
TorchNeuron يسهّل تشغيل نماذج Hugging Face على AWS Trainium
أطلقت Hugging Face وAWS تقنية TorchNeuron لتوفير واجهة برمجية أصلية لنماذج الذكاء الاصطناعي على معالجات Trainium، مما يرفع نسبة دعم البنى المعمارية ويحسّن كفاءة التدريب والاستدلال.
إطلاق نموذج LFM2.5-24B-A2B للوكلاء الأذكياء على الأجهزة
أعلنت المدونة الرسمية لـ Hugging Face عن إطلاق نموذج LFM2.5-24B-A2B المخصص لتشغيل وكلاء الذكاء الاصطناعي السريعين والخاصين على الأجهزة المحلية بكفاءة عالية.
إطلاق نموذج AstaBrief المفتوح لتوليد التقارير العلمية
أعلنت منصة Asta عن إطلاق نموذج AstaBrief 8B المفتوح لتوليد التقارير العلمية بسرعة وكفاءة، مما يتيح للباحثين تشغيله محلياً عبر البنية التحتية الخاصة بهم.