إطلاق نموذج LFM2.5-24B-A2B للوكلاء الأذكياء على الأجهزة
أصدرت مدونة Hugging Face تفاصيل نموذج الاستدلال الجديد LFM2.5-24B-A2B الذي يوفر قدرات متقدمة لاستخدام الأدوات وتنفيذ المهام المعقدة بكفاءة عالية واستهلاك منخفض للموارد.
 رضوان عبدالهاديمحرر وكاتب تقني
مواصفات نموذج LFM2.5-24B-A2B وقدرات الاستدلال
كشفت المدونة الرسمية لـ Hugging Face عن إطلاق نموذج LFM2.5-24B-A2B، وهو نموذج استدلال متطور يضم 24 مليار معلمة إجمالية مع وجود ملياري معلمة نشطة فقط لكل رمز، مما يجعله مثالياً لتشغيل الوكلاء الأذكياء والخاصين مباشرة على الأجهزة المحلية. ويعتمد هذا النموذج على معمارية هجينة تجمع بين الالتفافات القصيرة البوابية وآلية GQA، مع توسيع نافذة السياق من 32 ألف رمز إلى 131 ألف رمز، ومضاعفة حجم مفردات المصطلحات لتصل إلى 128 ألف رمز لتعزيز معالجة اللغات غير اللاتينية بفعالية. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
مراحل التدريب والتعلم المعزز للوكلاء
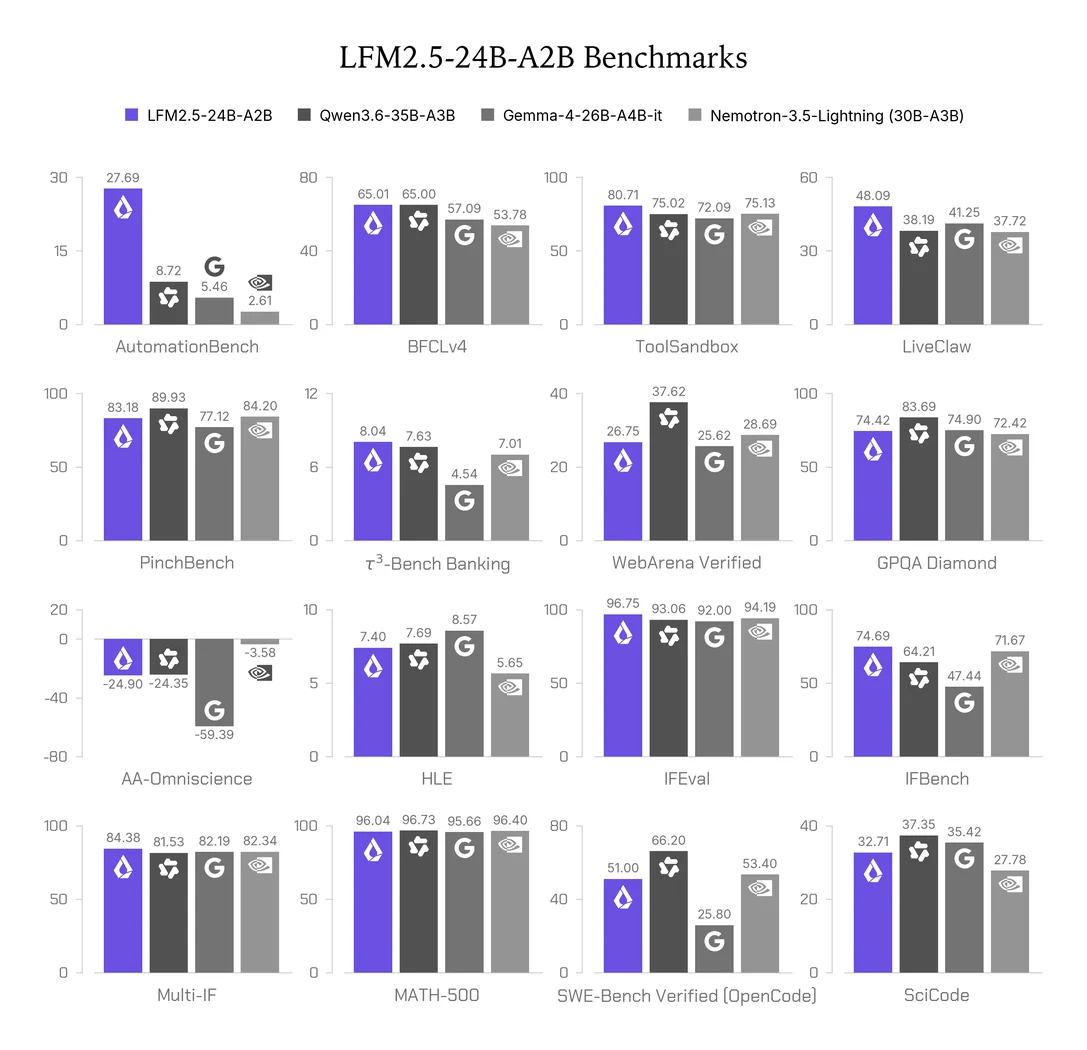
مرّ تطوير النموذج بعمليات تدريب مكثفة شملت توسيع مرحلة التدريب المسبق لتصل إلى نحو 33 تريليون رمز، تلتها مرحلة تدريب متوسط بملياري رمز لبيانات السياق البالغ طولها 32 ألف رمز مع التركيز على الاستدلال والرياضيات والبرمجة، و300 مليار رمز لبيانات السياق الطويل. وبعد ذلك، تم تحويل النموذج الأساسي إلى وكيل ذكي عبر خمس مراحل تضمنت التقطير الموجه للسياسات متعددة المجالات والتعلم المعزز للوكلاء داخل بيئات العمل المختلفة مثل OpenClaw وHermes Agent. ويمكن الرجوع إلى Back to Articles للاطلاع على التفاصيل الأصلية للمصدر.
الأداء المتميز في اختبارات المعايير والوكلاء
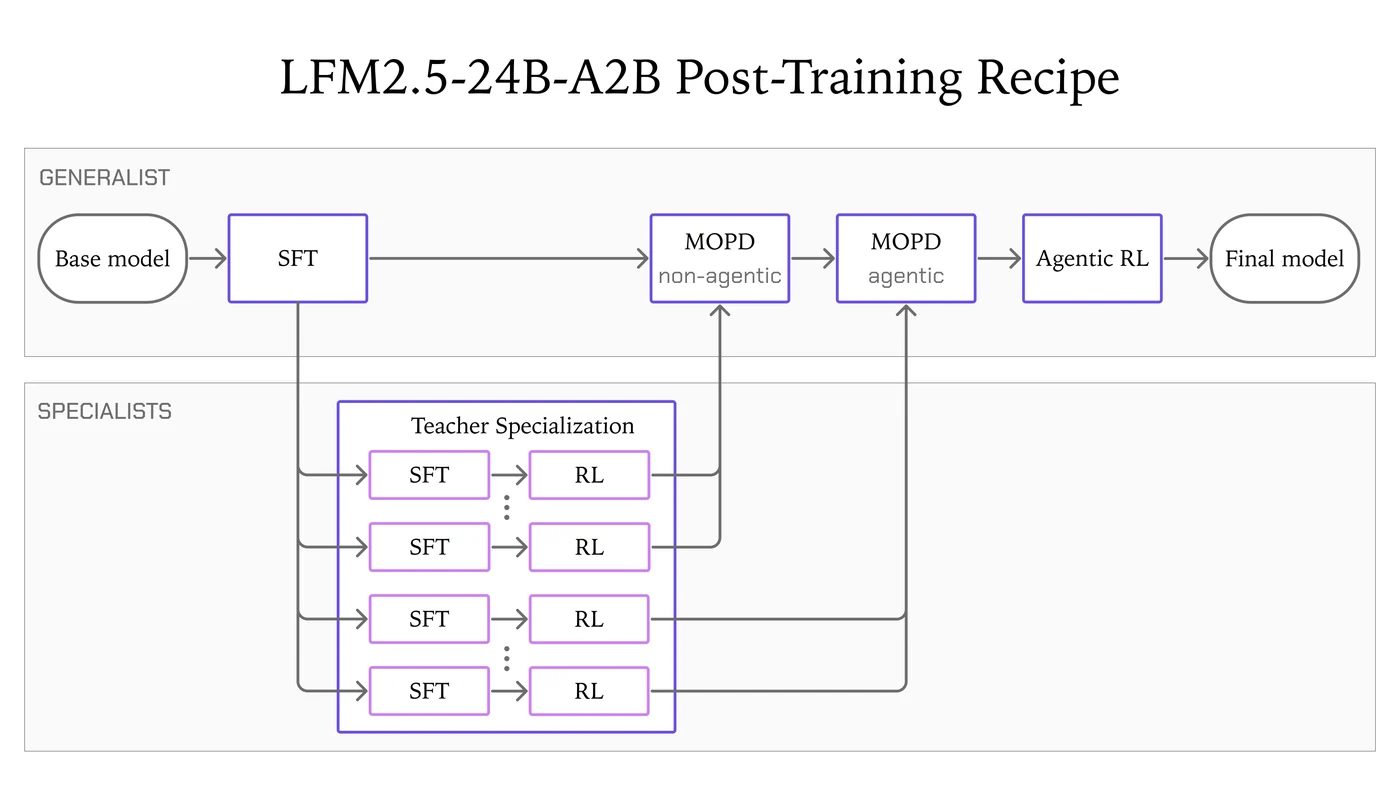
أظهرت تقييمات الأداء تفوق نموذج LFM2.5-24B-A2B أو مطابقتها لنظيراتها من النماذج الأكبر حجماً في مهام استخدام الأدوات وسير العمل للوكلاء، حيث تصدر النتائج في معايير رئيسية مثل AutomationBench وBFCLv4 وToolSandbox وLiveClaw. وعلى الرغم من تفوق النماذج الأكبر في المهام المعرفية الكثيفة والبرمجة المتقدمة، إلا أن هذا النموذج يمثل قاعدة صلبة وموثوقة لتشغيل الوكلاء بكفاءة عالية على الأجهزة الشخصية.
السرعة العالية وكفاءة الاستنتاج على الأجهزة الطرفية
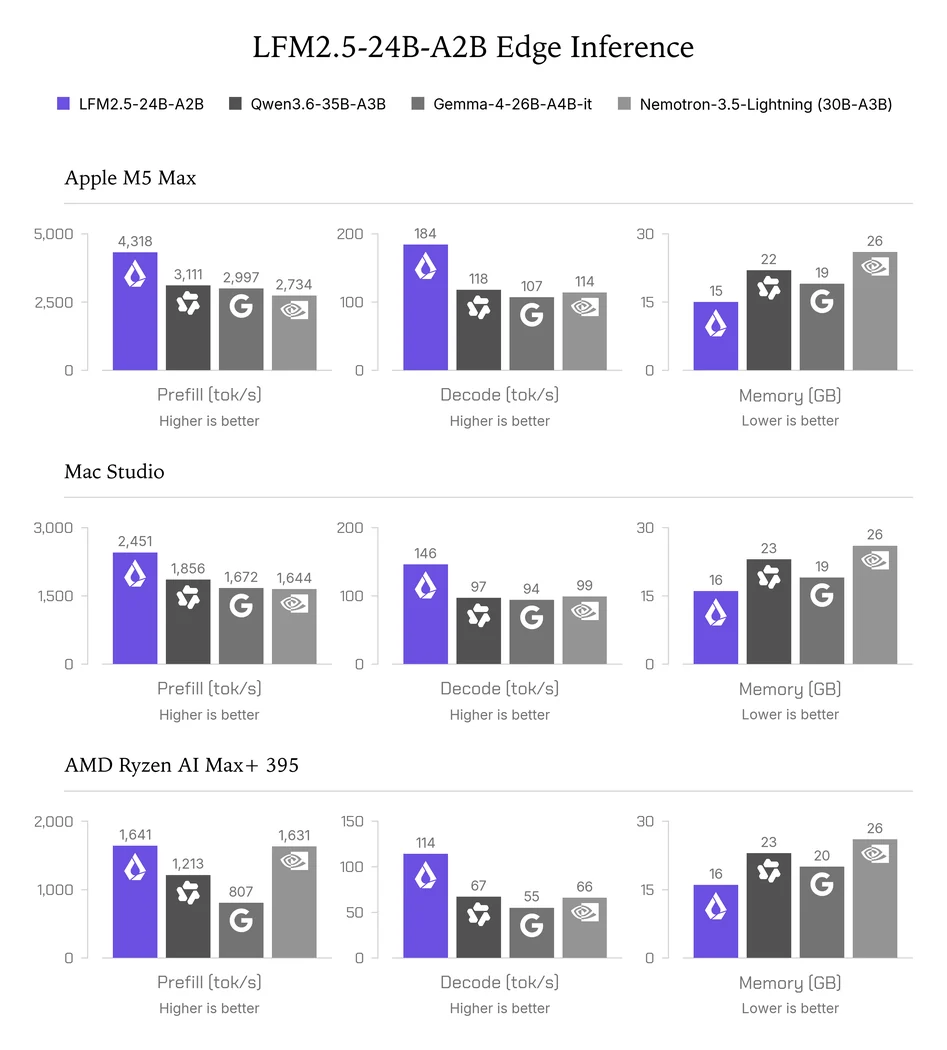
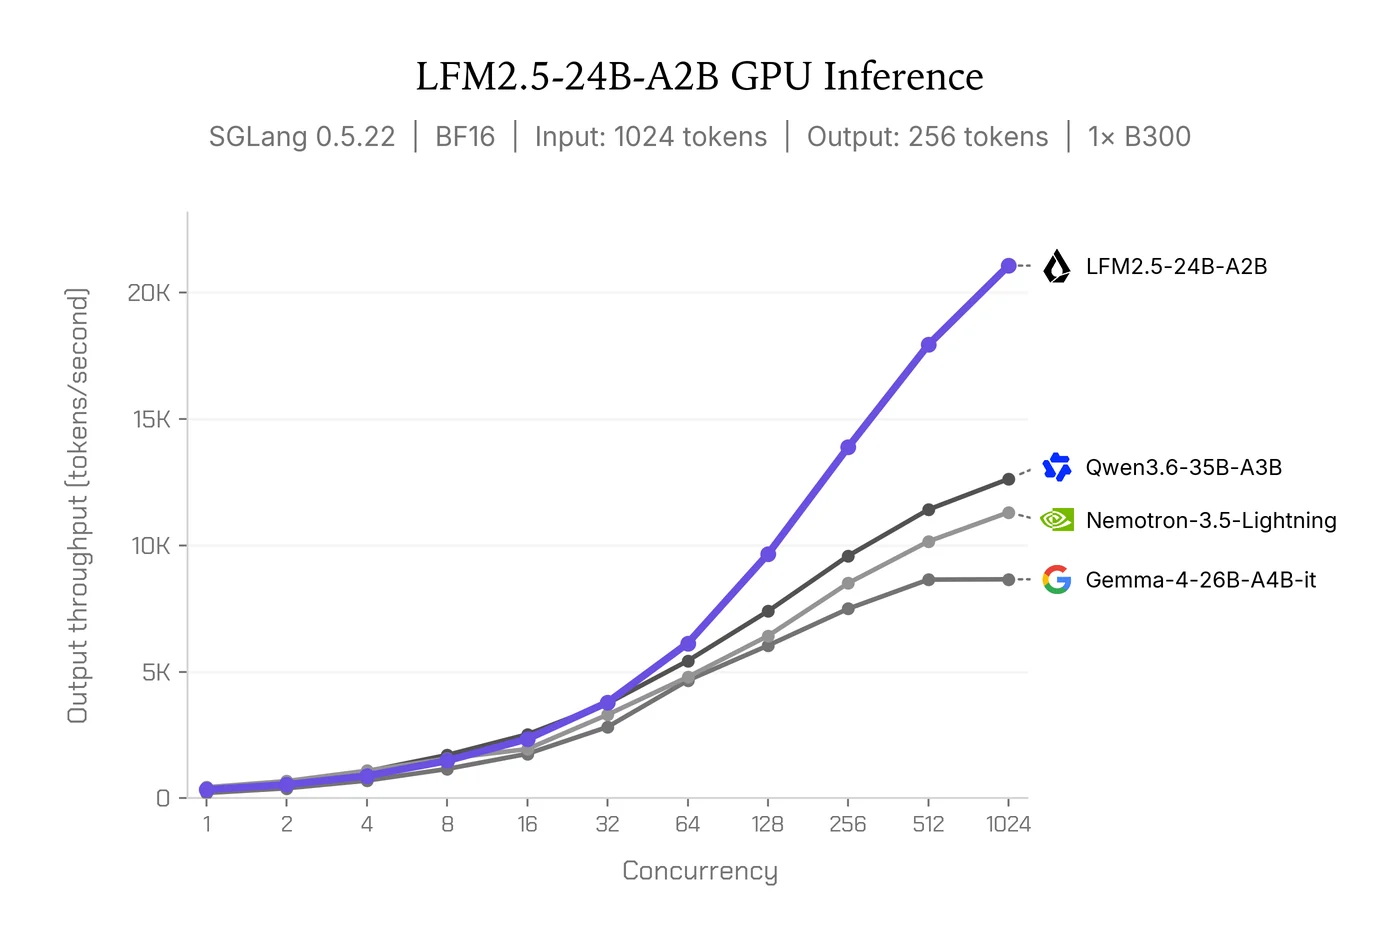
يوفر النموذج سرعات فائقة في فك رموز النصوص، حيث يصل معدل المعالجة إلى 184 رمزاً في الثانية على شريحة Apple M5 Max و114 رمزاً في الثانية على معالجات Ryzen AI Max+ 395، وهو ما يمثل سرعة أكبر بنسبة تصل إلى 1.7 مرة مقارنة بأفضل النماذج المنافسة مع استخدام أقل للذاكرة. كما يحقق النموذج أداءً استثنائياً على وحدات معالجة الرسومات الكبيرة للشركات بمعدلات تتجاوز 21 ألف رمز خرج في الثانية الواحدة.
التوفر والتكامل مع بيئات التشغيل المختلفة
يتوفر كل من نموذج LFM2.5-24B-A2B والنسخة الأساسية الخاصة به للجمهور كأوزان مفتوحة عبر منصة Hugging Face مع دعم شامل وجاهز للاستخدام منذ اليوم الأول في مختلف بيئات الاستنتاج مثل llama.cpp وMLX وvLLM وSGLang وONNX. ويمكن للمطورين دمج النموذج بسهولة خلف أي واجهة متوافقة مع معايير OpenAI لتشغيل الوكلاء المحليين وتخصيصهم حسب الحاجة.
المصادر
- Hugging Face BlogRun fast, private agents on-device with LFM2.5-24B-A2B
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
إنفيديا تطلق نموذج Kumo Tabular المفتوح للبيانات الجدولية
أطلقت إنفيديا نموذج Kumo Tabular المفتوح المصدر للبيانات الجدولية، متصدراً أربعة معايير رئيسية بدقة وكفاءة عالية دون الحاجة إلى تدريب مسبق أو هندسة ميزات معقدة.
إطلاق FLUX.3 Image Klein في مكتبة Diffusers مع التحكم بالترتيب
أطلقت Black Forest Labs نموذج FLUX.3 Image Klein ضمن Diffusers، مدعوماً بتحكم دقيق في الترتيب عبر صناديق الإحداثيات، وأداء سريع على GPUs.
إطلاق نموذج AstaBrief المفتوح لتوليد التقارير العلمية
أعلنت منصة Asta عن إطلاق نموذج AstaBrief 8B المفتوح لتوليد التقارير العلمية بسرعة وكفاءة، مما يتيح للباحثين تشغيله محلياً عبر البنية التحتية الخاصة بهم.
إطلاق لوحة صدارة تحويل النص إلى كلام وتقنيات الاستنساخ الصوتي
تعرف على Open TTS Leaderboard الجديدة لتقييم نماذج تحويل النص إلى كلام واستنساخ الأصوات بلغات متعددة عبر معايير موضوعية سريعة.