TorchNeuron يسهّل تشغيل نماذج Hugging Face على AWS Trainium
تتيح أداة TorchNeuron الجديدة دمج معالجات AWS Trainium بشكل أصلي مع مكتبات PyTorch، مما يلغي الحاجة إلى طبقات وسيطة معقدة ويوفر تجربة تطوير موحدة.
 رضوان عبدالهاديمحرر وكاتب تقني
نقلة نوعية في التكامل مع AWS Trainium
أعلنت Hugging Face عن إطلاق TorchNeuron، وهي إضافة برمجية (Plugin) جديدة لمنصة PyTorch توفر واجهة برمجية أصلية لمعالجات AWS Trainium. تهدف هذه الخطوة إلى تبسيط عملية تشغيل نماذج الذكاء الاصطناعي على هذه المعالجات المتخصصة، والتي صُممت خصيصاً للتدريب والاستدلال بكفاءة عالية وتكلفة منخفضة. تتيح الأداة الجديدة للمطورين التعامل مع أجهزة Neuron كأي جهاز تسريع آخر، مما يقلل من التعقيد التقني المرتبط سابقاً ببيئة التطوير.
الانتقال من Optimum Neuron إلى التنفيذ الأصلي
حتى الآن، اعتمدت تجربة Hugging Face على معالجات Trainium وInferentia على مكتبة Optimum Neuron، والتي كانت تعتمد بدورها على حزمة torch-neuronx المبنية على PyTorch XLA. على الرغم من كونها خياراً منطقياً في وقتها، إلا أنها فرضت على المطورين التفكير بأسلوب المبرمج (Compiler)، مما تطلب استخدام تينسورات كسولة (Lazy Tensors) بدلاً من التنفيذ الفوري، والالتزام بأشكال ثابتة فقط، وإعادة تجميع الكود عند كل انقطاع في المخطط. كانت Optimum Neuron موجودة لإخفاء هذا التعقيد، لكنها كانت تتطلب صيانة أكواد مخصصة مثل فئات النموذج والمدربين. ويمكن الرجوع إلى blog للاطلاع على التفاصيل الأصلية للمصدر.
تغير TorchNeuron هذا المشهد جذرياً من خلال التكامل المباشر مع PyTorch، حيث تعرض neuron كجهاز أصلي يدعم التنفيذ الفوري، وأدوات التوزيع الأصلية الخاصة بـ PyTorch مثل DTensor وFSDP2، بالإضافة إلى دعم torch.compile. هذا التحول يجعل من Trainium جهازاً عادياً من منظور مكتبات Hugging Face، مما يسمح بتشغيل مكتبات Transformers وDiffusers وAccelerate وPEFT وTRL مباشرةً باستخدام نفس الفئات والسكربتات المستخدمة على أي معالج تسريع آخر.
تحسن كبير في دعم بنى النماذج
أصبح توليد النص مدعوماً بشكل أصلي في مكتبة Transformers لمجموعة واسعة من النماذج. بفضل TorchNeuron، يتم دعم 89% من أكثر 100 بنية معمارية لنماذج توليد النص استخداماً بشكل جاهز، مقارنةً بنسبة 46% فقط في إصدار Optimum Neuron v0.4.5. يتطلب تفعيل هذا الدعم مجرد تمرير معامل device_map=neuron في الكود، مما يؤدي تلقائياً إلى نقل النموذج إلى أجهزة Neuron دون الحاجة إلى إعدادات إضافية معقدة.
توفر الأداة أيضاً دعماً للتوازي الشبكي (Tensor Parallelism)، مما يتيح الاستفادة الكاملة من قدرات أجهزة Neuron. يوصى بشدة باستخدام ذاكرة مؤقتة ثابتة (Static Cache) للتوليد لمنع إعادة التجميع المتكررة، وهو ما يعزز كفاءة الأداء على هذه الأجهزة المتخصصة.
تدريب موحّد عبر مكتبات Hugging Face
بما أن Neuron أصبح جهازاً أصلياً في PyTorch، أصبح التدريب على Trainium يستخدم نفس مكتبات Hugging Face المستخدمة على أي معالج تسريع آخر، مثل Transformers وAccelerate وPEFT وTRL. لم يعد هناك حاجة إلى مدرب مخصص أو نسخة معدلة من كود النموذج الخاصة بـ Neuron. يمكن الآن تشغيل سكربتات الضبط الدقيق (Fine-tuning) القياسية المبنية على TRL SFTTrainer على أجهزة Trainium مع إجراء بعض الإعدادات المحددة فقط.
يتم التعامل مع التوازي بشكل أصلي من خلال مكتبة Transformers. يضع المطور إعدادات التوازي الشبكي (TP) وحجم FSDP في model_init_kwargs، ثم يمررها SFTTrainer إلى دالة from_pretrained، مما يؤدي إلى تقسيم النموذج أثناء تحميل أوزانه. يرى المدرب (Trainer) أن النموذج موزع بالفعل ولا يعيد تغليفه، مما يلغي الحاجة إلى أعلام مثل --fsdp أو إعدادات FSDP في Accelerate.
إعدادات تقنية للتشغيل الأمثل
على الرغم من أن الكود لا يرتبط حصرياً بـ Trainium، إلا أن هناك اعتبارات تقنية مهمة عند تشغيله على هذه الأجهزة. أولاً، الأشكال الثابتة: يعطل السكربت الأشكال الديناميكية التلقائية في torch.compile ويستخدم التغليف الملتف (Wrapped Packing) لإنتاج تسلسلات تصل إلى 2048 توكن. مع إصدارات TRL 1.16 وما بعدها، يتم ملء الدفعات (Batches) على Neuron إلى مضاعفات 128 توكن، مما يحد من عدد أشكال المدخلات ويعيد استخدام المخططات المبرمجة للخطوات اللاحقة ذات الأشكال المتطابقة.
ثانياً، تفعيل torch.compile: يكفي تمرير --torch_compile true، حيث يكتشف torch.compile الجهاز تلقائياً على أجهزة Trainium ويختار خلفية Neuron دون الحاجة إلى تكوين إضافي. ثالثاً، تعطيل التحميل غير المتزامن للأوزان: نظراً لعدم دعم التحميل غير المتزامن المدمج في Transformers على Neuron حالياً، يتم تعطيله باستخدام المتغير البيئي HF_DEACTIVATE_ASYNC_LOAD=1.
دعم مكتبة Diffusers والنوى المخصصة
تتوافق العديد من خطوط الأنابيب (Pipelines) في مكتبة Diffusers مع TorchNeuron في وضعي التنفيذ الفوري والمبرمج. تشمل النماذج المتوافقة مع التوازي الشبكي (Tensor Parallelism) نماذج FLUX.1-dev وFLUX.2 وQwen-Image وQwen-Image-2.1 وH3، مما يسمح بالاستفادة القصوى من أجهزة Neuron. يمكن للمطورين إضافة الدعم لخطوط الأنابيب الأخرى من خلال اتباع الدليل الرسمي، مع توقع زيادة عدد الخطوط المتوافقة مستقبلاً.
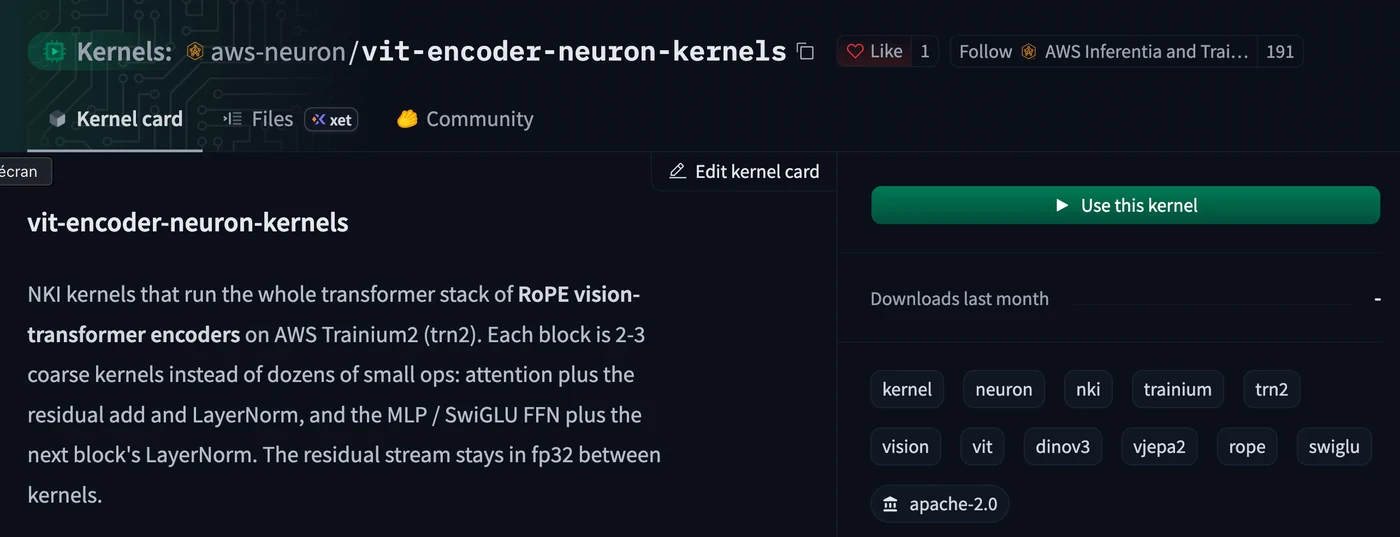
تشجع Hugging Face المستخدمين على استكشاف النوى (Kernels) التي طورتها فريق Neuron، حيث ستصبح المزيد من النوى متاحة على Hugging Face Hub لتسريع النماذج. يمكن كتابة نوى Neuron باستخدام واجهة Neuron Kernel Interface (NKI)، مما يمنح تحكماً أدق في تحسين العمليات. على سبيل المثال، يمكن استخدام نوى مخصصة لتسريع محولات الرؤية (Vision Transformers) بمعدل يصل إلى 2.4 مرة على Trainium، مما يتيح للمستخدمين تشغيل عمليات مخصصة ومشاركتها على المنصة.
الإتاحة العامة والتعاون مع AWS
ستصبح TorchNeuron متاحة كإصدار تجريبي عام (Public Beta) اعتباراً من 20 أكتوبر 2026. سيتمكن الباحثون والمطورون من تثبيتها بسهولة باستخدام أمر pip install torch-neuronx. وتقدم Hugging Face شكرها الخاص لفريق AWS على عملهم في تطوير TorchNeuron، وعلى استجابتهم السريعة للملاحظات لضمان أفضل تكامل ممكن مع مكتبات Hugging Face، مما يعزز التزام الطرفين بتقدم الذكاء الاصطناعي وتعميمه عبر المصادر المفتوحة.
المصادر
- Hugging Face BlogTorchNeuron: running HF models on AWS Trainium is easier than ever
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
Hugging Face تطلق TorchTPU لتشغيل نماذج الذكاء الاصطناعي على TPU
أعلنت Hugging Face عن دعم TorchTPU، مما يتيح تشغيل نماذج Transformers وDiffusers على وحدات معالجة TPU من Google بشكل أصلي وسريع.
تدريب نموذج Qwen3 على منصة AWS Trainium باستخدام torchtitan
تعرف على كيفية تدريب نموذج Qwen3 على منصة AWS Trainium بثلاث طرق مختلفة باستخدام مكتبة torchtitan ومحرك TorchNeuron المتطور.
أداة جديدة لمعرفة توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium
تتيح مساحة تفاعلية جديدة على منصة Hugging Face للباحثين والمطورين التحقق بسهولة من توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium.
جوجل تنضم لأمزون في تحدٍّ جديد لسيطرة إنفيديا على الذكاء الاصطناعي
أطلقت جوجل مشروع TorchTPU مفتوح المصدر لتسهيل نقل تطبيقات PyTorch إلى شرائح TPU الخاصة بها، في خطوة تنافسية مباشرة مع أمزون لكسر احتكار إنفيديا.