Hugging Face تطلق TorchTPU لتشغيل نماذج الذكاء الاصطناعي على TPU
تتيح Hugging Face الآن للمستخدمين تشغيل نماذج الذكاء الاصطناعي على وحدات معالجة TPU من Google بشكل أصلي عبر TorchTPU، مما يزيل الحاجة إلى أدوات وسيطة.
 رضوان عبدالهاديمحرر وكاتب تقني
تسهيل الوصول إلى TPU في PyTorch
لطالما واجه مطورو PyTorch صعوبات في تشغيل نماذجهم على وحدات معالجة TPU، حيث كان عليهم إما نقل أكوادهم إلى torch_xla أو تعلم إطار عمل JAX. ومع إطلاق TorchTPU، أصبحت TPU مجرد جهاز آخر يمكن التعامل معه بسهولة داخل بيئة PyTorch. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
وحدات معالجة TPU هي معالجات ذكاء اصطناعي من تصميم Google، مخصصة لتنفيذ العمليات الحسابية المصفوفية التي تستهلك معظم وقت الشبكات العصبية. وقد صممت Google هذه الرقائق على مدى العقد الماضي لتدريب وتقديم نماذجها الخاصة، بما في ذلك Gemini.
إزالة الحاجة إلى Optimum TPU
كانت المشكلة الرئيسية دائماً في البرمجيات، حيث نمت بنية TPU حول TensorFlow وJAX، مما جعل الأمر أكثر صعوبة على مستخدمي PyTorch. كانت الطريقة السابقة تعتمد على PyTorch/XLA، والتي كانت تعاني من مشاكل مثل الكسل في المعالجة وإعادة تجميع الرسوم البيانية.
لجعل الأمور أسهل، طورت Hugging Face أداة Optimum TPU لدعم الاستدلال والتدريب على TPU. ومع دعم TorchTPU الأصلي، لم تعد أداة Optimum TPU مطلوبة لتشغيل نماذج Hugging Face باستخدام Transformers وDiffusers.
تحميل النماذج على TPU
تم بناء Transformers v5 حول فكرة أن تكون مصدر الحقيقة لتعريفات النماذج، مما يتيح تشغيلها في أي مكان. الآن يشمل "أي مكان" وحدات TPU. لتحميل نموذج على TPU، يكفي تمرير device_map="tpu".
يعمل النموذج في وضع eager افتراضياً، ولكن يمكن استخدام torch.compile للحصول على أداء أفضل، أو تشغيله في إعداد موزع. هذا يجعل العملية بسيطة ومباشرة للمستخدمين.
دعم Diffusers على TPU
أصبح TPU جهازاً من الدرجة الأولى في Diffusers. للنماذج الأولية أو تصحيح الأخطاء، يكفي وضع eager مع pipe.to("tpu"). للنشر، يضيف وضع compiled استدعاء compile واحد. تبقى خطوط الأنابيب والأكواد كما هي، دون الحاجة إلى فرع TPU منفصل.
عندما يكون النموذج كبيراً جداً ليلائم رقاقة واحدة، يمكن تمرير TensorParallelConfig إلى from_pretrained، مما يقسم التحويل عبر الرقائق أثناء التحميل، فلا يحتاج النموذج الكامل إلى أن يتسع في مكان واحد.
تحسين الأداء عبر Kernels
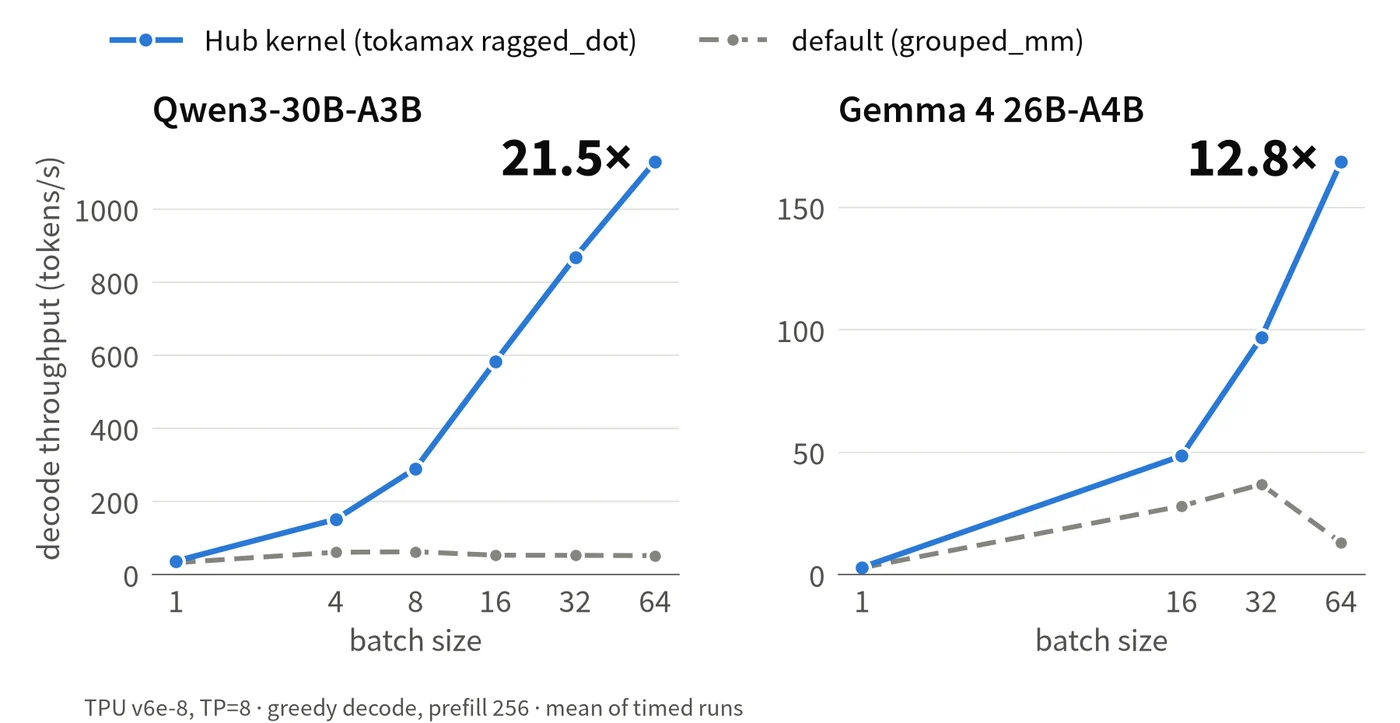
توفر مكتبة Kernels نواة TPU جاهزة للاستخدام. يمكن تحميل نواة واحدة باستخدام مكتبة Kernels ومنح النموذج دفعة في السرعة. تُكتب نواة TPU بلغة Pallas، مما يمنح تحكماً منخفض المستوى في العتاد.
كلما زاد حجم الدفعة، زاد الفوز. عند حجم دفعة 64، يكون فك الترميز أسرع بـ 21.5 مرة على Qwen3-30B-A3B وأسرع بـ 12.8 مرة على Gemma 4 26B-A4B.
اختبارات CI وتحسين مستمر
تعمل Hugging Face باستمرار على تحسين دعم TPU في transformers من خلال تشغيل مجموعة اختبارات المكتبة. يتم العمل على إضافة CI ليلية على TPU وجعل النتائج متاحة في لوحة معلومات transformers.
من الاختبارات التي تعمل على TPU، تمر 96.5%. كل فشل يتم اكتشافه يصبح سكريبت إعادة إنتاج صغيراً وقضية في مستودع TorchTPU. حتى الآن، تم الإبلاغ عن 34 قضية، وتم إصلاح 19 منها بالفعل.
المصادر
- Hugging Face BlogHugging Face ❤️ TorchTPU: TPUs, Natively
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
TorchNeuron يسهّل تشغيل نماذج Hugging Face على AWS Trainium
أطلقت Hugging Face وAWS تقنية TorchNeuron لتوفير واجهة برمجية أصلية لنماذج الذكاء الاصطناعي على معالجات Trainium، مما يرفع نسبة دعم البنى المعمارية ويحسّن كفاءة التدريب والاستدلال.
جوجل تنضم لأمزون في تحدٍّ جديد لسيطرة إنفيديا على الذكاء الاصطناعي
أطلقت جوجل مشروع TorchTPU مفتوح المصدر لتسهيل نقل تطبيقات PyTorch إلى شرائح TPU الخاصة بها، في خطوة تنافسية مباشرة مع أمزون لكسر احتكار إنفيديا.
وحدات TPU من جوجل تعمل رسمياً في مراكز بيانات ميتا
بدأت شركة ميتا تشغيل وحدات المعالجة Tensor التابعة لجوجل لأحمال عمل الذكاء الاصطناعي في بيئة الإنتاج باستخدام محركات استدلال جديدة ومفتوحة المصدر.
أداة جديدة لمعرفة توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium
تتيح مساحة تفاعلية جديدة على منصة Hugging Face للباحثين والمطورين التحقق بسهولة من توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium.