تدريب نموذج Qwen3 على منصة AWS Trainium باستخدام torchtitan
أعلنت المدونة الرسمية لشركة أمازون وبما يتماشى مع أحدث تطورات الذكاء الاصطناعي عن إمكانية تدريب نموذج Qwen3 بثلاث طرائق مختلفة على مثيل واحد من نوع trn2.48xlarge.
 رضوان عبدالهاديمحرر وكاتب تقني
مقدمة حول دمج torchtitan مع AWS Trainium
يتيح استخدام مكتبة torchtitan على منصة AWS Trainium تشغيل أحمال العمل بالطريقة المعتادة والمألوفة للمطورين. يقوم محرك TorchNeuron بتسجيل Trainium كجهاز PyTorch أصلي، مما يسمح لمكتبة torchtitan بالاستفادة منه مباشرة عبر واجهات PyTorch القياسية. تتيح هذه الإعدادات للمطورين إمكانية إجراء التدريب المسبق من التهيئة العشوائية أو الضبط الدقيق للأوزان المنشورة عبر البيئات المدعومة من أمازون.
يمكن للمطورين الاستعانة بمستودع الرموز البرمجية والأدوات المتاحة لتعزيز تجربة التدريب، حيث يوفر هذا التكامل مرونة عالية في ضبط المعلمات والهندسة الخاصة بالنماذج الكبيرة ضمن بيئة تشغيل موحدة ومتسقة.
الطريقة الأولى: استخدام نموذج Transformers v5 كخلفية نمذجة
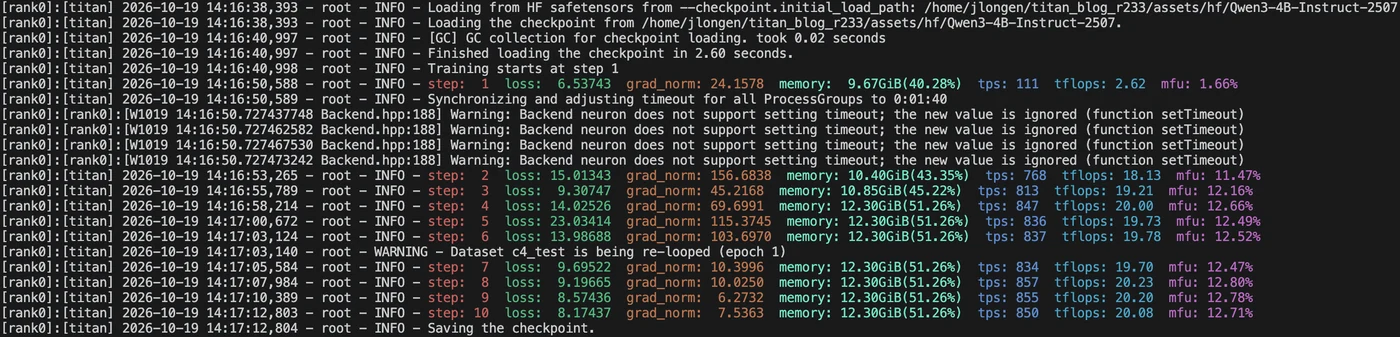
تعتمد الطريقة الأولى على استخدام واجهة Transformers v5 كخلفية نمذجة داخل مكتبة torchtitan. تتيح هذه الطريقة تشغيل نماذج Hugging Face مباشرة من خلال واجهة AutoModelForCausalLM، مع قراءة وكتابة ملفات safetensors المنشورة بصورة مباشرة ودون تعقيد.
تتطلب هذه العملية تهيئة مثيل مفرد من طراز trn2.48xlarge مع توفير بيئة تشغيل مناسبة تحتوي على برنامج تشغيل ووقت تشغيل ومجمع Neuron اللازم للتعامل مع العتاد بكفاءة عالية، مما يضمن توافقاً كاملاً أثناء تنفيذ عمليات التدريب المختلفة.
الطريقة الثانية: الانتقال إلى نموذج Qwen3 الأصلي داخل torchtitan
تنتقل الطريقة الثانية إلى استخدام نموذج Qwen3 الأصلي الخاص بمكتبة torchtitan من خلال تعديل إعدادات التكوين وتحديد مواصفات النموذج المطلوبة. يتيح هذا النهج للمطورين الاستفادة القصوى من الهندسة الداخلية للنموذج وتوزيع العمليات بكفاءة عبر الأنوية المتاحة.
يستخدم هذا التكوين فئات النموذج المحددة لتحديد كيفية تقسيم الأوزان وتعيين مفاتيح نقاط التحقق، مع دعم الاهتمام بنقطة القياس القياسية (SDPA) لضمان أداء مستقر أثناء عمليات التدريب المكثفة.
الطريقة الثالثة: دمج نوى خليط الخبراء MoE باستخدام NKI
تضيف الطريقة الثالثة نوى خليط الخبراء (MoE) المستندة إلى واجهة النوى البرمجية لـ Neuron والمعروفة اختصاراً بـ NKI، والمأخوذة من وصفات torchtitan-neuron المخصصة. يتم تفعيل هذه النوى من خلال سجل تجاوز الصلاحيات المتاح في torchtitan لإرفاق النوى المخصصة وتطوير أداء العمليات المعقدة.
تدعم بيئة تشغيل Neuron المشغلين المسجلين لكل من التنفيذ الحريص (eager mode) وعمليات التحويل البرمجي المتقدمة، مما يمنح المطورين حرية اختيار النمط الأنسب لاحتياجاتهم الحسابية مع الحفاظ على بنية تكوين موحدة.
إدارة الأجهزة والموارد أثناء التدريب
يتعين على الفرق التقنية مراقبة الموارد واستخدام أدوات الإدارة السحابية المتاحة عند التعامل مع مثيلات الحوسبة الكبيرة. في حالات الصيانة أو الانتهاء من مهام التدريب، يمكن للمطورين إيقاف المثيلات الحوسبية مؤقتاً عند الحاجة وفقاً للإرشادات المعتمدة.
وعند رغبة المستخدمين في التخلص النهائي من الموارد لتجنب التكاليف الإضافية، تتوفر آليات موثوقة لإنهاء المثيلات بشكل كامل وآمن بناءً على توثيق منصة أمازون السحابية.
المصادر
- AWS Machine Learning BlogTrain Qwen3 on AWS Trainium with torchtitan
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
TorchNeuron يسهّل تشغيل نماذج Hugging Face على AWS Trainium
أطلقت Hugging Face وAWS تقنية TorchNeuron لتوفير واجهة برمجية أصلية لنماذج الذكاء الاصطناعي على معالجات Trainium، مما يرفع نسبة دعم البنى المعمارية ويحسّن كفاءة التدريب والاستدلال.
أداة جديدة لمعرفة توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium
تتيح مساحة تفاعلية جديدة على منصة Hugging Face للباحثين والمطورين التحقق بسهولة من توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium.
AWS تتيح نشر نموذج Reflection Beam مفتوح الأوزان للبرمجة الوكيلية
تتيح AWS نشر نموذج Reflection Beam مفتوح الأوزان عبر SageMaker JumpStart وHyperPod Inference، مع دعم لأوزان NVFP4 وFP8 للتحكم في البنية التحتية.
AWS تتيح الوصول المباشر إلى SageMaker Studio بتسجيل اجتماعي مبسّط
أطلقت AWS تجربة تسجيل جديدة تتيح للمطورين الوصول إلى بيئة SageMaker Studio خلال دقائق باستخدام حسابات Google أو GitHub، مع 100 دولار كريدت مجاني دون بطاقة ائتمانية.