AWS تتيح نشر نموذج Reflection Beam مفتوح الأوزان للبرمجة الوكيلية
أطلقت Reflection AI نموذج Beam مفتوح الأوزان للبرمجة الوكيلية، وأتاحت AWS نشره عبر خدمات SageMaker مع خيارات تحكم موزعة.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق نموذج مفتوح الأوزان للبرمجة الوكيلية
أعلنت شركة Reflection AI عن إطلاق نموذج Beam، وهو نموذج مفتوح الأوزان مصمم خصيصاً لمهام البرمجة الوكيلية (Agentic Coding) والمهام طويلة المدى. يهدف النموذج إلى تمكين المطورين والباحثين من التحكم الكامل في بيئة التشغيل والنشر والتخصيص، بدلاً من الاعتماد على واجهات API مغلقة. يأتي هذا الإطلاق في إطار رؤية الشركة لجعل الذكاء الاصطناعي مفتوحاً ومتاحاً للجميع من خلال أوزان النماذج المفتوحة والأبحاث المنشورة والبرمجيات مفتوحة المصدر.
يعمل Beam كنموذج خبير مختلط (Mixture-of-Experts) متناثر، حيث يمتلك 501 مليار معامل إجمالي، لكن فقط 23 مليار معامل نشط أثناء كل عملية استدعاء. هذا التصميم يسمح للنموذج بمعالجة مهام معقدة مثل تعديل الكود، واستدعاء الأدوات، والتفاعل مع النتائج الوسيطة، وإكمال سير العمل متعددة الخطوات بكفاءة عالية. كما تشير التقارير إلى أن النموذج يدعم طول سياق فعال يصل إلى مليون رمز، مما يتيح له التعامل مع قواعد كود ضخمة ومشاريع برمجية معقدة دون فقدان السياق.
خيارات النشر عبر منصة AWS
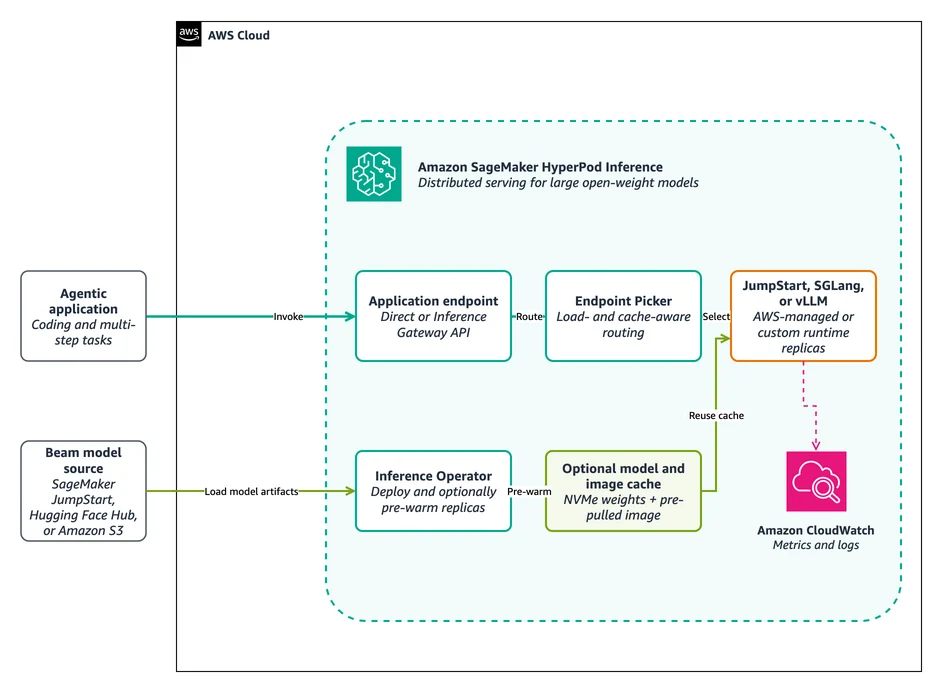
توفر AWS مسارين رئيسيين لنشر نموذج Beam على بنيتها التحتية. المسار الأول يعتمد على Amazon SageMaker JumpStart، الذي يوفر نقطة نهاية زمنية حقيقية (Real-time Endpoint) مُدارة بالكامل. هذا الخيار يناسب المطورين الذين يبحثون عن أبسط طريقة للانتقال من كتالوج النماذج إلى نقطة نهاية HTTPS مُدارة دون الحاجة إلى إدارة Kubernetes أو البنية التحتية الموزعة يدوياً.
المسار الثاني هو استخدام Amazon SageMaker HyperPod Inference، وهو مصمم للمؤسسات التي تحتاج إلى تحكم أصلي عبر Kubernetes في البنية التحتية الموزعة للوحات GPU. يتيح هذا المسار استخدام حاويات JumpStart المُدارة من AWS، أو استخدام أطر عمل مثل SGLang أو vLLM للحصول على تحكم كامل في صور التشغيل، وحواليات التكميم، وتنفيذ المهام الموزعة. يتوفر النموذج حالياً في منطقتي US East (N. Virginia) وUS East (Ohio) عبر JumpStart.
تفاصيل الأوزان والمتطلبات الحسابية
تُصدر Reflection AI أوزان Beam عبر Hugging Face تحت رخصة Apache 2.0، مما يسهل الوصول إليها وتوزيعها. يتوفر إصدار Beam 1.0 بثلاثة تنسيقات للأوزان: BF16 وFP8 وNVFP4. يوفر كل تنسيق بصمة ذاكرة مختلفة وتوافقاً مع عتاد مختلف، مما يمنح المطورين مرونة في اختيار التوازن بين الدقة والأداء والتكلفة.
بسبب حجم المعاملات الإجمالي البالغ 501 مليار، يتطلب النشر استخدام عدة وحدات GPU. بالنسبة لتنسيق BF16، الذي يتطلب أكبر قدر من الذاكرة للأوزان، يُنصح بتكوين متعدد العقد مع ذاكرة GPU مجمعة كافية. أما لتنسيق FP8، فتوصي AWS باستخدام أنواع المعالجات مثل ml.p5.48xlarge مع وحدات NVIDIA H100، أو ml.p5e.48xlarge وml.p5en.48xlarge مع وحدات H200. بينما يتطلب تنسيق NVFP4 استخدام نوع المعالج ml.p6-b200.48xlarge مع وحدات NVIDIA B200. يجب على المطورين التأكد من أن نقاط التفتيش (Checkpoints) والإصدار المستهدف يدعمان نوع المعالج المختار.
إعدادات النشر والتحكم في الأداء
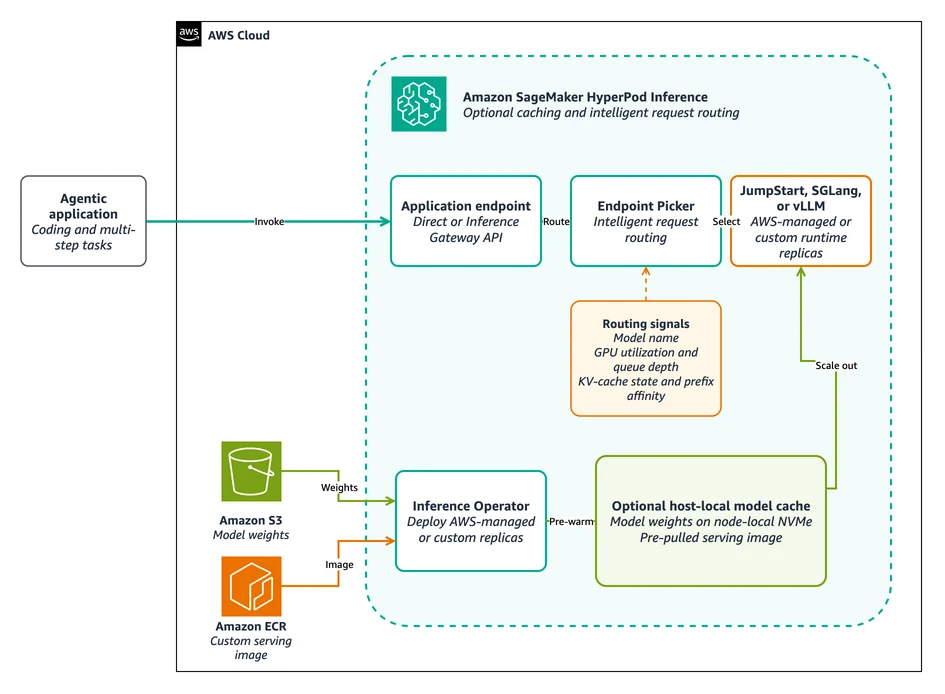
يتطلب النشر عبر مسار HyperPod Inference إعداد وصول kubectl إلى عناقيد HyperPod التي تُدار بواسطة Amazon Elastic Kubernetes Service (EKS). يتيح هذا الإعداد التحكم في توزيع التنفيذ، والتخزين المؤقت، والتوجيه، والتوسع التلقائي. يمكن للمستخدمين تحديد أهداف التزامن (Concurrency) وزمن الاستجابة (Latency) المتوقعة، ثم تكوين النسخ (Replicas) والتخزين المؤقت والتوجيه بناءً على سلوك الحمل الفعلي.
توفر HyperPod Inference ميزات متقدمة مثل التخزين المؤقت الهرمي المُدار (Managed Tiered KV Caching) والتوجيه الذكي، مما يحسن كفاءة استخدام الذاكرة وسرعة الاستجابة في البيئات الموزعة. كما يمكن للمستخدمين اختيار مصدر النموذج من JumpStart أو Hugging Face Hub أو مرآة اختيارية على Amazon S3، مما يوفر مرونة في إدارة الأصول البرمجية.
الخطوات العملية للاختبار والنشر
لبدء الاختبار عبر مسار JumpStart، يجب على المطورين استنساخ مستودع العينات الخاص بـ AWS وتنفيذ أوامر Python التي تدير دورة حياة النشر والاستدعاء والتنظيف. تدعم الأوامر الاختيار بين تنسيقات الأوزان المختلفة، حيث يكون NVFP4 هو الافتراضي عند عدم تحديد الخيار --variant. توفر هذه الأوامر طريقة سريعة لإنشاء نقطة نهاية، وإرسال طلب تجريبي، وعرض الاستجابة، ثم تنظيف الموارد لتجنب التكاليف غير الضرورية.
قبل النشر النهائي، يجب على المطورين حساب الذاكرة المطلوبة للأوزان والتخزين المؤقت (KV Cache) والتكاليف التشغيلية لكل نسخة، والتحقق من هذه التقديرات عبر اختبارات الحمل. كما يجب التحقق من حصة الخدمة (Service Quota) والسعة المتاحة لنوع المعالج المختار في المنطقة المحددة. يمكن استخدام سعة الطلب الفوري (On-demand) أو خطط تدريب SageMaker كحجز قصير المدى للأعمال المجدولة.
المصادر
- AWS Machine Learning BlogIntroducing Reflection Beam: an open-weight model for agentic coding on AWS
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
ريفلشن تطلق نموذج الذكاء الاصطناعي Beam المفتوح الأوزان
كشفت شركة ريفلكشن عن نموذجها المفتوح الأوزان Beam لمنافسة النماذج الصينية بكفاءة أعلى وتكلفة حوسبة أقل، مستهدفة المؤسسات الكبرى والدول عبر مصانع الذكاء الاصطناعي.
AWS Batch تتيح إدارة حصص GPU بين فرق الذكاء الاصطناعي
أطلقت AWS ميزة إدارة الحصص في AWS Batch لتوزيع سعة GPU بين الفرق، مع استعارة الموارد الخاملة تلقائياً وتنفيذ الأولويات دون تدخل يدوي.
هاغينغ فيس تطلق Beam بنموذج مفتوح من 501 مليار معلمة
أطلقت هاغينغ فيس نموذج Beam من Reflection بقدرة 501 مليار معلمة وسياق مليون رمز، مع دعم التخصيص والتشغيل على بنية الفرق الخاصة.
التدريب الموزع عبر Ray Train DLCs وEFA على EKS
استكشاف كيفية استخدام حاويات Ray Train لمواجهة تحديات التدريب الموزع لنماذج الذكاء الاصطناعي عبر EFA وAmazon EKS دون الحاجة لبناء صور.