AWS تطلق حاويات Ray LLM لدعم استنتاج LLM متعدد العقد
تقدم AWS حلاً جديداً لتبسيط نشر نماذج اللغة الكبيرة عبر عدة خوادم، مما يسمح بفصل مراحل الاستنتاج لتحسين الأداء وتقليل التعقيد التقني.
 رضوان عبدالهاديمحرر وكاتب تقني
مقدمة في النشر متعدد العقد
أعلنت شركة Amazon Web Services (AWS) عن إطلاق حاويات Ray LLM Deep Learning Containers، وهي حزمة برمجية مصممة خصيصاً لتشغيل أحمال عمل الاستنتاج (Inference) متعددة العقد. تتيح هذه الحاوية نشر نموذج لغة كبير واحد عبر عقدتي GPU على منصة Amazon EKS، مع الحفاظ على واجهة برمجية واحدة متوافقة مع OpenAI. هذا النهج يعالج تحدياً تقنياً شائعاً حيث تتطلب بعض النماذج الكبيرة موارد تتجاوز قدرة بطاقة GPU واحدة، أو تحتاج إلى توزيع الحمل لزيادة الإنتاجية.
يأتي هذا الإصدار كخطوة متقدمة بعد تقديم حاويات Ray Serve DLC سابقاً، والتي كانت تركز على تشغيل النماذج على عقدة واحدة. الهدف الآن هو تسهيل إدارة النماذج المعقدة التي تتطلب توازناً دقيقاً بين حسابات المعالجة الأولية وتوليد الرموز، مما يوفر على المطورين جهداً كبيراً في ضبط التبعيات البرمجية ومعالجة تعقيدات البيئة.
فصل مراحل الاستنتاج
يعتمد الحل الجديد على تقنية تُعرف بفصل مراحل الاستنتاج (PD Disaggregation). في الاستنتاج التقليدي، تتم مرحلتا Prefill و Decode على نفس بطاقة GPU. مرحلة Prefill تتمثل في معالجة المدخلات الأولية بالكامل، وهي عملية كثيفة الحسابات، بينما مرحلة Decode هي توليد الرد رمزاً تلو الآخر، وهي عملية تعتمد بشكل أكبر على عرض نطاق ذاكرة الوصول العشوائي. عند دمج المرحلتين، تتنافس على نفس الموارد، مما قد يؤدي إلى تأخير في توليد الرموز عندما تكون هناك طلبات معالجة طويلة.
من خلال توزيع المرحلتين على عقدتين مختلفتين، يمكن تخصيص كل عقدة حسب طبيعة المرحلة. العقدة الأولى تتولى مرحلة Prefill، والثانية تتولى مرحلة Decode. هذا الفصل يمنع أعمال الحسابات الثقيلة من تعطيل عمليات التوليد المستمرة، مما يحسن الأداء العام خاصة في التطبيقات التي تتطلب استجابة سريعة ومستمرة مثل توليد المحتوى المعزز بالبحث (RAG) وتلخيص المستندات.
مكونات الحاوية البرمجية
توفر AWS Deep Learning Containers (DLCs) صور Docker جاهزة ومحسنة للأداء، تجمع بين إطار العمل وتبعياته ومكدس GPU في حزمة واحدة مختبرة. الحاوية الجديدة Ray LLM DLC توسع هذا المفهوم لتشمل النشر الموزع. تتضمن الحاوية محرك الاستنتاج vLLM، وطبقة الخدمة Ray Serve HTTP، بالإضافة إلى مكتبة NVIDIA Inference Transfer Library (NIXL) المسؤولة عن نقل ذاكرة KV بين العقد.
كما تشمل الحاوية مكدس Elastic Fabric Adapter (EFA) الذي يوفر اتصالاً عالي النطاق بين العقد. بفضل مكتبة Ray Serve LLM، يمكن بناء تطبيق الخدمة بالكامل عبر ملف YAML واحد، دون الحاجة لكتابة كود مخصص أو بناء صور برمجية خاصة. هذا يبسط عملية النشر ويقلل من احتمالية الأخطاء الناتجة عن عدم توافق إصدارات المكتبات.
البنية التحتية على Amazon EKS
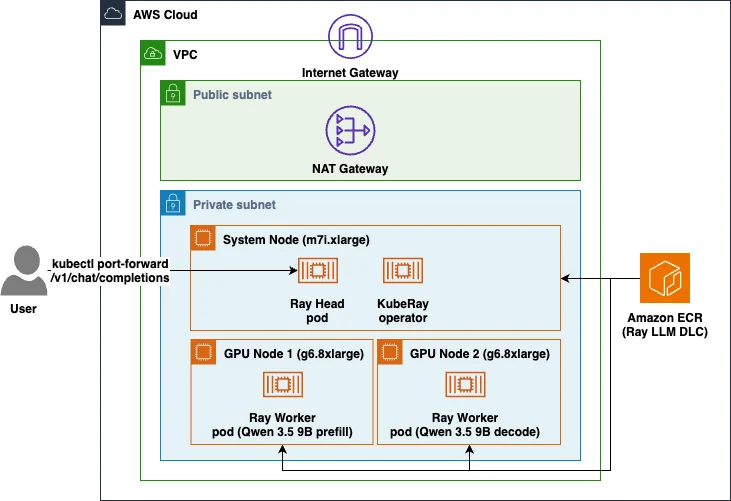
تُنفذ البنية التحتية داخل شبكة خاصة (VPC) على Amazon EKS. تتكون البنية من عقدة نظام CPU (نوع m7i.xlarge) تستضيف رأس Ray (Ray Head) ومشغل KubeRay، وعقدتي عمل GPU (نوع g6.8xlarge) تعملان كعقد Ray Workers. إحدى عقدتي GPU مخصصة لمرحلة Prefill والأخرى لمرحلة Decode. يتم تثبيت جميع المكونات عبر KubeRay الذي يدير الاتصال بين الرأس والعقد تلقائياً.
من الناحية التقنية، يجب تثبيت مجموعة عقد GPU في منطقة توافر (Availability Zone) واحدة، نظراً لأن تقنية EFA لا تدعم العبور بين مناطق التوافر المختلفة. يتم نقل ذاكرة KV من عقدة Prefill إلى عقدة Decode عبر NIXL باستخدام libfabric كواجهة خلفية، مما يضمن سرعة نقل البيانات الكافية للحفاظ على فائدة فصل المرحلتين.
متطلبات التنفيذ والإعداد
لتنفيذ هذا الحل، يحتاج المستخدمون إلى حصة خدمات كافية لتشغيل عقدتي g6.8xlarge (بإجمالي 64 vCPU على الأقل) في المنطقة المستهدفة. كما يتطلب الأمر إعداد واجهة سطر الأوامر AWS CLI، وأدوات kubectl و eksctl لإدارة العناقيد، بالإضافة إلى helm لتثبيت مشغل KubeRay. توفر هذه الأدوات مجموعة متكاملة لإدارة دورة حياة التطبيق من الإنشاء إلى التشغيل.
يتم تحديد إعدادات التطبيق عبر ملف YAML، حيث تُضبط معاملات مثل طول السياق الأقصى (max_model_len) ونوع البيانات (dtype) ونسبة استخدام ذاكرة GPU. هذه الإعدادات الحرجة تضمن ملاءمة النموذج للموارد المتاحة وتحسين كفاءة الذاكرة، مما يجعل العملية قابلة للتكرار والتوسع دون تعقيدات برمجية إضافية.
المصادر
- AWS Machine Learning BlogRun multi-node inference workloads using Ray LLM Deep Learning Containers
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
التدريب الموزع عبر Ray Train DLCs وEFA على EKS
استكشاف كيفية استخدام حاويات Ray Train لمواجهة تحديات التدريب الموزع لنماذج الذكاء الاصطناعي عبر EFA وAmazon EKS دون الحاجة لبناء صور.
نشر نماذج Nemotron على منصات أمازون للذكاء الاصطناعي
استكشف كيفية تسريع وكلاء الذكاء الاصطناعي باستخدام نماذج NVIDIA Nemotron على منصات Amazon EKS وSageMaker HyperPod EKS لتعزيز الأداء.
أمازون ترفع كفاءة تدريب نماذج MoE بنسبة 40% عبر EKS وEFA
تقدم أمازون ويب سيرفيسز معمارية جديدة لتدريب نماذج مزيج الخبراء (MoE) باستخدام التعلم المعزز، مما يحقق زيادة 40% في الإنتاجية عبر تكامل EKS وEFA وDeepEP.
تدريب التعلم التعزيزي المتعدد الوسائط باستخدام SkyRL على HyperPod
تعرف على كيفية تشغيل إطار عمل SkyRL للتعلم التعزيزي على Amazon SageMaker HyperPod لتدريب نموذج متعدد الوسائط باستخدام تقنية GRPO.