
تدريب التعلم التعزيزي المتعدد الوسائط باستخدام SkyRL على HyperPod
أعلنت المدونة التقنية AWS Machine Learning Blog عن إرشادات تفصيلية لتشغيل إطار عمل SkyRL مفتوح المصدر على بيئة Amazon SageMaker HyperPod لتنفيذ مرحلة ما بعد التدريب لنموذج الرؤية واللغة Qwen3-VL-8B.
 رضوان عبدالهاديمحرر وكاتب تقني
أهمية التدريب اللاحق بالتعلم التعزيزي وتقنيات البنية التحتية
تُعد مرحلة ما بعد التدريب للتعلم التعزيزي خطوة محورية وأساسية في بناء وكلاء النماذج اللغوية القادرة على التفكير واتخاذ القرار بمرونة عبر خطوات متتابعة. تتعلم النماذج الاستدلال والتفاعل من خلال توليد مسارات العمل، وتلقي المكافآت، وتحديث السياسات بناءً على النتائج المحققة. يتطلب تشغيل هذه العمليات على نطاق واسع عبر عقد متعددة ومئات الساعات من معالجة وحدات معالجة الرسوميات بنية تحتية مستدامة ومستقرة للبنية العنقودية، وهي متطلبات توفرها خدمات مثل Amazon SageMaker HyperPod.
تتطلب البنية التحتية القدرة على تحمل المهام الطويلة، واستعادة التشغيل بعد الأعطال الهاردويرية دون فقدان التقدم المحرز، فضلاً عن توفير رؤية واضحة ومباشرة لديناميكيات التدريب أثناء تنفيذها. توفر هذه البيئة الكفاءة العالية لمهام التعلم الآلي واسعة النطاق على نظم إدارة الحاويات عبر خدمات مثل Amazon Elastic Kubernetes Service (Amazon EKS).
دور مرونة العقد وقدرات Ray في إدارة التدريب طويل الأمد
تتميز بيئة التشغيل بقدرتها على مراقبة صحة العقد باستمرار واستبدال العقد المعطلة تلقائياً، مما يمنع أعطال الأجهزة من تعطيل النظام بأكمله بفضل ميزات مرونة العقد المتاحة في المنصة. وعند دمجها مع نظام نقاط التحقق، تستطيع مهام التدريب استئناف العمل من آخر خطوة محفوظة بدلاً من إعادة التشغيل من البداية، وهو أمر بالغ الأهمية لمهام التعلم التعزيزي الطويلة الممتدة عبر عقد متعددة.
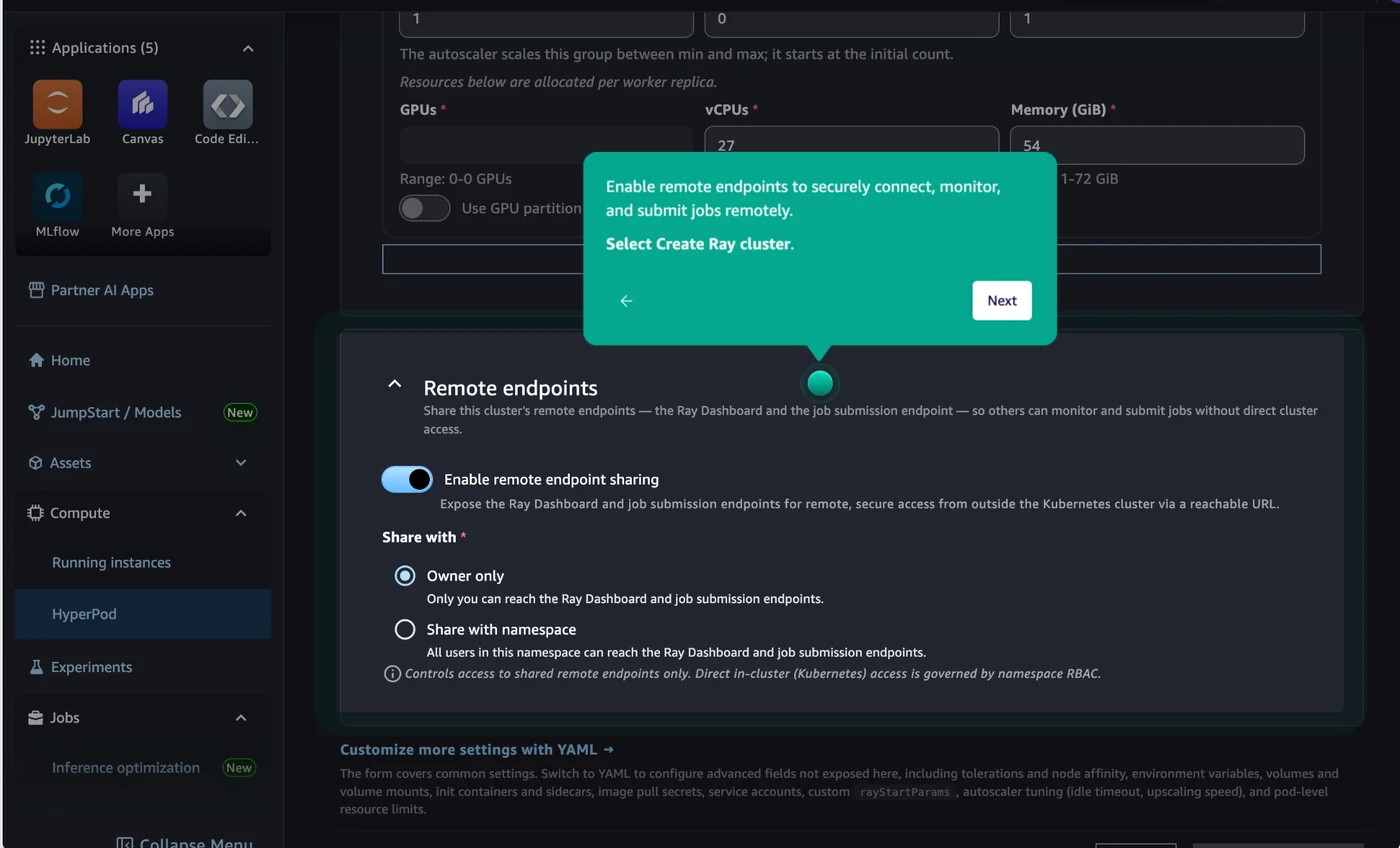
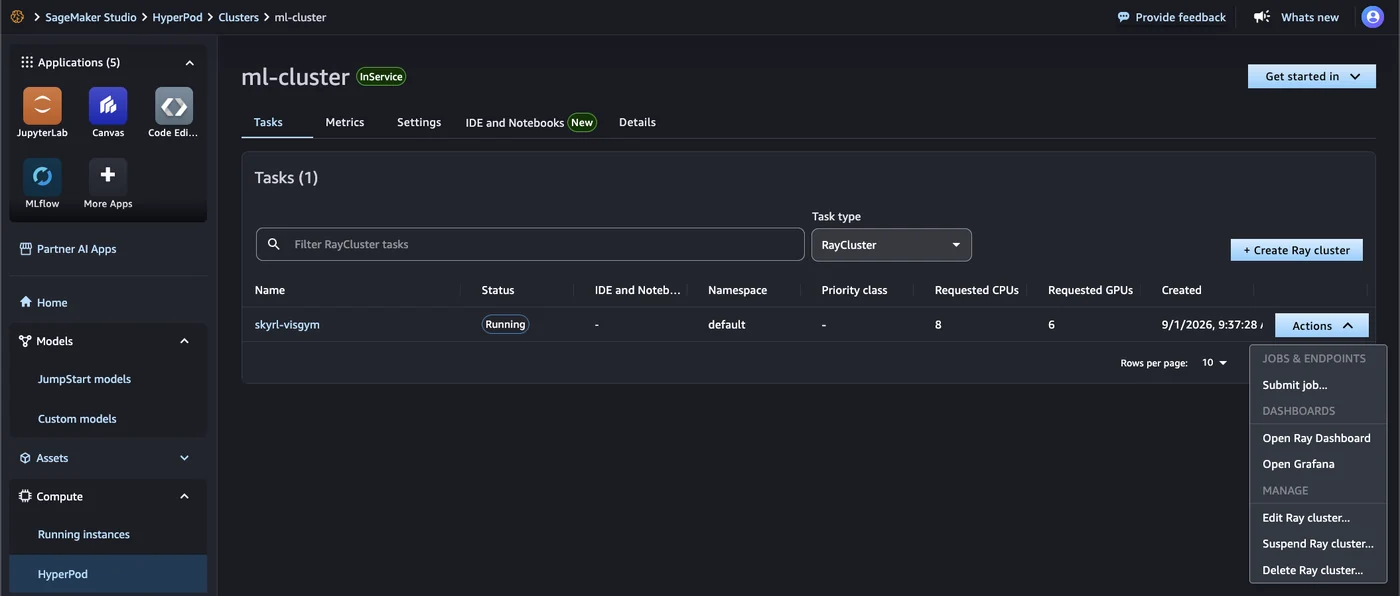
بالتوازي مع ذلك، يتيح دمج قدرات راي المتاحة على المنصة إنشاء مجموعات تشغيلية مباشرة من بيئة التطوير، وإرسال المهام عن بعد عبر اتصال آمن، ومراقبة مسار التدريب باستخدام لوحات معلومات مخصصة. وتقدم المدونة التقنية AWS Machine Learning Blog تفاصيل متكاملة حول كيفية الاستفادة من هذه الأدوات لرفع كفاءة النماذج.
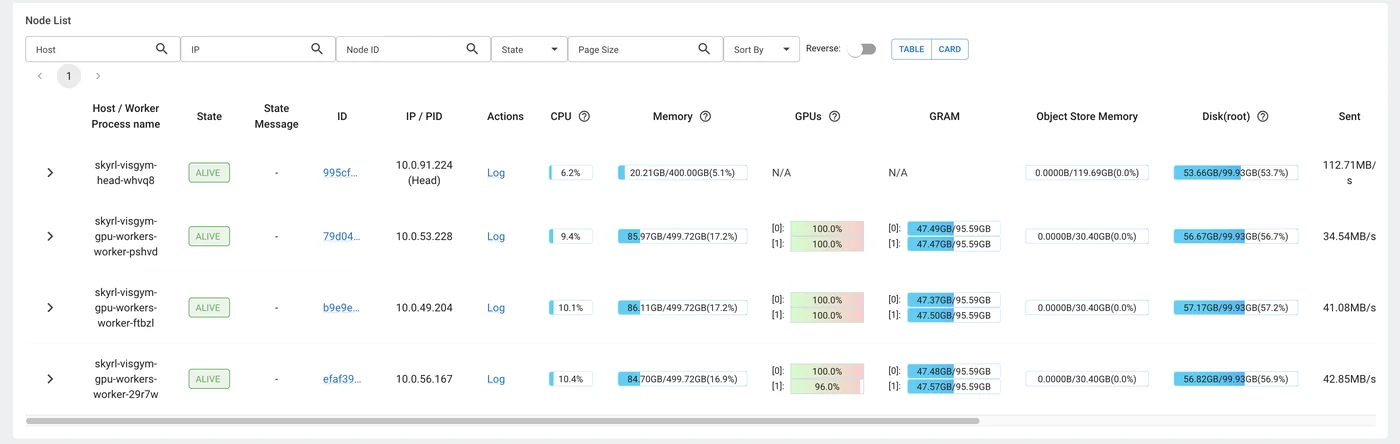
تساعد لوحات التحكم المجهزة مسبقاً والمستندة إلى أدوات المراقبة في تتبع الأداء بدقة، بينما تضمن الوظائف الملحقة إتاحة البيانات وتحليل المقاييس بشكل لحظي لضمان سير عمليات التدريب المتقدمة بسلاسة تامة دون انقطاع.
تنفيذ نموذج Qwen3-VL-8B وتقنية GRPO للمتاهات البصرية
توضح التجربة العملية كيفية توظيف إطار عمل SkyRL المفتوح لتشغيل مهام التدريب المتقدمة لنموذج الرؤية واللغة، بهدف تمكينه من اجتياز المتاهات البصرية المعقدة عبر استخدام تقنية تحسين السياسة النسبية الجماعية المعروفة اختصاراً بـ GRPO. يبدأ التدريب اعتماداً على نقطة بداية التوليف الموجه المتاحة في VisGym SFT checkpoint، مما يسهم في رفع معدل نجاح حل المتاهات بشكل ملحوظ مقارنة بالوضع السابق.
يعتمد التدريب المتعدد الدورات على توجيه الوكيل عبر تسلسل كامل من الخطوات، حيث يلاحظ الحالة الحالية، يتخذ القرار، يتلقى التقييم، وينتقل إلى الحالة اللاحقة. ونتيجة لندرة المكافآت في بيئة المتاهات، يحصل النموذج على تقييم إيجابي فقط عند وصوله الفعلي إلى الهدف ضمن حدود الحركات المسموحة، مما يجعل تقنية GRPO أداة فعالة لتقييم التشغيلات مقارنة بمتوسط المجموعة دون الحاجة لنموذج تقييم منفصل.
المتطلبات التقنية والهندسة العنقودية لتشغيل النظام
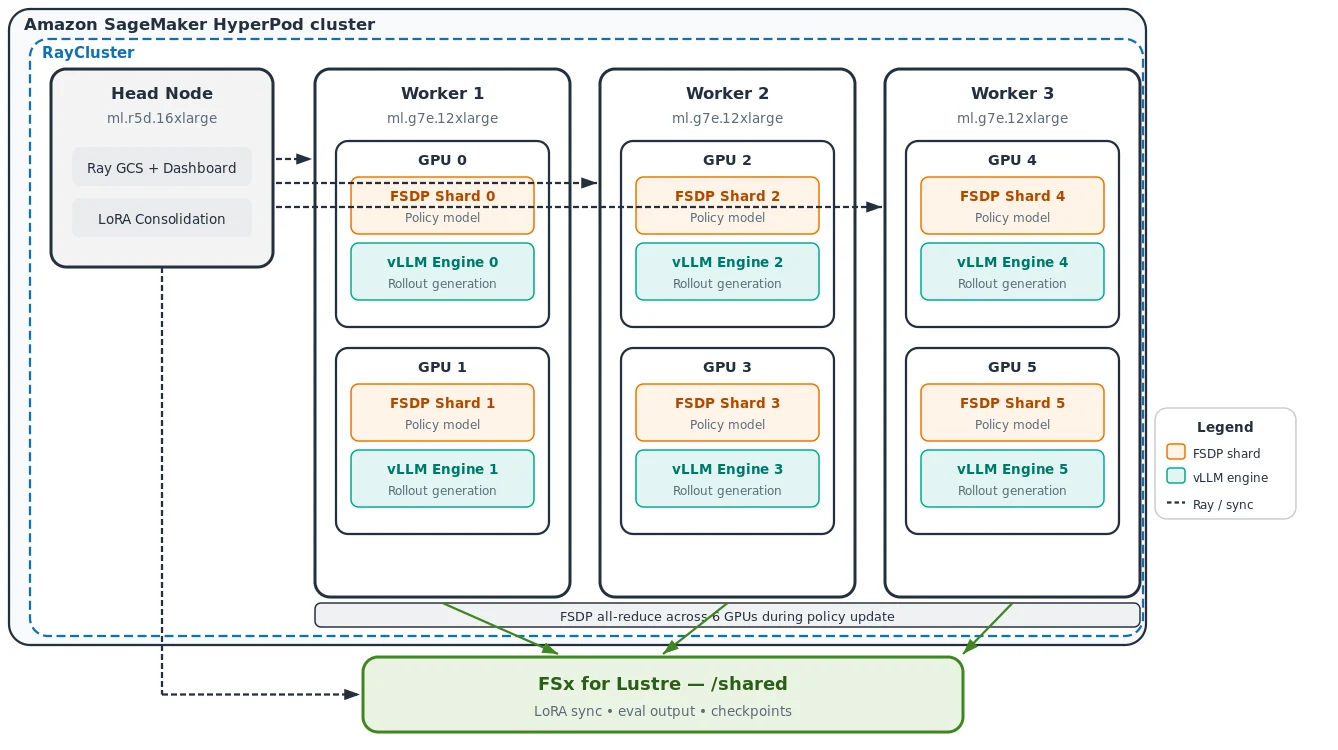
يتطلب تشغيل هذه البنية العنقودية إعداد مجموعة تشغيلية تتضمن مثيلات معالجة رسومية ومثيلات مخصصة لعقد التحكم، بالإضافة إلى تركيب مشغلات Kubernetes اللازمة مثل مشغل KubeRay وإضافات المراقبة الخاصة بالمنصة. ويمكن للمطورين الاطلاع على الإرشادات التفصيلية عبر دليل البدء السريع المخصص لتلك التقنيات.
تشمل البنية التحتية أيضاً استخدام نظام ملفات مشترك يعتمد على برنامج التشغيل المناسب لتخزين نقاط التحقق، ومزامنة محولات التكيف منخفضة الرتبة، وحفظ مخرجات التقييم لضمان تدفق البيانات بكفاءة عالية بين محركات التوليد وعقد السياسة.
المصادر
- AWS Machine Learning BlogAccelerate multimodal RL training with SkyRL on Amazon SageMaker HyperPod