أمازون تتيح نشر نماذج القرار عبر llama.cpp على SageMaker AI
تقدم أمازون حلاً تقنياً جديداً لنشر نماذج الذكاء الاصطناعي المصممة لاتخاذ القرارات، مما يتيح للشركات الحصول على احتمالات رياضية دقيقة بدلاً من النصوص الحرة.
 رضوان عبدالهاديمحرر وكاتب تقني
نشر نماذج القرار على SageMaker AI
أعلنت أمازون ويب سيرفيسز عن طريقة تقنية جديدة لنشر نماذج اتخاذ القرار باستخدام مكتبة llama.cpp على منصة Amazon SageMaker AI. تتيح هذه المنصة للشركات تقديم نماذج كمومية (Quantized) على بنية تحتية تعتمد على معالجات CPU أو GPU، مما يوفر مساراً مديراً لإدارة هذه النماذج دون الحاجة إلى بناء بنية تحتية معقدة من الصفر.
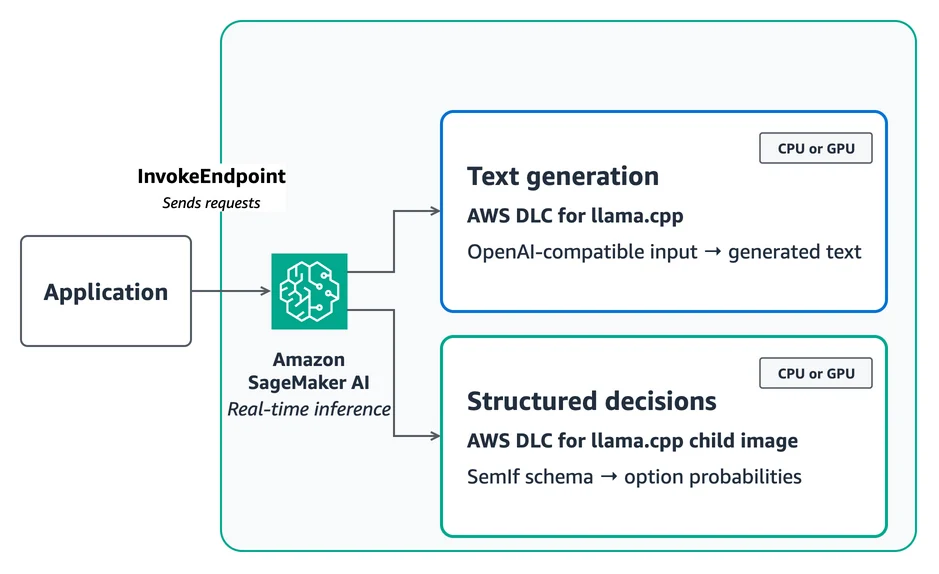
تندرج هذه المبادرة ضمن سلسلة مقالات تقنية تركز على حاويات التعلم العميق المتخصصة (DLCs) للاستدلال التوليدي. توفر أمازون حاوية جاهزة تتيح للمستخدمين تقديم طلبات مكتملة متوافقة مع واجهات OpenAI، مما يسهل تكامل نماذج اللغة الكبيرة مع التطبيقات الحالية.
توسيع القدرات عبر إطار SemIf
لا يقتصر الحل على توليد النصوص فقط، بل يمتد ليشمل اتخاذ القرارات المهيكلة. من خلال دمج إطار SemIf، الذي كان يُعرف سابقاً باسم OpenJev، يمكن للمطورين تحويل النموذج إلى محرك يعيد احتمالات رياضية لخيارات محددة مسبقاً، بدلاً من فك ترميز رمز إجابة نصي كامل. هذا النهج مفيد بشكل خاص للتطبيقات التي تتطلب تصنيفاً دقيقاً أو توجيهاً للطلبات بناءً على مجموعة ثابتة من النتائج.
يتطلب هذا التوسع بناء صورة فرعية (Child Image) باستخدام AWS CodeBuild، حيث يتم استبدال نقطة الدخول الافتراضية بمحول متوافق مع SageMaker. يحافظ هذا المحول على المكتبات المُجمعة مسبقاً للمعالجات أو CUDA، مما يضمن كفاءة التشغيل مع إضافة القدرة على الوصول المباشر إلى القيم اللوجستية النهائية (Logits).
آلية عمل الطلبات والاستجابات
في المسار القياسي لتوليد النصوص، يتم تغليف النموذج في ملف model.tar.gz وتخزينه في Amazon Simple Storage Service (Amazon S3). يقوم الحاوية تلقائياً باكتشاف ملفات .gguf وتوجيه الطلبات الواردة إلى خادم llama-server، مع تمرير متغيرات البيئة اللازمة للتحكم في عملية التوليد.
أما في مسار اتخاذ القرار باستخدام SemIf، فيحتوي الطلب على معرف محدد من قبل المستدعي، وحالة غير منظمة، وسؤال، وقائمة مرتبة بالخيارات المسموح بها. تعيد الاستجابة معرّفات الخيارات، والاحتمالات، والقيم اللوجستية الخام بنفس الترتيب، مما يتيح للتطبيق تطبيق عتبات محددة وفحوصات سياسة دون الحاجة إلى تحليل نصوص مولدة قد تكون غير دقيقة.
مقارنة الأداء بين CPU وGPU
أجرت أمازون اختبارات أداء باستخدام 231 مهمة عامة من مجموعة JevBench، حيث قارنت بين نقطة نهاية تعتمد على معالج CPU وأخرى تعتمد على GPU. أظهرت النتائج أن نقطة نهاية GPU كانت أسرع بمعدل 4.9 مرات عند نقطة الوسط (p50) وأسرع بمعدل 32.2 مرة عند نقطة الترتيب 95 (p95)، مما يجعلها الخيار الأمثل للمهام التفاعلية ذات متطلبات زمن الاستجابة الصارمة.
استخدمت الاختبارات ميزة مجموعات أمثلة SageMaker AI لاختيار أنواع الأجهزة المتوافقة، حيث اختارت المنصة مثالاً من نوع ml.g6e.xlarge. أكدت سجلات التشغيل أن مكتبة llama.cpp نقلت جميع طبقات النموذج الـ 34 إلى بطاقة NVIDIA L40S، مما يؤكد كفاءة عملية الإزاحة (Offloading) إلى وحدة معالجة الرسوميات.
توصيات للنشر والإنتاج
توصي أمازون باستخدام معالجات CPU للمهام الخلفية أو غير الحساسة زمنياً التي يمكنها تحمل زمن استجابة بالثواني، بينما يُنصح باستخدام GPU للمهام التفاعلية أو تلك التي تتضمن محفزات طويلة. كما أشارت الشركة إلى أن النماذج الأصغر حجماً قد تقلل من زمن الاستجابة، لكنها قد تؤثر على دقة النتائج، لذا تم الاحتفاظ بنموذج 4B كخيار افتراضي يوازن بين الجودة والأداء.
يُنصح المطورون بإبقاء أوصاف الحالة والخيارات موجزة، وتجميع القرارات التي تشترك في نفس الحالة في طلب واحد لتحسين الكفاءة. كما يجب فصل صلاحيات الوصول والقواعد التجارية الحتمية عن النموذج، والتحقق من احتمالات النموذج قبل اعتبارها ثقة تشغيلية كاملة في بيئة الإنتاج.
المصادر
- AWS Machine Learning BlogDeploy decision models with llama.cpp on Amazon SageMaker AI
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
أمازون تطلق نظام ذكاء اصطناعي لتوليد عروض تقديمية في 90 ثانية
تتيح أمازون ويب سيرفيسز عبر Amazon Bedrock AgentCore إنشاء عروض PowerPoint احترافية من وثائق الشركات في أقل من 90 ثانية، مع ضمان دقة المحتوى عبر تقنيات RAG والحواجز الأمنية.
أمازون تطلق بنية ذكاء اصطناعي للتحليل التفاعلي للفيديو
تقدّم أمازون ويب سيرفيسز حلاً جديداً يعتمد على الوكلاء الذكيين للتحليل التفاعلي للفيديو، مما يتيح للمستخدمين طرح أسئلة بلغة طبيعية والحصول على إجابات فورية من مقاطع فيديو طويلة.
أمازون تطلق فهرسة SOCI لتسريع مهام SageMaker AI
تُزيل أمازون ويب سيرفيسز التحميل الكامل لصور الحاويات من مسار التنفيذ الحرج في SageMaker AI، مما يقلل زمن بدء المهام إلى ثوانٍ ويخفض التكاليف دون تعديل تعريفات المهام.
PS5 المخترقة تشغّل نماذج الذكاء الاصطناعي بسرعة تتجاوز 100 توكن في الثانية
تحديث جديد لبرنامج PS5LM يتيح تشغيل نماذج LLM محلياً على وحدة معالجة الرسوميات GPU، مما يرفع الأداء بشكل كبير ويسمح بتشغيل نماذج ضخمة مثل Qwen3.8-27B بكفاءة عالية.