
أمازون ترفع كفاءة تدريب نماذج MoE بنسبة 40% عبر EKS وEFA
تواجه المؤسسات تحديات كبيرة في موازنة الموارد بين توليد البيانات وتدريب النماذج الضخمة. تقدم أمازون حلاً عملياً يجمع بين Kubernetes وشبكات EFA لتسريع هذه العمليات.
 رضوان عبدالهاديمحرر وكاتب تقني
تحديات تدريب نماذج مزيج الخبراء
أصبحت معمارية مزيج الخبراء (MoE) المعيار السائد لتوسيع نماذج اللغة الكبيرة إلى مئات المليارات من المعاملات، مع الحفاظ على كفاءة الاستدلال من خلال التشتت (Sparsity). ومع ذلك، لا تلغي هذه الخاصية التعقيد البنيوي في مرحلة التدريب. تتطلب هذه النماذج المرور بمراحل متعددة تشمل التدريب المسبق، والتدريب المتوسط، والضبط الدقيق الإشرافي (SFT)، والتعلم المعزز (RL). تبرز هنا تحديات فريدة في التدريب المعزز الكبير، حيث يجمع بين عمل الاستدلال المرن والتدريب المقيد الذي يتطلب اتصالات عالية النطاق الترددي، مما يضيف ضغوطاً إضافية على الذاكرة والشبكة والتنسيق. ويمكن الرجوع إلى AWS Machine Learning Blog للاطلاع على التفاصيل الأصلية للمصدر.
تختلف نماذج MoE عن النماذج الكثيفة (Dense) في أنها تصبح أكثر تشتتاً لتقليل تكاليف الاستدلال، مما يجعل التدريب مقيداً أكثر بالتواصل الشبكي بدلاً من القدرة الحاسوبية. المصدر الرئيسي لهذا العبء هو توازن الخبراء (Expert Parallelism)، الذي يضيف توجيه ديناميكي للرموز (Tokens) بين الأجهزة، بالإضافة إلى أنماط التواصل الكثيفة الأخرى مثل توازن الموترات (Tensor Parallelism). في أعباء العمل غير المتزامنة، يجب موازنة متطلبات الحوسبة والتواصل مع توليد الاستدلال، حيث أن أي تأخير في خطوات التدريب قد يوقف عمال الاستدلال، والعكس صحيح.
المعمارية المقترحة من أمازون
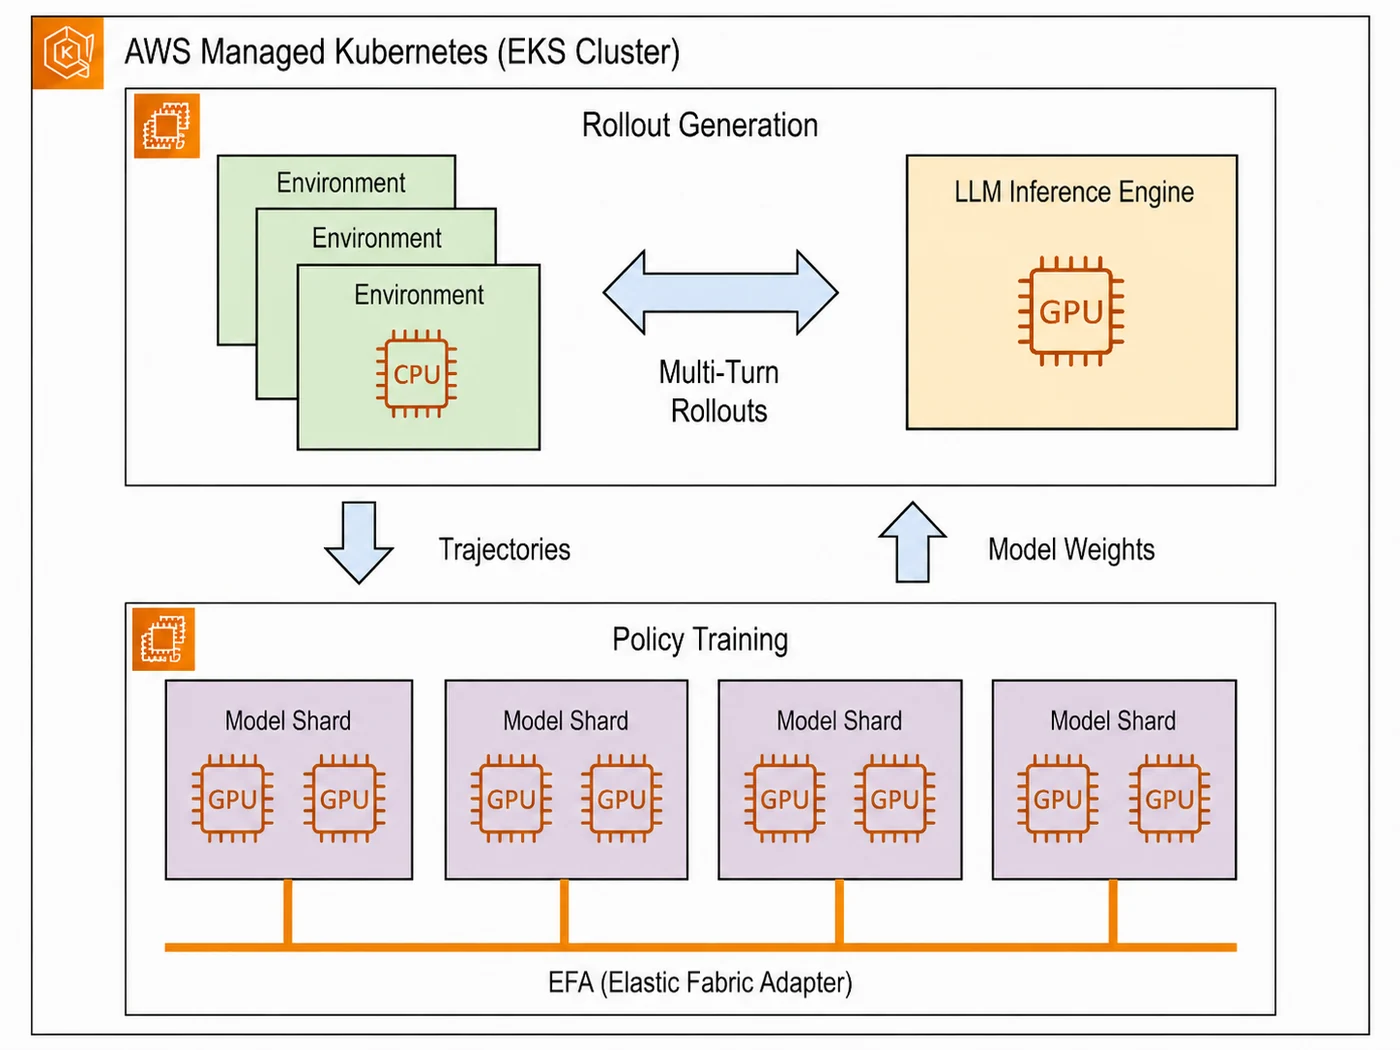
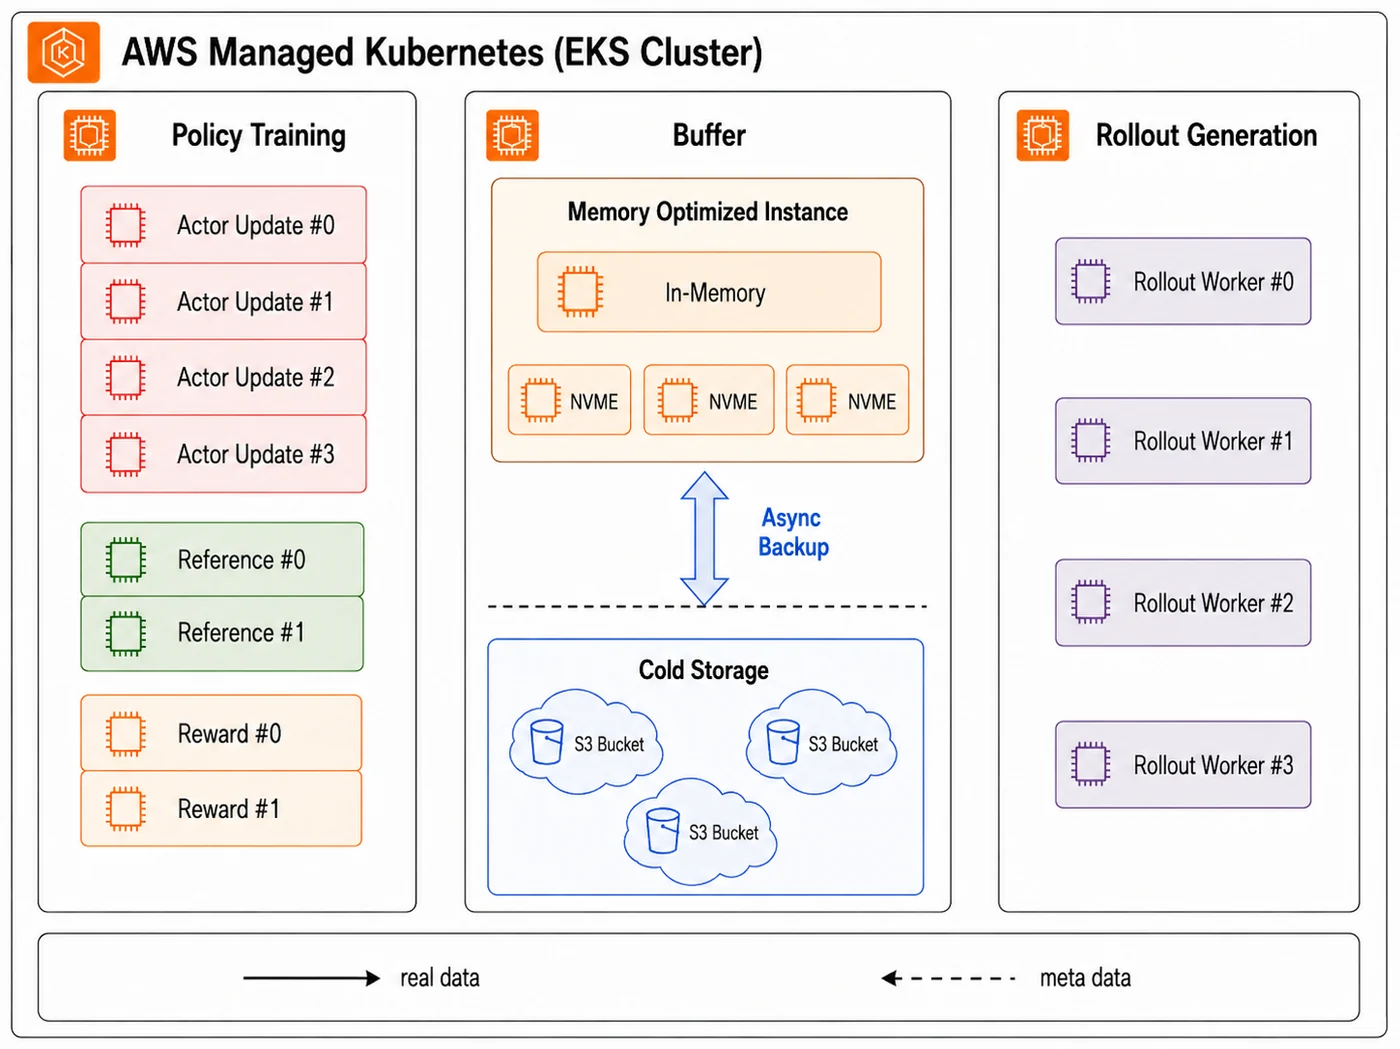
لتجاوز هذه العقبات، وصفت أمازون ويب سيرفيسز معمارية محسنة لتسريع تدريب MoE، تجمع بين خدمة أمازون Kubernetes المرنة (Amazon EKS) ومحول النسيج المرن (EFA) لتنسيق وتسريع التدريب المعزز الكبير. كما تلعب مكتبة DeepEP دوراً محورياً في تحسين توازن التواصل بين الخبراء عبر EFA. تهدف هذه البنية إلى معالجة ثلاثة تحديات مترابطة: موازنة الطلبات المتنافسة بين توليد التمرير (Rollout) وتدريب السياسة، وإدارة الحوسبة والذاكرة والنطاق الترددي الشبكي للمسرعات، والتعامل مع الانتقال من اتصالات داخل العقدة عالية النطاق إلى روابط بين العقد ذات نطاق أقل عند توسيع نطاق العمل.
تعتمد الاستراتيجية على فصل المكونات لتتمكن من التوسع بشكل مستقل. يوفر Amazon EKS إدارة دورة الحياة وتوزيع العمال غير المتجانسين، بينما يوفر EFA مسار بيانات بين العقد عالي الأداء. كما يتم دمج خدمة التخزين البسيط (Amazon S3) لضمان تخزين دائم وقابل للتوسع. هذا التكامل يسمح للمؤسسات بتنفيذ عمليات تدريب معقدة دون خلق عنق زجاجة في أي من الأنظمة الفرعية.
دور EFA وDeepEP في تحسين الأداء
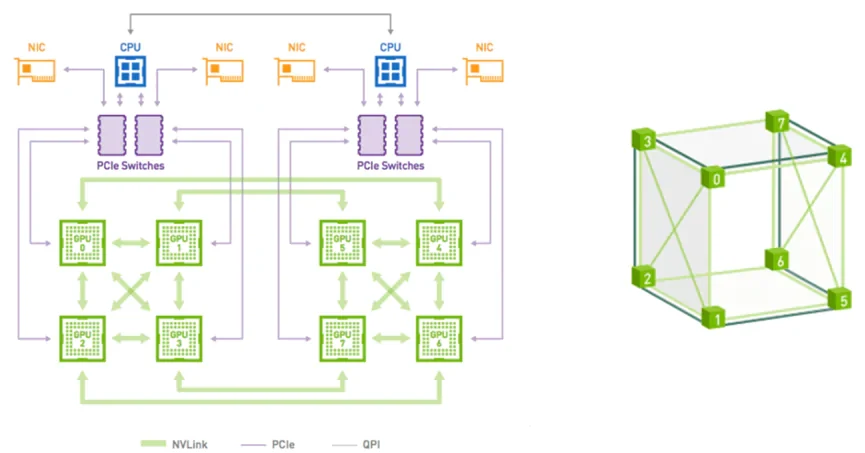
تستخدم أجهزة الحوسبة المتسارعة من أمازون، مثل P5 وP6، مجالين رئيسيين للتواصل: نسيج NVLink داخل الجهاز، والشبكات بين الأجهزة عبر EFA. يوفر EFA حركة بيانات عالية النطاق الترددي بين الأجهزة، ويعمل مع تقنية NVIDIA GPUDirect RDMA لتحويل البيانات مباشرة بين ذاكرات GPU عبر الأجهزة، مما يقلل من تدخل المعالج المركزي ونظام التشغيل. في سياق نماذج MoE، يصبح توازن الخبراء عاملاً حاسماً، حيث يتحول التواصل من أنماط منظمة إلى حركة ديناميكية دقيقة للرموز بين الأجهزة، مما يتطلب بنية تحتية قادرة على التعامل مع هذا التغير السريع في أنماط الشبكات.
تساهم مكتبة DeepEP بشكل كبير في تحسين كفاءة توازن الخبراء عبر EFA. من خلال تحسين مسارات التواصل وتقليل زمن الاستجابة، تساعد هذه المكتبة في الحفاظ على تدفق مستمر للبيانات بين المعالجات. هذا التحسين يضمن أن لا تصبح الشبكة عنق زجاجة يحد من سرعة التدريب، خاصة عند التعامل مع نماذج ضخمة تتطلب توازناً دقيقاً بين الحوسبة والتخزين والشبكة.
إدارة الموارد غير المتجانسة
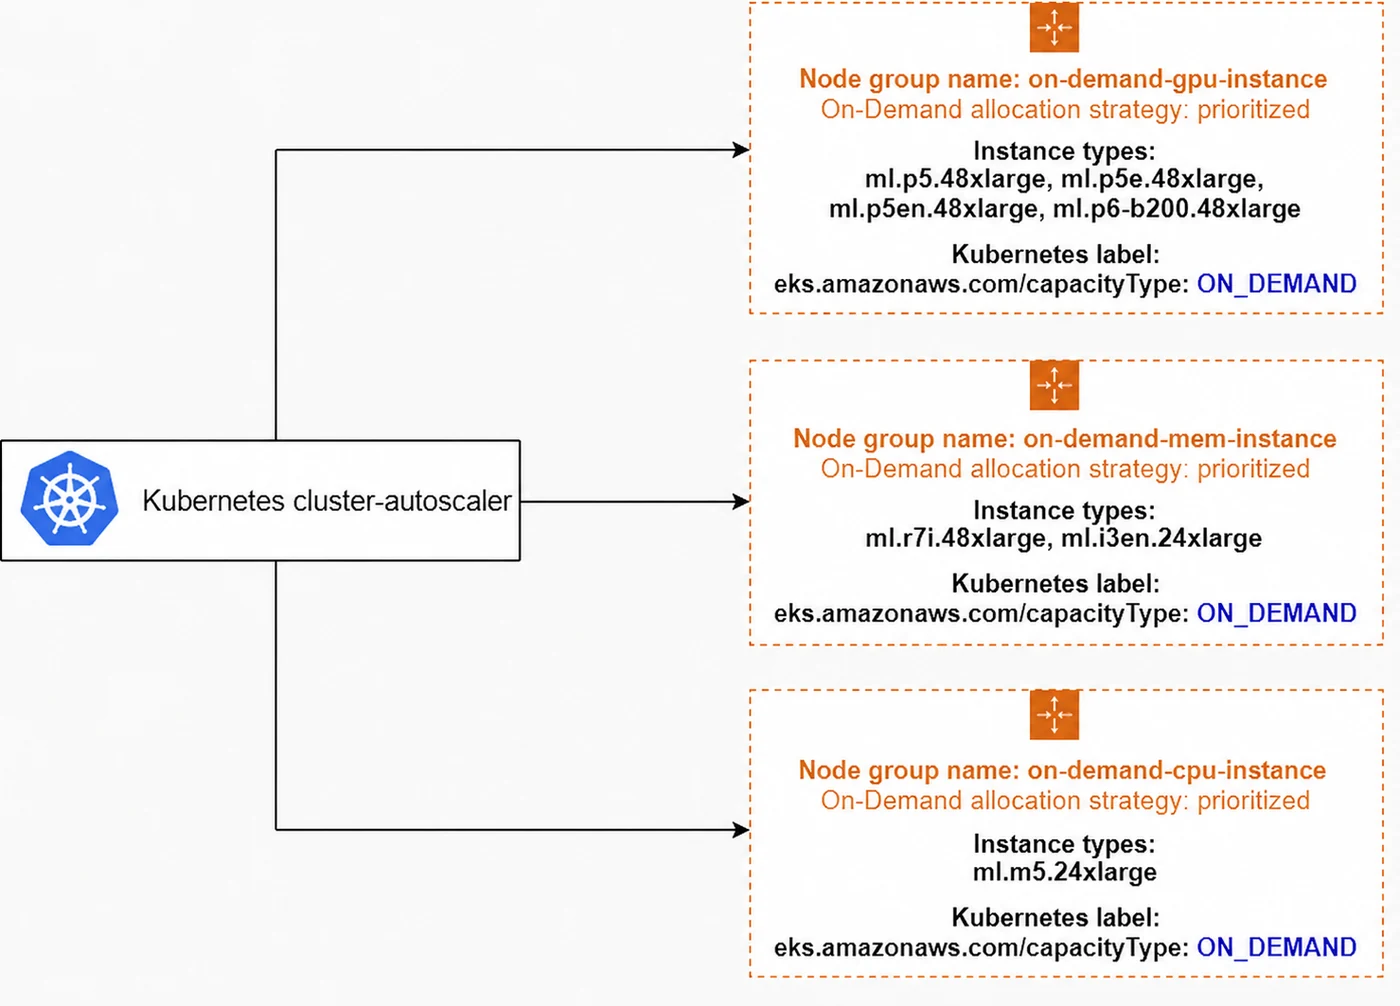
تتميز أعباء العمل المعززة (RL) بمتطلبات حوسبة وتواصل غير متجانسة. يجب على النظام موازنة ثلاثة قيود موارد: حوسبة المسرعات، والذاكرة، والنطاق الترددي الشبكي. يتطلب تدريب السياسة حوسبة كثيفة لمواكبة توليد التمرير، بينما يجب على الاستدلال الموزع إدارة سعة ذاكرة KV-cache وتوليد الرموز. يعد توازن عرض النطاق الترددي للذاكرة والحوسبة أمراً حاسماً لتحقيق أقصى إنتاجية، خاصة مع إضافة طبقات MoE التي تضيف اتصالات ديناميكية متناثرة. كما تضيف نماذج المكافآت وحركة البيانات ضغوطاً إضافية يجب إدارتها بشكل مشترك لمنع أي نظام فرعي من أن يصبح عنق زجاجة.
عند توسيع نطاق مهام التدريب المعزز لتجاوز جهاز واحد، تمتد تقسيمات النموذج ومجموعات التوازي عبر عدة عقد. هذا ينتقل التواصل من نسيج NVLink عالي النطاق الترددي داخل الجهاز إلى روابط بين الأجهزة ذات نطاق أقل. تكثف نماذج MoE هذا التحدي؛ فبدلاً من الأنماط المنظمة لتوازن الموترات، يوجه توازن الخبراء الرموز ديناميكياً عبر الأجهزة من خلال حركة اتصالات دقيقة ومتناثرة، مما يزيد من الاعتماد على كفاءة الشبكة بين العقد.
النتائج والأداء المحقق
أظهرت الاختبارات أن هذه المعمارية المدمجة لـ Amazon EKS وEFA وDeepEP حققت زيادة بنسبة 40% في الإنتاجية الإجمالية لتوليد التمرير في التعلم المعزز (RL). هذا التحسن ملحوظ بشكل خاص في عمليات التدريب الكبيرة مثل RLHF وGRPO. من خلال تحسين توزيع الأحمال وتقليل أوقات الانتظار في الاتصالات الشبكية، تتيح هذه البنية للمؤسسات تدريب نماذج أكثر تعقيداً وبسرعة أكبر، مع الحفاظ على استقرار النظام حتى عند التعامل مع مئات المسرعات.
توفر هذه الحلول أيضاً مرونة في إدارة البنية التحتية. باستخدام أدوات مثل Miles، يمكن للمطورين تنفيذ سيناريوهات تدريب متنوعة. توفر مستودعات مثل Miles إطار عمل مفتوح المصدر يدعم هذه الأنواع من الأحمال، مما يسهل على المهندسين تجربة وتطبيق هذه الممارسات الفضلى في بيئاتهم الخاصة. كما توفر وثائق أمازون إرشادات مفصلة لإعداد EFA على EKS، مما يضمن سهولة التوسع والصيانة.
المصادر
- AWS Machine Learning BlogScaling MoE reinforcement learning on Amazon EKS with EFA and DeepEP with 40% more throughput