NVIDIA تكشف عن Kumo Relational: نموذج ذكاء اصطناعي يتفوق على التعلم الإشرافي
يقدّم نموذج Kumo Relational من NVIDIA نقلة نوعية في معالجة قواعد البيانات، حيث يوفر تنبؤات دقيقة مباشرة دون الحاجة إلى تدريب خاص لكل مهمة.
 رضوان عبدالهاديمحرر وكاتب تقني
نموذج أساسي للبيانات المهيكلة
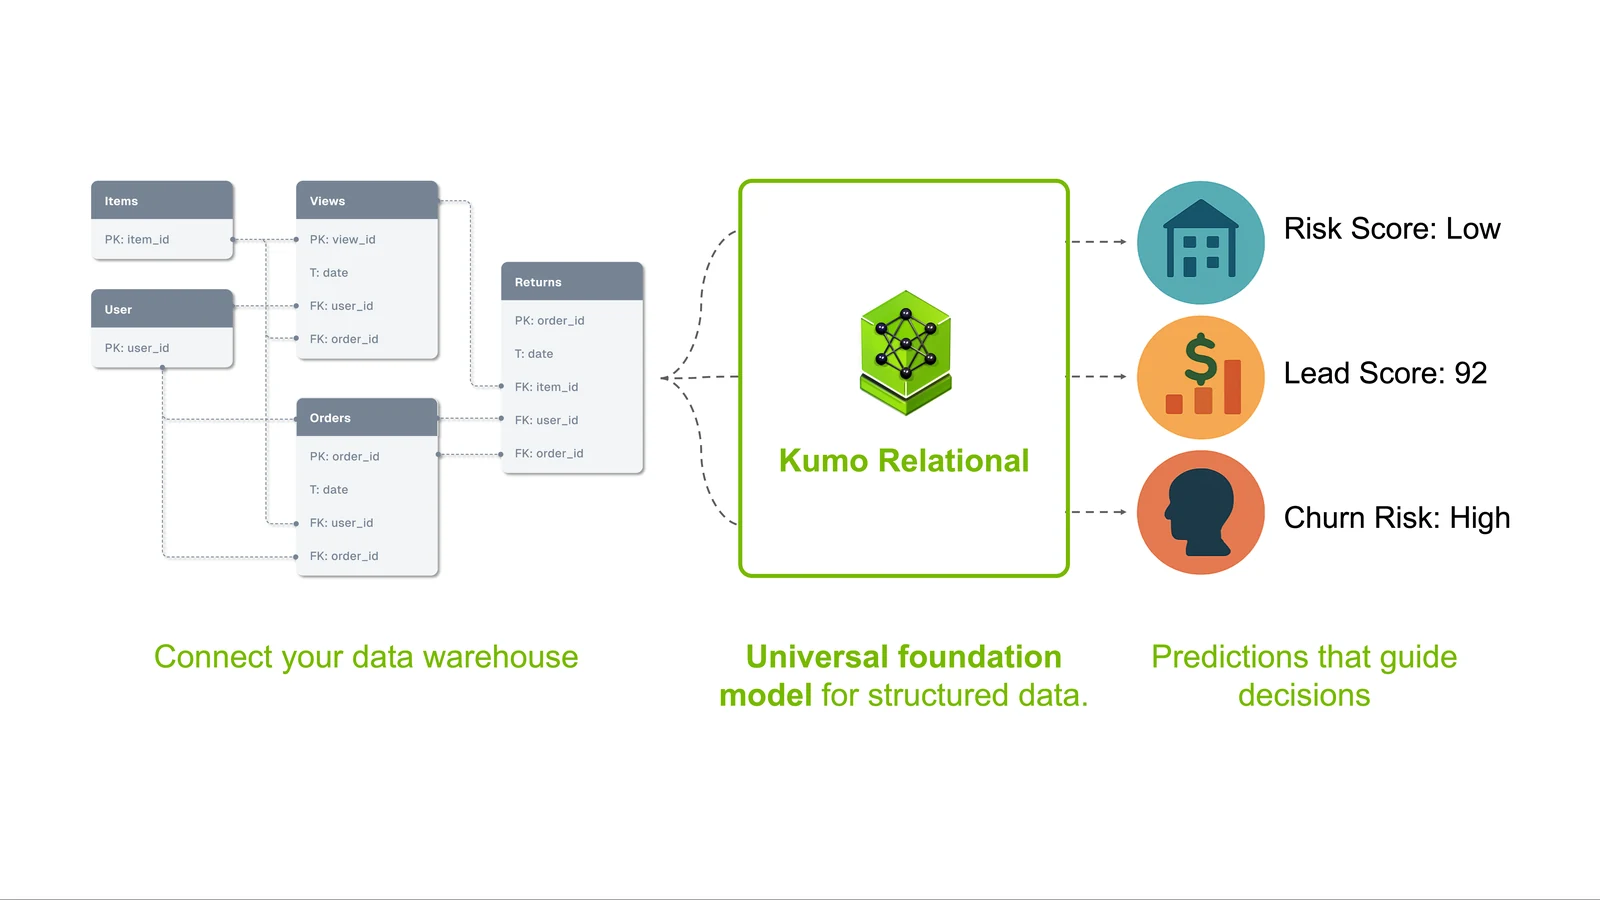
أعلنت شركة NVIDIA عن إطلاق نموذج Kumo Relational، وهو نموذج أساسي (Foundation Model) مدعوم بالتدريب المسبق، مصمم خصيصاً لتقديم تنبؤات مباشرة على قواعد البيانات المؤسسية. يعتمد النموذج على آلية التعلم السياقي (In-Context Learning)، حيث يجمع حتى 10,000 مثال تاريخي كسياق لتقديم تنبؤات حول معدلات التسرب أو الطلب أو الاحتيال في تمريرة حسابية واحدة. يزيل هذا النموذج الحاجة إلى تدريب خاص لكل مهمة، أو هندسة الميزات، أو تسطيح الجداول، مما يجعله أول نموذج أساسي يعتمد على عدة أمثلة (Few-shot) يتفوق على نماذج التعلم الآلي الإشرافي في معايير البيانات العلائقية الشائعة. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
تفوق واضح على الأنظمة التقليدية
أظهرت الاختبارات التي أجرتها NVIDIA على 41 مهمة عبر 15 قاعدة بيانات أن Kumo Relational يتفوق على نماذج التعلم العميق العلائقي الإشرافي وأنابيب أشجار التدرج المعزز (Gradient-Boosted Trees) التي صممها خبراء. في معيار SAP SALT المؤسسي، تجاوز النموذج تجميعات AutoGluon بنسبة 8% في متوسط الترتيب المتبادل (MRR). كما حقق النموذج أداءً يتفوق على خوارزمية XGBoost بمقدار 7 نقاط MRR دون أي ضبط، و13 نقطة بعد الضبط الدقيق، مما يعزز حجتها لاستبدال خطوط الإنتاج الحالية بأنظمة أكثر كفاءة.
الانتقال نحو نماذج البيانات المهيكلة
شهد مجال النماذج الأساسية تحولاً جذرياً في معالجة اللغة والرؤية، حيث استبدلت نماذج اللغة الكبيرة (LLMs) الأنابيب المعقدة بنماذج موحدة أكثر دقة وسهولة في النشر. الآن، يحدث تحول مشابه في البيانات المهيكلة. فعلى الرغم من أن قواعد البيانات العلائقية تقود قرارات الأعمال الحاسمة، إلا أن النمذجة التنبؤية عليها تتطلب عادة أسابيع من هندسة الميزات والتدريب. توفر نماذج البيانات المهيكلة الأساسية دقة أفضل اليوم، وبساطة أكبر، وتمكين الوكلاء (Agents) من التنبؤ بالنتائج المستقبلية بدلاً من مجرد قراءة البيانات.
معالجة العلاقات دون تسطيح البيانات
تعتمد معظم النماذج الأساسية الحالية للبيانات المهيكلة على جداول مسطحة واحدة، بينما تعيش البيانات الحقيقية في قواعد بيانات علائقية مترابطة (مستخدمون مرتبطون بطلبات مرتبطة بمنتجات). يؤدي تسطيح هذه العلاقات إلى فقدان إشارات هيكلية دقيقة ويتطلب جهداً بشرياً كبيراً. يعمل Kumo Relational مباشرة على قاعدة البيانات، محترماً الجداول والمفاتيح الأجنبية والطوابع الزمنية. يتم تدريبه مسبقاً على بيانات علائقية اصطناعية تحاكي الواقع، ويتكيف مع كل مهمة جديدة من خلال قراءة أمثلة سياقية تربط بين البنية الفرعية المحلية حول الكيان والهدف الصحيح له.
آلية الاستدلال عبر الجداول
لتقديم تنبؤ دقيق، يقوم Kumo Relational بثلاث خطوات رئيسية: فهم القيم داخل كل جدول، ربط السجلات عبر الجداول، وربط الأمثلة السياقية بالكيان المستهدف. يستخدم النموذج لغة الاستعلام التنبؤية (PQL) لتوليد السياق تلقائياً، حيث يعيد تشغيل حالات قاعدة البيانات التاريخية لتجنب تسرب البيانات. يعتمد على شبكة خفيفة لمعالجة كل جدول بشكل مستقل، وشبكة أكبر لتوزيع تمثيلات الصفوف عبر البنية العلائقية باستخدام انتباه الرسوم البيانية (Graph Attention)، مما يتيح استنتاج العلاقات بين ملفات المستخدمين وسجلات المعاملات دون تكاليف حسابية تربيعية.
التدريب على بيانات اصطناعية واقعية
نظراً لنُدرة توفر قواعد البيانات العلائقية المتنوعة للعامة، اعتمد فريق NVIDIA على البيانات الاصطناعية لسد هذه الفجوة. يعتمد مولد البيانات على نهج PluRel، الذي يوسع مولدات البيانات أحادية الجدول لتشمل قواعد بيانات علائقية كاملة. ساهم أعضاء فريق Kumo في تطوير PluRel وشاركوا في تأليف الورقة البحثية الأصلية. يتم إجراء التدريب المسبق على مراحل، بدءاً من الجداول الفردية وصولاً إلى هياكل علائقية أكثر تعقيداً، مما يضمن قدرة النموذج على التعامل مع تنوع البيانات في العالم الحقيقي.
التوسع والوصول للمطورين
يقوم Kumo Relational بالتوسع ليشمل قواعد بيانات تحتوي على أكثر من 500 مليار صف، وهو مصمم للعمل مع البشر والوكلاء البرمجيين على حد سواء. يمكن الوصول إلى النموذج من خلال مكتبة NVIDIA مفتوحة المصدر للبيانات المهيكلة (structured-data-models) التي تعمل على وحدات معالجة الرسوميات (GPU)، أو كخدمة NVIDIA NIM. يوفر هذا النموذج واجهة بسيطة للوكلاء لطرح أسئلة تنبؤية، مما يفتح آفاقاً جديدة للتطبيقات الوكيلة في إدارة البيانات المؤسسية.
المصادر
- Hugging Face BlogNVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
مدن أوروبية توظف وكلاء ذكاء اصطناعي من NVIDIA لتحسين العمليات الحضرية
تستثمر مدن في أوروبا وشركاء تقنيون في حوسبة NVIDIA المتسارعة لبناء توأم رقمي ووكلاء ذكاء اصطناعي، مما يحسّن كفاءة الطاقة، النقل، والخدمات العامة عبر بنية تحتية محلية.
NVIDIA تدمج الذكاء الاصطناعي الوكيل في البحث عن إشارات فضائية
تعاون بين NVIDIA ومعهد SETI لدمج منصة Holoscan في مصفوفة تلسكوب ألين، مما يتيح للوكلاء الذكيين تحليل البيانات الفلكية في الوقت الفعلي.
NVIDIA و C-BRAIN تسرّعان اكتشاف علاجات الخرف بالذكاء الاصطناعي
تحالف C-BRAIN يتعاون مع NVIDIA لاستخدام أدوات ذكاء اصطناعي مفتوحة المصدر لتسريع أبحاث الخرف وتحليل البيانات الطبية المعقدة.
NVIDIA وHugging Face يطلقان روبوت Microduck مع Isaac Lab 3.0
يتيح إطار عمل Isaac Lab 3.0 تدريب روبوت Microduck ثنائي القوائم على المشي في المحاكاة ثم نقله فعلياً، مع تصدير السياسات بصيغة ONNX للمشاركة على Hugging Face Hub.