
إطلاق Olmo-core 3: بنية تحتية مفتوحة لتدريب نماذج MoE الضخمة
يُعيد Olmo-core 3 تصميم بنية تدريب النماذج اللغوية الكبيرة، مما يتيح توسيع نماذج مزيج الخبراء إلى نطاق التريليون مع الحفاظ على كفاءة الحسابات وتقليل التكاليف.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق إطار عمل جديد لتدريب النماذج
أعلنت مؤسسة Ai2 عن إطلاق Olmo-core 3، وهو ترقية جوهرية لإطارها التطويري الخاص بالنماذج اللغوية الكبيرة. يركز هذا الإصدار على نظام تدريب مفتوح ومُعاد تصميمه خصيصاً لنماذج مزيج الخبراء (MoE)، بهدف تمكين الباحثين من تدريب نماذج ضخمة بكفاءة أعلى. يأتي هذا الإطلاق ضمن التزام المؤسسة المستمر بفتح الأدوات والبنية التحتية للتدريب أمام المجتمع العلمي، مما يسهل على المختبرات الأصغر والأفراد الوصول إلى تقنيات الذكاء الاصطناعي المتقدمة دون الحاجة إلى موارد حوسبة باهظة.
تحديات تدريب نماذج مزيج الخبراء
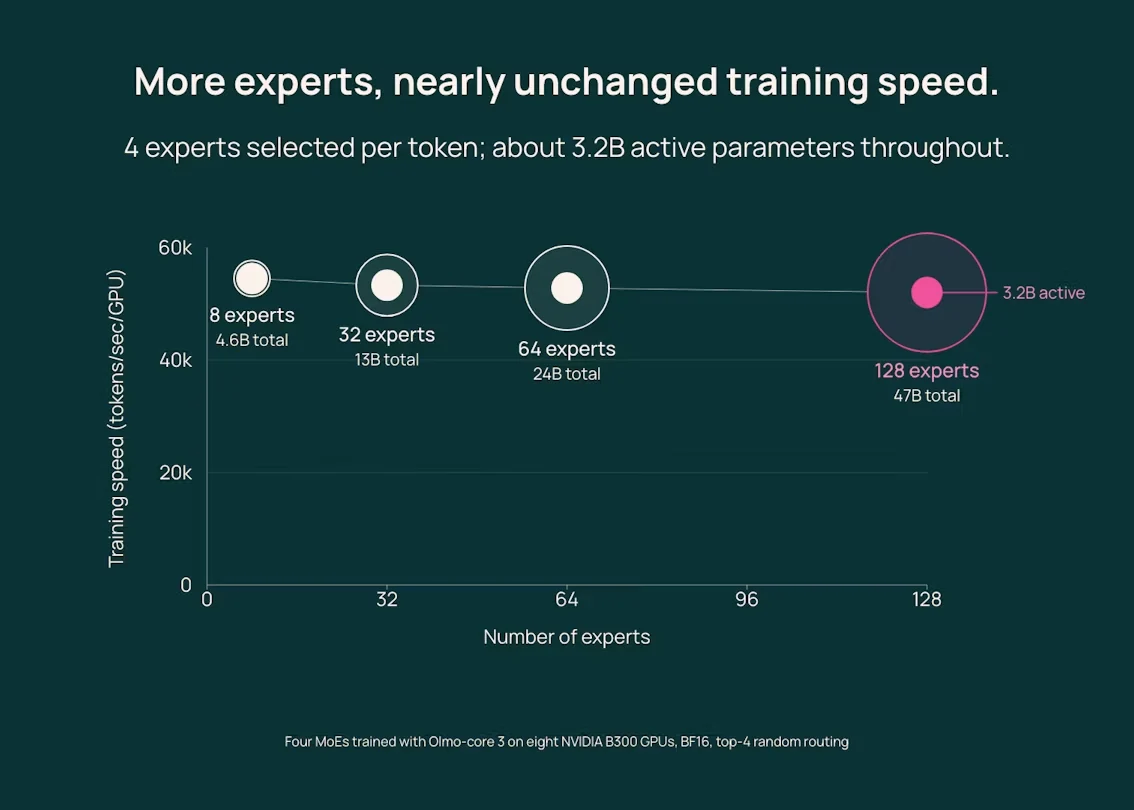
تواجه نماذج مزيج الخبراء تحديات فريدة تتعلق بالتكلفة والكفاءة. على الرغم من أن هذه النماذج توفر كفاءة أعلى عن طريق تفعيل جزء فقط من المعلمات لكل إدخال، إلا أن تخزين النموذج الكامل وتحديثه عبر وحدات معالجة الرسومات (GPU) يولد تكاليف اتصال وتنسيق مرتفعة. مع نمو حجم هذه النماذج، يمكن أن تتآكل المزايا الحسابية الناتجة عن استخدام جزء من النموذج فقط. صُمم Olmo-core 3 لسد هذه الفجوة، حيث أظهرت الاختبارات زيادة في حوض الخبراء من 8 إلى 128 مع الحفاظ على اختيار أربعة خبراء فقط لكل رمز، مما حافظ على عدد المعلمات النشطة ثابتاً تقريباً عند 3.2 مليار، بينما ارتفع إجمالي السعة من 4.6 إلى 47 مليار معلمة دون انخفاض كبير في الإنتاجية.
إعادة هيكلة البنية التحتية للتدريب
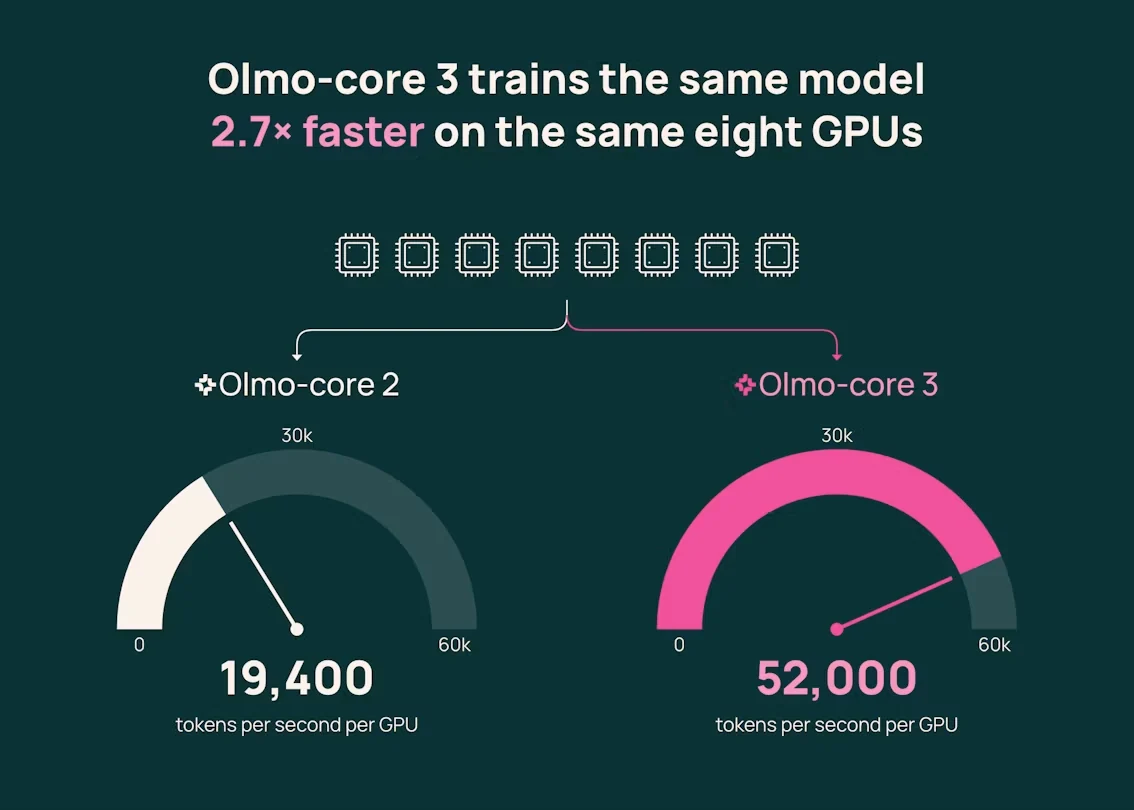
شهد إطار Olmo-core تطوراً عبر أجيال متعددة، بدءاً من OlmoE الذي استخدم بنية MoE بخبراء موجهين، وصولاً إلى Olmo 3 الذي اعتمد بنية كثيفة. في الإصدار الجديد، انتقل النظام من توازى البيانات المشرذمة بالكامل (FSDP) الذي كان يجمع أوزان النموذج لكل دفعة صغيرة، إلى نظام يعتمد على توازى البيانات الموزعة (DDP). هذا التغيير يسمح بإبقاء الخبراء مقيمين على وحدات GPU وتوجيه البيانات ذات الصلة إليهم، مما يتجنب التكرار المكلف لجمع الأوزان. كما يقدم النظام حلاً متكاملاً يتفوق في الإنتاجية على التنفيذ السابق، حيث أظهرت الاختبارات الأولية على وحدات NVIDIA B300 معالجة 52,000 رمز في الثانية لكل وحدة GPU، مقارنة بـ 19,400 في الإصدار السابق، أي ما يعادل زيادة في الإنتاجية بنسبة 2.7 مرة.
تقنيات التوزيع والتوزيع المتوازي
يعتمد Olmo-core 3 على ثلاث تقنيات رئيسية لتوزيع النموذج وحالة التدريب عبر العتاد. أولاً، توازى الخبراء الذي يوزع الخبراء عبر وحدات GPU بحيث تخزن كل وحدة جزءاً فقط من الحوض الكامل. ثانياً، توازى الخطوط (Pipeline parallelism) الذي يقسم طبقات النموذج عبر مجموعات من وحدات GPU لتقليل الذاكرة المطلوبة لكل وحدة. ثالثاً، المحسّن الموزع الذي يوزع حالة المحسّن بدلاً من تخزين نسخة كاملة على كل وحدة. هذه التقنيات مجتمعة تتيح توسيع نطاق نماذج MoE دون الحاجة إلى إبقاء النموذج الكامل وحالة التدريب في ذاكرة كل وحدة GPU، مما يفتح المجال لتدريب نماذج أكبر بكثير.
تحسينات في التوجيه والدقة
لتقليل تكلفة توجيه البيانات إلى الخبراء المناسبين، يطبق النظام توازى الخبراء الصفّي الذي يضع البيانات الموجهة مباشرة في مخازن مدخلات الخبراء، مما يقلل العمل الإضافي لإعادة ترتيبها. كما يحافظ على بيانات التوجيه على وحدات GPU، مما يسمح لوحدة المعالجة المركزية (CPU) بجدولة العمل دون انتظار نسخ هذه البيانات. بالإضافة إلى ذلك، يجمع النظام عمليات GEMM الصغيرة معاً لتنفيذها بكفاءة أعلى. يدعم النظام أيضاً صيغة الأرقام منخفضة الدقة MXFP8، التي تمثل بعض القيم بعدد أقل من البتات. أظهرت الاختبارات على وحدات NVIDIA B300 أن تفعيل MXFP8 رفع الإنتاجية بنسبة 21% مقارنة بصيغة BF16، مع انخفاض ذروة الذاكرة النشطة من 103 GiB إلى 95 GiB.
نتائج الاختبارات على نطاق واسع
خضع Olmo-core 3 لاختبارات واسعة النطاق على وحدات NVIDIA B300، شملت نموذجاً بحجم 1.2 تريليون معلمة مع 58.36 مليار معلمة نشطة لكل رمز عبر 512 وحدة GPU. سجل النظام أعلى معدل إنتاجية ملاحظ بلغ 858 TFLOP/s/GPU. كما جرب الفريق تقنية DeepEP v2 للتعامل مع الاتصالات بين الخبراء، مما أدى إلى الوصول إلى تكوين يحتوي على 2.38 تريليون معلمة إجمالاً. على الرغم من أن هذه الاختبارات الأخيرة كانت قصيرة المدى وتستخدم توجيهات عشوائية لقياس أداء النظام وليس جودة النموذج المدرب، إلا أنها توضح المقياس الهائل الذي يمكن أن يصل إليه Olmo-core 3. توفر هذه النتائج رؤى قيمة حول كيفية تدريب نماذج MoE وقياس أدائها، مع توثيق تجارب حول تحديات مثل عدم توازن الأحمال على الخبراء.
المصادر
- Hugging Face BlogIntroducing Olmo-core 3: Open, scalable training infrastructure for large MoEs