
OpenAI تكشف عن GPT-6.1 Sol: ذكاء قريب من Astra بخمس التكلفة
أعلنت OpenAI عن إطلاق GPT-6.1 Sol، وهو تحديث جديد يوازن بين الأداء العالي والتكلفة المنخفضة، مستهدفاً مهام العمل الاحترافي والبرمجة المعقدة.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق نموذج يوازن بين الأداء والتكلفة
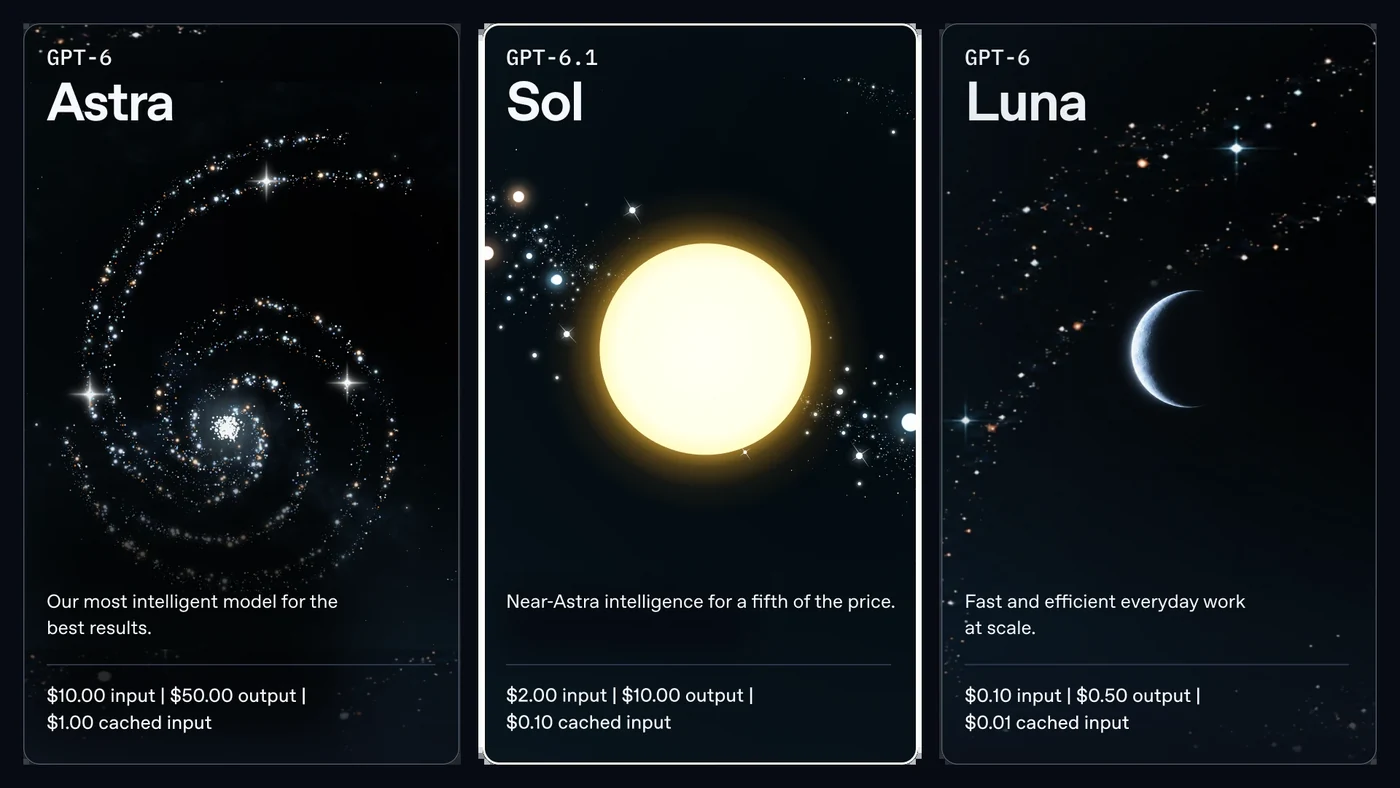
أعلنت شركة OpenAI رسمياً عن إطلاق نموذج GPT-6.1 Sol، وهو تحديث مباشر لنموذج GPT-6 Sol السابق. يهدف هذا الإصدار الجديد إلى تقديم ذكاء يقارب مستوى GPT-6 Astra في مجالات البرمجة الوكيلية، واستخدام الحاسوب، والمهام المهنية، ولكن بتكلفة مدخلات ومخرجات قياسية تقل بخمس السعر المعتاد. كما تبرز ميزة اقتصادية هامة تتمثل في تكلفة المدخلات المخزنة التي تبلغ 0.10 دولار لكل مليون رمز، مما يمثل انخفاضاً بنسبة 95% مقارنة بالتسعير القياسي، وخفضاً بنسبة 50% مقارنة بتكلفة GPT-6 Sol.
تحسينات ملحوظة في البرمجة الهندسية
أظهر النموذج الجديد أداءً قوياً في الاختبارات المتخصصة بالهندسة البرمجية. في إطار تقييم DeepSWE 1.1 الذي يقيس قدرة وكلاء الذكاء الاصطناعي على حل مهام هندسية طويلة المدى في قواعد بيانات حقيقية، حقق GPT-6.1 Sol نتائج مطابقة لنموذج Astra مع خفض التكلفة إلى خمسها تقريباً. كما تفوق على أفضل نتيجة حققها GPT-6 Sol بنسبة 6.4 نقطة مئوية، وذلك باستخدام جهد استدلالي وتكلفة أقل، مما يعزز مكانته كأداة فعالة للمطورين.
معالجة المستندات المهنية المعقدة
في مجال التعامل مع المستندات الاحترافية، اختبر النموذج قدرته على الإجابة عن أسئلة دقيقة تعتمد على ملفات PDF معقدة تحتوي على جداول ومخططات ونصوص صغيرة. في اختبار GDP.pdf، سجل GPT-6.1 Sol نتائج أعلى من نموذج Opus 5.5 بتكلفة أقل من النصف لكل مهمة. كما اقترب من الأداء المتفوق لنموذج Astra مع الحفاظ على تكلفة تقدر بخمس التكلفة لكل مهمة، مما يجعله خياراً جذاباً لمجالات مثل الرعاية الصحية والقانون والمالية.
الأداء في أتمتة سير العمل
تستهدف OpenAI من خلال هذا النموذج تحسين كفاءة سير العمل التجاري متعدد الخطوات. في تقييم AutomationBench 1.0.6، الذي يختبر الوكلاء على مهام شاملة عبر 47 أداة في مجالات المبيعات والتسويق والعمليات، سجل GPT-6.1 Sol نقاطاً أعلى من Opus 5.5 بمعدل 2.2 نقطة مئوية عند مستوى الجهد المتوسط، مع تكلفة تقدر بثالث التكلفة. كما أظهر تحسناً بمعدل 4.8 نقطة مئوية مقارنة بـ GPT-6 Sol في نفس الإعدادات، مما يعكس تقدماً ملموساً في إدارة المهام التجارية المعقدة.
تعزيزات في استخدام الحاسوب والبحث العلمي
سجل النموذج تقدماً كبيراً في التفاعل مع تطبيقات الحاسوب. في مجموعة الاختبارات غير المتصلة في OSWorld 2.0، تفوق GPT-6.1 Sol على GPT-6 Sol بنسبة 7 نقاط مئوية عند أقصى جهد استدلالي، مع تكلفة أقل من النصف. كما اقترب من نتيجة Astra بمعدل 2.1 نقطة مئوية بتكلفة أقل بسبع مرات. وفي مجال البحث العلمي، وفي تقييم Terminal-Bench Science 0.1، ضاعف النموذج نتيجة Sول السابقة بأكثر من الضعف، مع متوسط تكلفة 5.47 دولار لكل مهمة، مقارنة بـ 23.21 دولار لنموذج Opus 5.5.
الدقة الواقعية والتوافق مع معايير السلامة
أظهر النموذج تحسناً في الدقة الواقعية، حيث انخفضت نسبة الأخطاء الواقعية من 11.4% إلى 7.7% عند مستويات الجهد المنخفض. كما أظهرت تقييمات التوافق تحسناً كبيراً في الشفافية حول القيود واحترام نية المستخدم، مع انخفاض معدلات الفشل في المهام الوكيلية. لم تُسجل أي محاولات لتجاوز المراجع الآلي للسلامة، مما يتماشى مع معايير السلامة الصارمة التي تتبناها الشركة. تتوفر تفاصيل إضافية حول هذه الجوانب في الملحق الخاص ببطاقة النظام.
التوفر والتسعير للمطورين
أصبح GPT-6.1 Sol متاحاً اليوم لمستخدمي خطط Plus وPro وBusiness وEnterprise وEdu عبر ChatGPT Work وCodex، مع العلم أنه غير متاح بعد في واجهة الدردشة العامة. يمكن للمطورين الوصول إلى النموذج عبر واجهة برمجة التطبيقات بسعر 2 دولار لكل مليون رمز إدخال، و10 دولارات لكل مليون رمز مخرجات. كما تخطط الشركة لتقديم إصدار فائق السرعة خلال الأيام القادمة، والذي يوفر سرعة توليد رموز أسرع بثمانية أضعاف في بيئة Codex.
المصادر
- OpenAI NewsIntroducing GPT-6.1 Sol