
إطلاق لوحة صدارة تحويل النص إلى كلام وتقنيات الاستنساخ الصوتي
أطلق فريق Hugging Face لوحة صدارة جديدة تسمى Open TTS Leaderboard لتقييم نماذج تحويل النص إلى كلام واستنساخ الأصوات بدقة وسرعة عبر معايير موضوعية متعددة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحديات تقييم نماذج تحويل النص إلى كلام المفتوحة
يشهد مجال نماذج تحويل النص إلى كلام المفتوحة المصدر تطوراً متسارعاً للغاية، حيث تجاوز عدد النماذج المتاحة على منصة Hugging Face ثمانية آلاف نموذج، مما خلق فجوة واضحة بين سرعة إطلاق النماذج وآليات تقييمها التي تظل مجزأة وغير موحدة، وتعتمد غالباً على تفضيلات بشرية بطيئة لا تتماشى مع هذا الكم الهائل من الإصدارات الحديثة، وفق ما أورده المدونون في مدونة Hugging Face Blog.
تواجه أنظمة التقييم المعتمدة على الس ساحات التنافسية عقبات عملية تؤدي إلى تراجع تمثيل النماذج مفتوحة المصدر، إذ تتطلب النماذج التجارية واجهات برمجة تطبيقات سهلة الربط بينما تحتاج النماذج المفتوحة إلى استضافة وتشغيل فعلي من مشغلي المنصة، فضلاً عن صعوبة الحفاظ على اتساق تقييمات المحكمين البشريين بمرور الوقت.
منهجية القياس الموضوعية في لوحة الصدارة
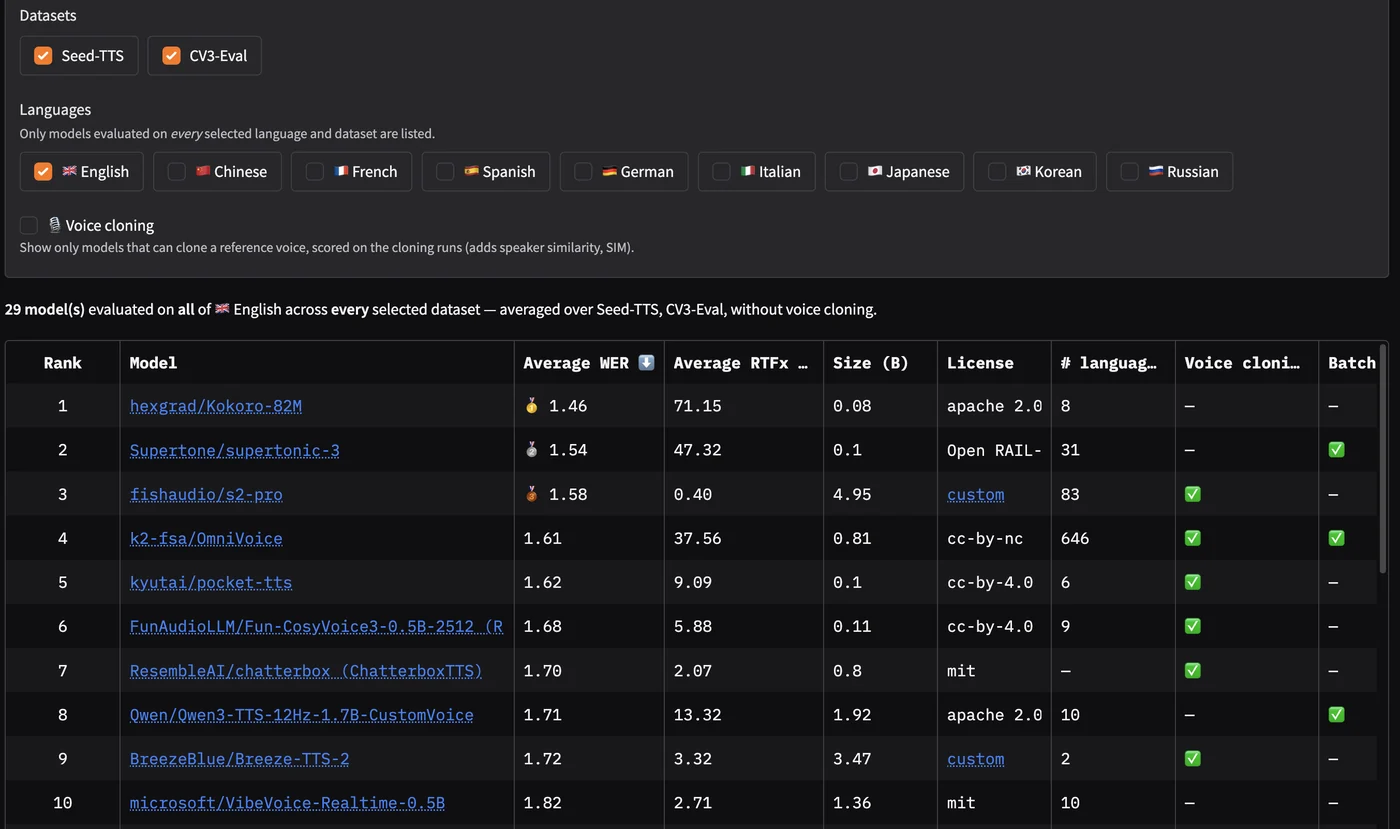
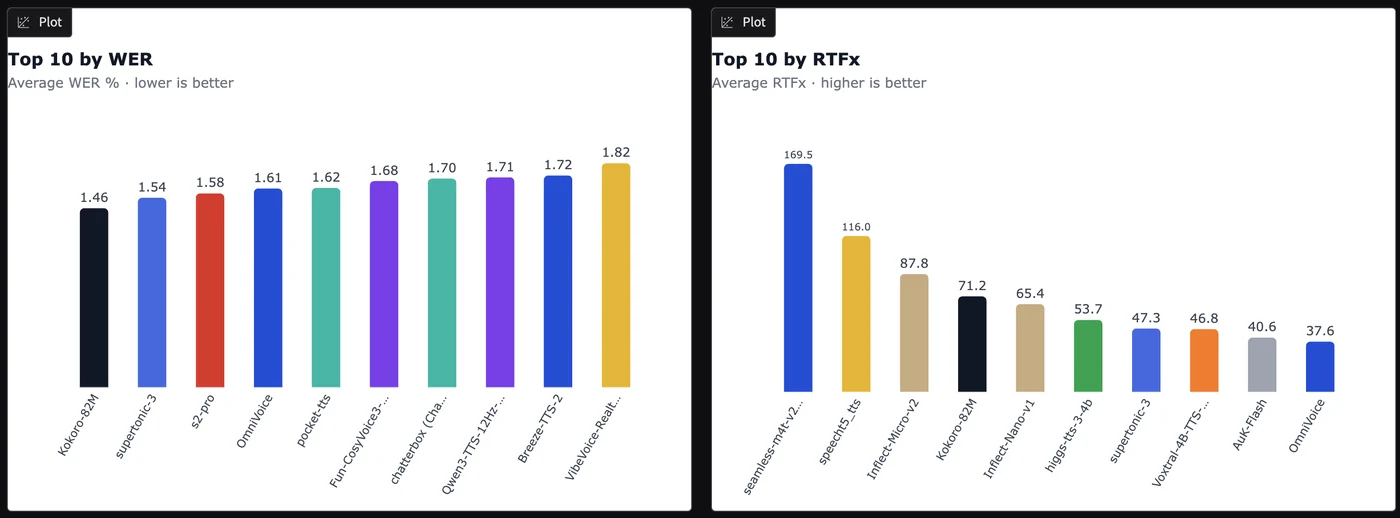
تعتمد لوحة الصدارة الجديدة على مقاييس أداء موضوعية تكمل التقييم البشري بدلاً من أن تعوضه بالكامل، حيث يتم قياس وضوح النطق باستخدام معدلات خطأ الكلمات والحروف استناداً إلى نماذج التعرف الآلي على الكلام، ويجري تقييم السرعة عبر قياس زمن الاستجابة للبث المباشر ومعامل الاستدلال الفعلي على وحدات المعالجة الرسومية.
إلى جانب ذلك، يتم حساب التشابه الصوتي عبر مقارنة التضمينات الصوتية المستخرجة من الأصوات المولدة وتلك الموجودة في المقاطع المرجعية الأساسية، مما يقلل الوقت اللازم لإنجاز التقييم الشامل من أسابيع إلى ساعات معدودة، مع إمكانية الوصول المباشر إلى المنصة عبر رابط TTS leaderboard للاطلاع على النتائج.
تقييم الأداء متعدد اللغات واستنساخ الأصوات
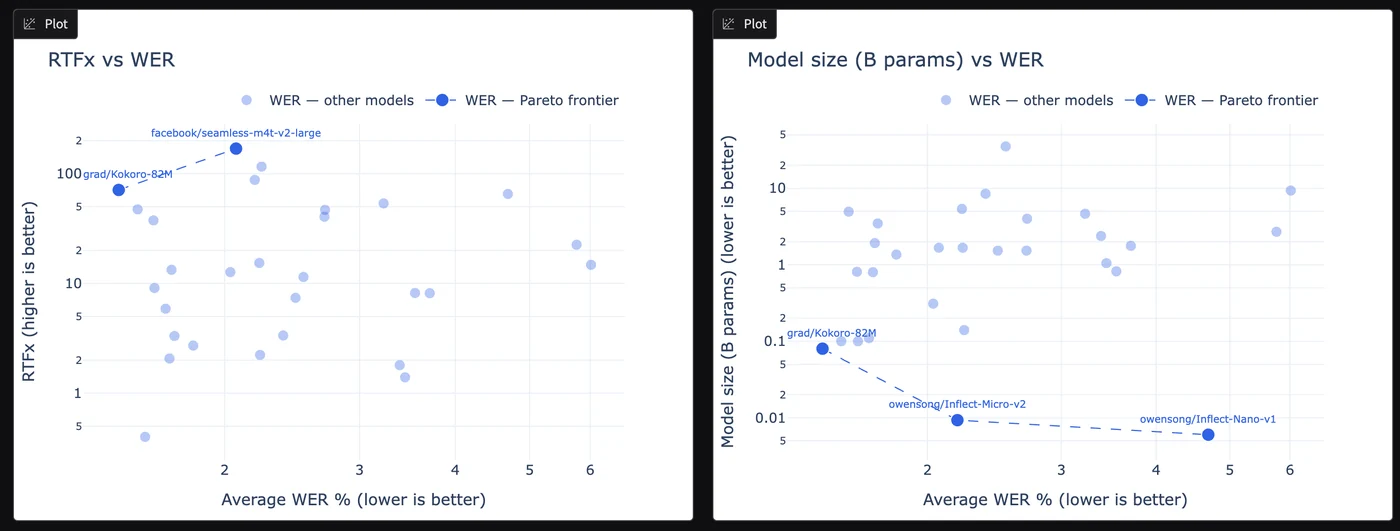
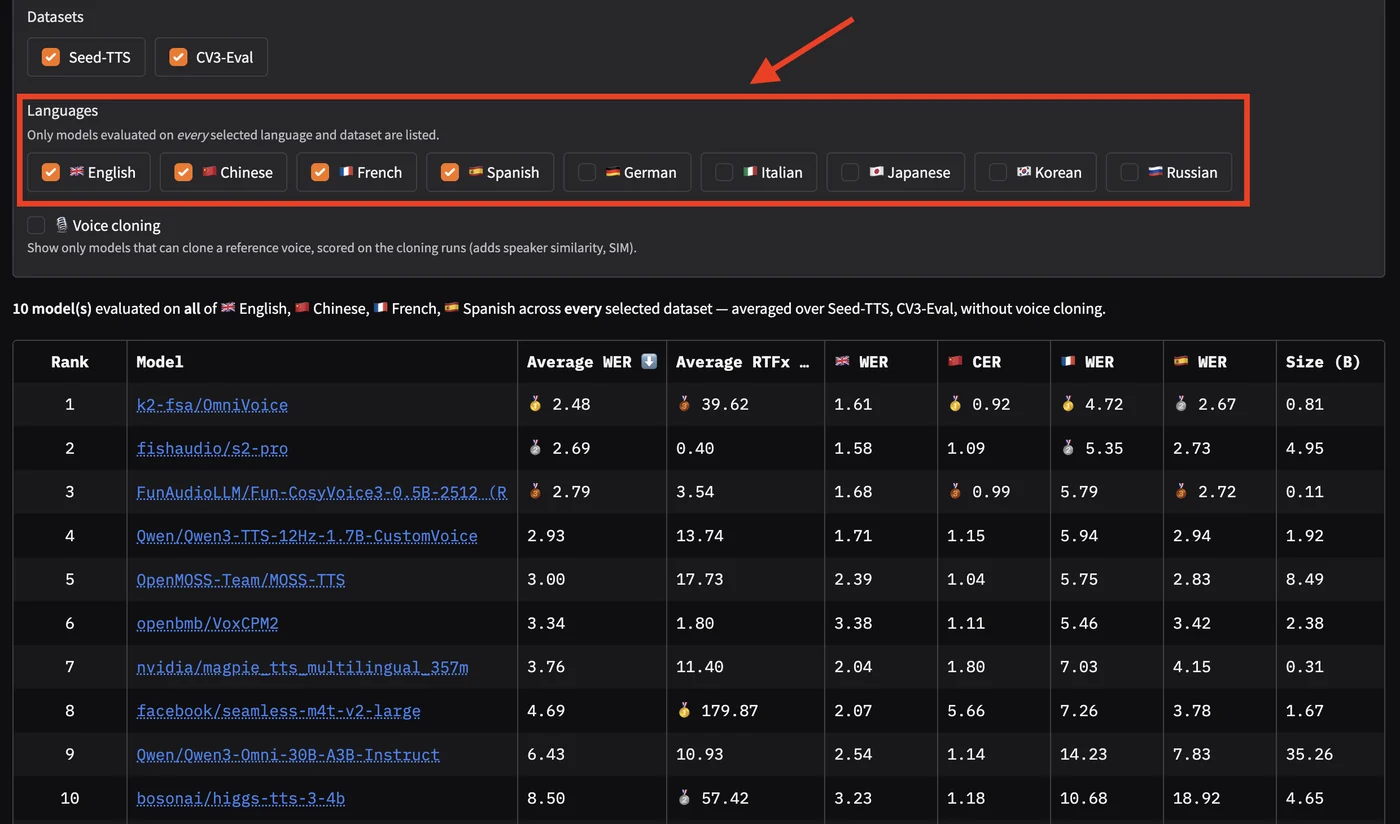
لا يعكس تفوق النماذج في اللغة الإنجليزية بالضرورة كفاءتها في اللغات الأخرى، ولذلك تتيح اللوحة تبديل اللغات لتقييم الأداء متعدد اللغات للنماذج المتاحة، بما في ذلك اللغات المعتمدة على الحروف مثل الصينية واليابانية والكورية حيث يتم الإبلاغ عن معدل خطأ الحروف بدلاً من الكلمات.
كما يمكن للمستخدمين تفعيل خاصية استنساخ الأصوات لمقارنة النماذج الداعمة لهذه الوظيفة، حيث تظهر أعمدة إضافية تقيس مدى دقة التشابه الصوتي، وتتحسن أداء بعض النماذج البارزة بشكل ملحوظ فور تزويد النظام بمقطع صوتي مرجي للإشارة إليه أثناء عملية توليد الكلام.
قدرات البث المباشر واختبارات الأداء التفاعلي
تتضمن اللوحة تبويباً مخصصاً للمقارنة بين قدرات البث المباشر للنماذج، حيث ترتب وفقاً لزمن وصول المقطع الصوتي الأول، وهو مؤشر حاسم لتطبيقات الوكلاء الصوتين والبرمجيات التفاعلية التي تتطلب استجابة فورية، ويتم تشغيل الاختبارات في بيئة موحدة تحاسين ظروف التشغيل وتوفر مقارنات دقيقة على الأجهزة المختلفة.
مشاركة المجتمع واستكشاف النواتج الصوتية
لإتاحة رؤية شاملة تتجاوز مجرد الأرقام المجردة، يوفر قسم الاستماع فرصة استكشاف النواتج الصوتية الكامنة خلف المقاييس الكمية ومقارنة تفضيلات المستخدمين للنماذج المختلفة، مع إمكانية تقديم التعليقات والآراء للمساهمة في تطوير التقييمات المستقبلية بالتعاون مع مجتمع المطورين والمستخدمين المهتمين بتقنيات الذكاء الاصطناعي.
المصادر
- Hugging Face BlogOpen TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning