وحدات TPU من جوجل تعمل رسمياً في مراكز بيانات ميتا
دخلت وحدات معالجة الذكاء الاصطناعي الخاصة بجوجل حيز الإنتاج الفعلي داخل مراكز بيانات ميتا، مدعومة بمحركات استدلال جديدة تتيح تشغيل نماذج PyTorch بشكل أصلي على هذه الرقاقات.
 رضوان عبدالهاديمحرر وكاتب تقني
تشغيل وحدات TPU داخل بيئة إنتاج ميتا
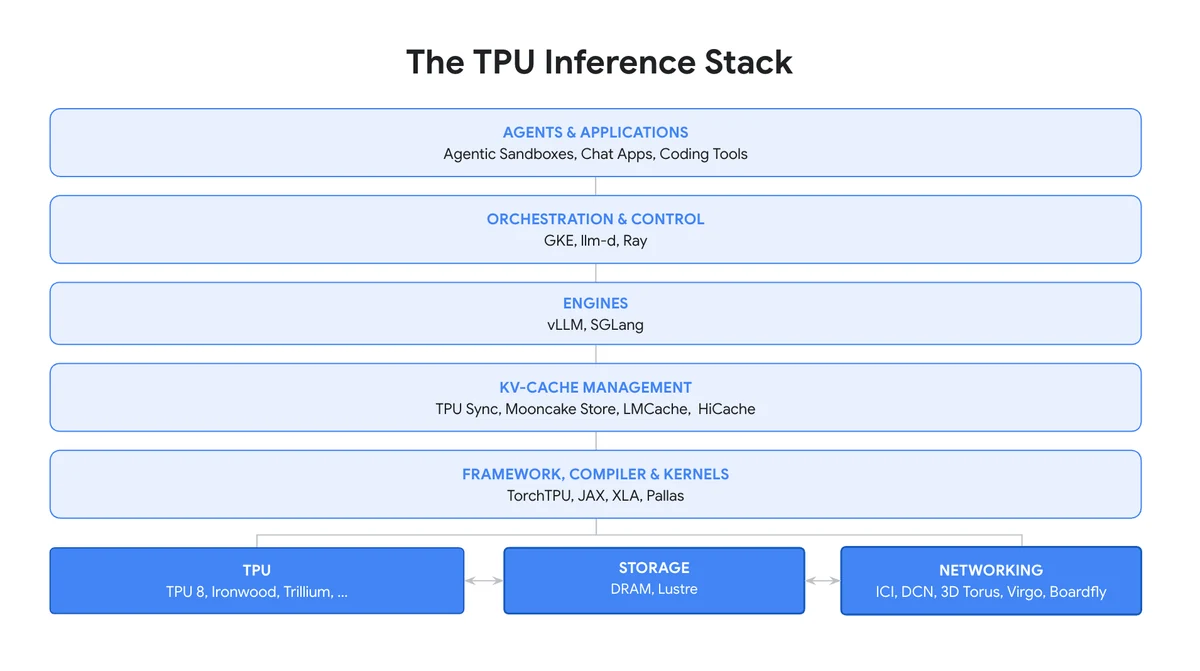
أعلنت المدونات التقنية عن بدء استخدام وحدات المعالجة Tensor المخصصة للذكاء الاصطناعي من شركة Google في بيئة الإنتاج الفعلية لدى شركة Meta، وذلك من خلال نسخة جديدة ومخصصة من محرك الاستدلال SGLang تتوافق أصلياً مع إطار العمل الشهير PyTorch، وفقاً لما نُشر على مدونة مطوري جوجل.
إلى جانب ذلك، أُعلن عن توفير نسخة برمجية متوافقة ومفتوحة المصدر من محرك الاستدلال vLLM الشهير. ويُذكر أن هذه المحركات كانت تعتمد سابقاً على إطار عمل JAX الخاص بجوجل للعمل على وحدات TPU، بينما تمنح النسخ الجديدة المعالجات القدرة على العمل كخيار أصلي لبيئة PyTorch دون الحاجة لتعديلات جذرية في الأكواد.
تعاون هندسي ثلاثي وتقنيات جديدة
أوضح مسؤولو الهندسة في ميتا أن محرك SGLang-TorchTPU يعمل حالياً في الإنتاج بفضل تعاون وثيق استمر بين فرق العمل في ميتا وجوجل ومبتكري المحرك، حيث يتيح هذا الابتكار تكديس عمليات خادم متطورة تتوافق كلياً مع بيئة PyTorch.
وأكدت الإدارة الهندسية لبيئة PyTorch في ميتا أن استراتيجيتهم لا ترغب في الارتباط ببنية عتادية واحدة، مما جعل تطوير حزمة TorchTPU الخطوة الفاعلة التي تتيح نشر أحمال العمل البرمجية مباشرة على رقاقات TPU الخاصة بجوجل.
خلفية العلاقة والتطورات التاريخية
لا تعد هذه الشراكة التجربة الأولى بين الشركتين في استخدام وحدات TPU؛ فقد أشارت تقارير سابقة إلى اعتماد فرق البحث في ميتا على جسر البرمجيات القديم PyTorch/XLA للاتصال بمعالجات TPU في الفترة بين عامي 2020 و2023 قبل توقف تلك العقود المؤقتة.
جاءت جهود جوجل المستمرة لدعم بيئة PyTorch على وحدات TPU موجهة أساساً لتلبية متطلبات ميتا التي كانت ترفض الانتقال الكلي إلى إطار JAX، وتضمنت الترتيبات اللاحقة اتفاقيات إيجار متعددة السنوات لوحدات سحابية تعتمد على هذه المعالجات.
تحدي الهيمنة البرمجية في السوق
تأتي هذه التحركات التقنية الواسعة بالتزامن مع إعلانات مشابهة من شركات كبرى أخرى مثل أمازون، التي كشفت عن إتاحة محركها البرمجي المفتوح المصدر لنظام PyTorch على رقاقات Trainium، في مساعٍ متواصلة لتقليص هيمنة البيئات البرمجية الاحتكارية في السوق.
تسعى هذه الابتكارات الهندسية المتبادلة بين عمالقة التقنية إلى توفير مرونة أكبر للمطورين، وفتح باب المنافسة الحقيقية في قطاع العتاد ومحركات الاستدلال الخاصة بالنماذج اللغوية الكبيرة.
أداء السرعة ومؤشرات التشغيل
أظهرت اختبارات الأداء المبدئية التي أجريت على إعدادات محرك vLLM المجهزة لخدمة نماذج مفتوحة الأوزان تفوقاً ملحوظاً في معدلات إنجاز الرموز عبر الجيل السابع من معالجات TPU، متجاوزة بعض المعايير القياسية المنافسة عند تطبيق أحجام دفعات تشغيل محدودة.
تخطط الفرق الهندسية المشاركة لمواصلة توسيع نطاق النماذج المدعومة وإضافة المزيد من خيارات الاستدلال المتقدمة، مع توقعات بالكشف عن تفاصيل تقنية إضافية خلال المؤتمرات المتخصصة المقبلة.
المصادر
- Tom's HardwareGoogle’s TPUs for AI workloads now run in Meta's data centers
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
Hugging Face تطلق TorchTPU لتشغيل نماذج الذكاء الاصطناعي على TPU
أعلنت Hugging Face عن دعم TorchTPU، مما يتيح تشغيل نماذج Transformers وDiffusers على وحدات معالجة TPU من Google بشكل أصلي وسريع.
جوجل تنضم لأمزون في تحدٍّ جديد لسيطرة إنفيديا على الذكاء الاصطناعي
أطلقت جوجل مشروع TorchTPU مفتوح المصدر لتسهيل نقل تطبيقات PyTorch إلى شرائح TPU الخاصة بها، في خطوة تنافسية مباشرة مع أمزون لكسر احتكار إنفيديا.
إنتل تكشف عن مخطط مفتوح لتحويل نماذج الذكاء الاصطناعي إلى تطبيقات إنتاجية
تقدّم إنتل استراتيجية برمجية مفتوحة تربط معالجات Xeon وبطاقات GPU بنماذج الذكاء الاصطناعي، لتسهيل الانتقال من التجارب إلى بيئات الإنتاج عبر أطر برمجية مألوفة.
إنتل تعلن دعمها الفوري لنموذج Muse Spark Open من ميتا
توفر إنتل دعمًا فوريًا لنموذج Muse Spark Open من ميتا عبر معالجات Xeon وشرائح GPU D-series، مما يتيح تنفيذ نماذج ذكاء اصطناعي ضخمة بكفاءة عالية.