إنتل تعلن دعمها الفوري لنموذج Muse Spark Open من ميتا
توفر إنتل دعمًا فوريًا لنموذج Muse Spark Open من ميتا، مما يتيح تنفيذ نماذج ذكاء اصطناعي ضخمة بكفاءة عالية على معالجات Xeon وشرائح GPU D-series.
 رضوان عبدالهاديمحرر وكاتب تقني
دعم فوري لنموذج ميتا الضخم
أعلنت شركة إنتل عن توفير دعم فوري لنموذج Muse Spark Open، وهو نموذج مفتوح الأوزان من تطوير شركة ميتا. يمثل هذا النموذج، الذي يضم 816 مليار معلمة، خطوة مهمة في مجال الذكاء الاصطناعي متعدد الوسائط، ويُعد من أقوى النماذج المفتوحة الأوزان التي أصدرتها الولايات المتحدة حتى الآن. يتطلب تشغيل معمارية بهذا الحجم كفاءة ذاكرة استثنائية وتسريعًا منخفض الدقة على مستوى العتاد، وهو ما توفره إنتل عبر معالجات Intel® Xeon® ومنصات GPU للمراكز البيانات المعروفة باسم Intel® GPU D-series. ويمكن الرجوع إلى Intel Newsroom للاطلاع على التفاصيل الأصلية للمصدر.
قدرات النموذج في البرمجة والوسائط
صُمم نموذج Muse Spark Open خصيصًا لتحسين مهام البرمجة، حيث يوفر دقة أعلى في المحاولات الأولى وفهمًا عميقًا لقواعد الكود عبر المستودعات التي يستخدمها المطورون. يتيح النموذج نافذة سياق تصل إلى مليون رمز، مما يسمح بمعالجة مشاريع كاملة تتضمن اعتماديات معقدة وأكوادًا قديمة وآلاف الملفات دون الحاجة إلى تقسيم المهام إلى أجزاء أصغر. بالإضافة إلى ذلك، يدعم النموذج فهم الوسائط المتعددة، بما في ذلك الصوت والفيديو والصور والمستندات، مما يجعله أداة قوية للأنظمة الوكيلة التي تتطلب تخطيطًا وتصحيحًا ذاتيًا عبر سير عمل ممتدة. ويمكن الرجوع إلى News للاطلاع على التفاصيل الأصلية للمصدر.
بنية تحتية مصممة للمقياس الضخم
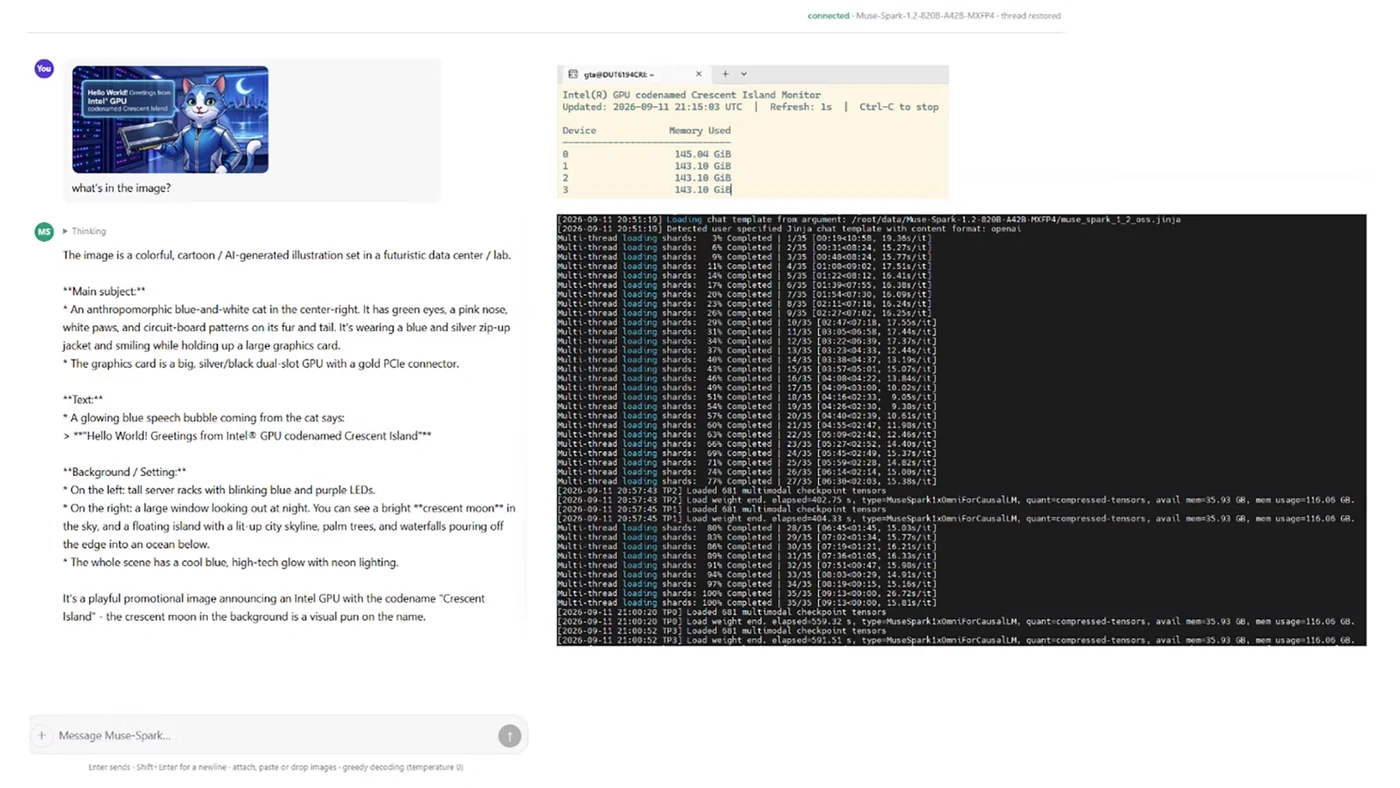
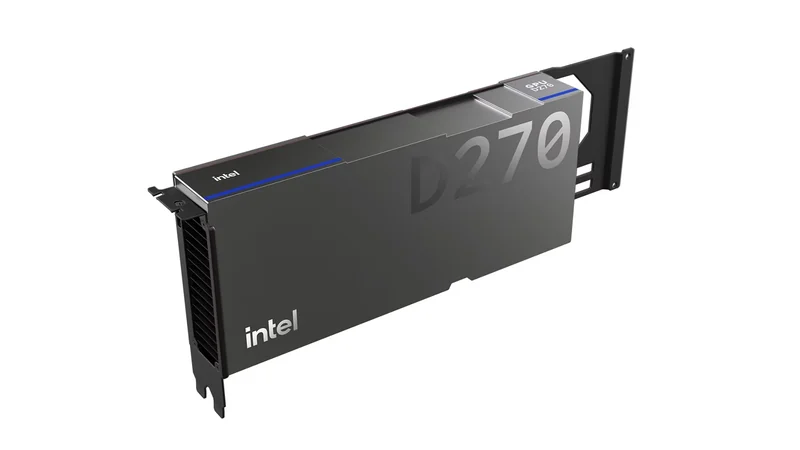
تبرز نماذج اللغة الكبيرة بمقياس Muse Spark Open المتطلبات المتزايدة للبنية التحتية لأحمال عمل الذكاء الاصطناعي المتقدم. تتطلب هذه النماذج سعة ذاكرة كبيرة وحسابات منخفضة الدقة وكفاءة في استهلاك الطاقة. تم اختبار النموذج وتشغيله حاليًا على شريحة GPU القادمة من إنتل، المعروفة باسم Intel® GPU D-series، مما يعكس التزام الشركة بدعم النماذج الناشئة في يومها الأول. توفر هذه الشريحة 160 جيجابايت من الذاكرة لكل وحدة، مما يتيح تشغيل النموذج عبر أربع وحدات GPU، وهو ما يسهل تقييمه على عتاد إنتل مبكرًا.
تقنيات الضغط وكفاءة الذاكرة
لتحقيق أقصى قدر من الكفاءة على عتاد إنتل دون التضحية بالدقة، قامت الشركة بضغط نسخ MXFP4 وINT4 من أوزان النموذج الأصلية باستخدام أداة llm-compressor من vLLM، والتي تعتمد على خوارزمية AutoRound. تحسّن هذه الخوارزمية معاملات التقريب ونطاق القص طبقةً بطبقة، مما يساعد على الحفاظ على قدرات الاستدلال الدقيقة للنموذج حتى عند استخدام عرض بت منخفض للغاية. تستهدف أوزان MXFP4، بصيغة compressed-tensors، تسريع العتاد الأصلي على شريحة Intel® GPU D-series، بينما تدعم أوزان INT4، بصيغة GPTQ، معالجات Xeon في وضع الضغط الأحادي للوزن لتقليل بصمة الذاكرة والانتظار.
تكامل مع أدوات مفتوحة المصدر
تعتمد استراتيجية إنتل على دمج تقنياتها في أدوات مفتوحة المصدر الرئيسية لتسهيل نشر النماذج الضاغطة. توفر vLLM دعمًا كاملًا لأوتاد الضغط مثل MXFP4 وGPTQ، مما يتيح تنفيذ مصفوفات مسرعة بالعتاد وتجميعًا مستمرًا عبر نشرات متعددة العقد. كما توفر SGLang تكاملًا أصليًا لتنفيذ microscaling (MX) ونواة محسنة لـ XPU، مما يقود تجميعًا مستمرًا عالي الإنتاجية واستدلالًا منخفض البت لسير عمل الوكيلة المعقدة متعددة الأدوار. يعمل فريق إنتل عن كثب مع مجتمع vLLM لإضافة وصفات مخصصة لمعالجات Xeon، مما يوفر مسارًا عمليًا للفرق الهندسية في المؤسسات.
خيارات التنفيذ على معالجات Xeon
تقدم معالجات Intel® Xeon® نهجًا بديلًا للاستدلال غير المتصل (Offline Inference) لنموذج Muse Spark Open. تدعم هذه المعالجات الاستدلال المضغوط أحادي الوزن INT4، مما يقلل من بصمة الذاكرة مع الاستفادة من Intel® Advanced Matrix Extensions (Intel® AMX) لتسريع عمليات المصفوفات في الذكاء الاصطناعي. بالنظر إلى حجم النموذج، توفر معالجات Xeon مسارًا عمليًا للاستفادة من سعات الذاكرة النظامية الكبيرة، مما يتيح للمؤسسات تشغيل الأحمال الخاصة بها بشكل خاص وتكرار النشر عبر بنية مراكز البيانات الحالية القائمة على معالجات Xeon.
المصادر
- Intel NewsroomIntel Offers Day-0 Support for Meta's Muse Spark Open
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
إنتل تكشف عن مخطط مفتوح لتحويل نماذج الذكاء الاصطناعي إلى تطبيقات إنتاجية
تقدّم إنتل استراتيجية برمجية مفتوحة تربط معالجات Xeon وبطاقات GPU بنماذج الذكاء الاصطناعي، لتسهيل الانتقال من التجارب إلى بيئات الإنتاج عبر أطر برمجية مألوفة.
Intel تكشف عن بنية تحتية مفتوحة لتسريع عصر الذكاء الاصطناعي الوكيل
كشفت Intel عن معالجات Xeon وأجهزة GPU D-series لدعم الذكاء الاصطناعي الوكيل، مع تركيز على الكفاءة والبنية المفتوحة لتلبية الطلبات المتزايدة.
ميتا تطلق نموذج Muse Spark Open مفتوح الأوزان يعمل على أجهزة ماك
أعلنت ميتا عن إطلاق نموذج Muse Spark Open، وهو نموذج ذكاء اصطناعي مفتوح الأوزان مصمم خصيصاً للعمل محلياً على أجهزة ماك، بالتعاون مع شركة آبل.
ميتا تكشف عن نموذج Muse Spark Open مفتوح الأوزان لأجهزة ماك
أطلقت شركة ميتا نموذج Muse Spark Open المصمم لأجهزة Apple Silicon، والذي يتطلب 1 تيرابايت من ذاكرة الوصول العشوائي للتشغيل محلياً، متفوقاً على نماذج صينية رائدة.