أمازون تكشف آلية جديدة لتقييم نماذج الذكاء الاصطناعي عبر SageMaker
أطلقت أمازون ويب سيرفيسز تحسينات جديدة على منصة SageMaker JumpStart تتيح للمطورين نشر نماذج الذكاء الاصطناعي وتقييم أدائها بدقة وكفاءة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحديثات 2026 في مكتبة النماذج
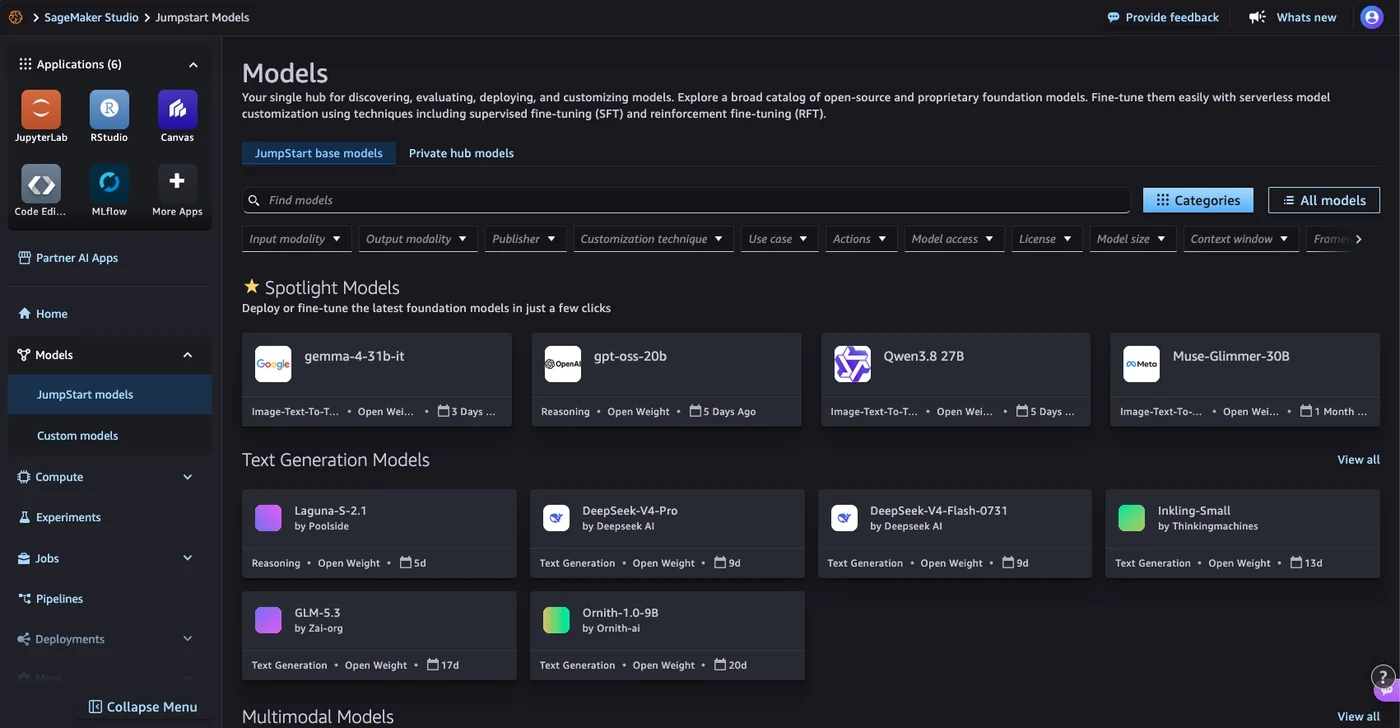
أدخلت أمازون ويب سيرفيسز تحسينات جوهرية في عام 2026 على قسم Model Hub داخل وحدة تحكم Amazon SageMaker AI. تتيح هذه التحديثات للمستخدمين تصفح كتالوج Amazon SageMaker JumpStart الذي يضم مجموعة واسعة من النماذج المدربة مسبقاً. كما أصبح بإمكان المطورين عرض دفاتر ملاحظات (Notebooks) تجريبية وفتحها مباشرة داخل بيئة SageMaker Studio، مما يبسط عملية الاستكشاف الأولي للنماذج. ويمكن الرجوع إلى AWS Machine Learning Blog للاطلاع على التفاصيل الأصلية للمصدر.
خيارات نشر مخصصة للأداء
من أبرز الميزات الجديدة هي توفر خيارات نشر لنقاط النهاية (Endpoints) مُهيأة مسبقاً. توفر هذه الإعدادات أسماء محددة محسنة لأولويات مختلفة، مثل تقليل التكلفة أو خفض زمن الاستجابة (Latency) أو التعامل مع أعباء العمل العامة. تشمل هذه الخيارات نماذج الذكاء الاصطناعي التوليدي، مع توفر إعدادات محسمة لمعالجات Neuron، مما يمنح المطورين مرونة أكبر في اختيار البنية التحتية المناسبة لتطبيقاتهم.
تكامل مباشر مع Hugging Face
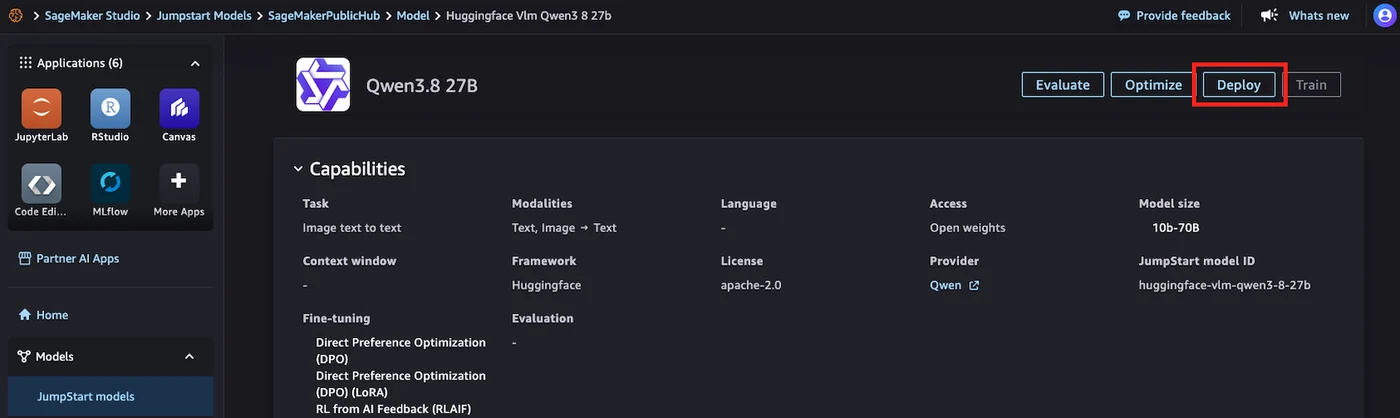
أضافت أمازون ميزة التكامل العميق (Deep Link Integration) التي تسمح للمستخدمين بالانتقال من اكتشاف النماذج على منصة Hugging Face إلى نشرها في SageMaker AI بنقرة واحدة. هذا التكامل يقلل من الخطوات اليدوية المطلوبة لنقل النماذج بين المنصات، مما يعزز سرعة تطوير التطبيقات المعتمدة على نماذج مفتوحة المصدر أو مجتمعية.
منهجية التقييم بالأداء
يقدم المقال منهجية عملية تعتمد على سكربت بايثون قابل لإعادة الاستخدام لتنفيذ ثلاث خطوات رئيسية: اكتشاف النموذج ونشره، ثم تشغيل أوامر تجريبية (Prompts) محددة لقياس الأداء، وأخيراً حذف نقطة النهاية بعد اكتمال الاختبار. تتيح هذه المنهجية إجراء اختبارات أداء خفيفة وقابلة للتكرار، مما يضمن دقة المقارنة بين النماذج المختلفة دون استهلاك موارد غير ضرورية.
قياس المؤشرات الرئيسية
تعتمد المنهجية على قياس مؤشرات محددة مثل زمن الاستجابة (Latency)، والطول التقريبي للمخرجات، ومعدل التوليد لكل طلب. باستخدام أوامر اختبار متسقة، يمكن للمطورين مقارنة خيارات متعددة واختيار النموذج الذي يحقق التوازن الأمثل بين جودة المخرجات وسرعة الاستجابة والتكلفة التشغيلية. هذه المقارنات تساعد في اتخاذ قرارات مستنيرة عند اختيار النموذج النهائي للتطبيق الإنتاجي.
المتطلبات التقنية والتراخيص
لتطبيق هذه المنهجية، يتطلب الأمر حساب AWS بترخيصات SageMaker AI، وتثبيت مكتبة SageMaker Python SDK الإصدار الثالث أو الأحدث. كما يجب التأكد من توفر حصة كافية لمعالجات GPU المناسبة للنموذج المراد اختباره، أو طلب زيادة في الحصة عبر الوثائق الرسمية. تجدر الإشارة إلى أن صيغ البيانات (Payloads) ومتطلبات تراخيص المستخدم النهائي (EULA) قد تختلف من نموذج لآخر، مما قد يتطلب تعديلات محددة في السكربت.
مصادر إضافية للتعمق
للمهتمين بتفاصيل أعمق حول تحسين الأداء، توفر أمازون مقالات تقنية إضافية تشرح كيفية إجراء اختبارات المعيار (Benchmarking) وتحسين نشر نقاط النهاية في SageMaker JumpStart. كما يمكن الرجوع إلى وثائق SDK الرسمية للحصول على تفاصيل برمجية دقيقة حول كيفية تفاعل السكربتات مع واجهات برمجة التطبيقات الخاصة بالمنصة.
المصادر
- AWS Machine Learning BlogDeploy and evaluate models with Amazon SageMaker JumpStart
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
نشر نماذج Hugging Face على SageMaker AI باستخدام وكلاء البرمجة
تعرّف على كيفية نشر نماذج Hugging Face عبر أمازون SageMaker AI باستخدام تقنيات وكلاء البرمجة الذكية لضمان بيئات عمل احترافية ومستقرة.
عقود تكامل نماذج ترانسفورمرز لتعزيز جودة الذكاء الاصطناعي
تستعرض مدونة Hugging Face معايير جديدة لعقود تكامل نماذج الذكاء الاصطناعي تسمى Transformers Model Integration Contracts لاكتشاف الأخطاء.
AWS تتيح الوصول المباشر إلى SageMaker Studio بتسجيل اجتماعي مبسّط
أطلقت AWS تجربة تسجيل جديدة تتيح للمطورين الوصول إلى بيئة SageMaker Studio خلال دقائق باستخدام حسابات Google أو GitHub، مع 100 دولار كريدت مجاني دون بطاقة ائتمانية.
أمازون: قياسات دقيقة لسياسات التوسع التلقائي في نماذج النطق
تقدم أمازون ويب سيرفيسز نهجاً جديداً لتجنب التخمين في سياسات التوسع التلقائي لنماذج تحويل النص إلى كلام، عبر قياسات حية تضمن كفاءة الأداء وتقليل التكاليف.