أمازون: قياسات دقيقة لسياسات التوسع التلقائي في نماذج النطق
تستبدل أمازون التخمين في سياسات التوسع التلقائي لخدمات الذكاء الاصطناعي بقياسات دقيقة تعتمد على الأداء الفعلي للنماذج.
 رضوان عبدالهاديمحرر وكاتب تقني
تجاوز أخطاء التخمين في التوسع التلقائي
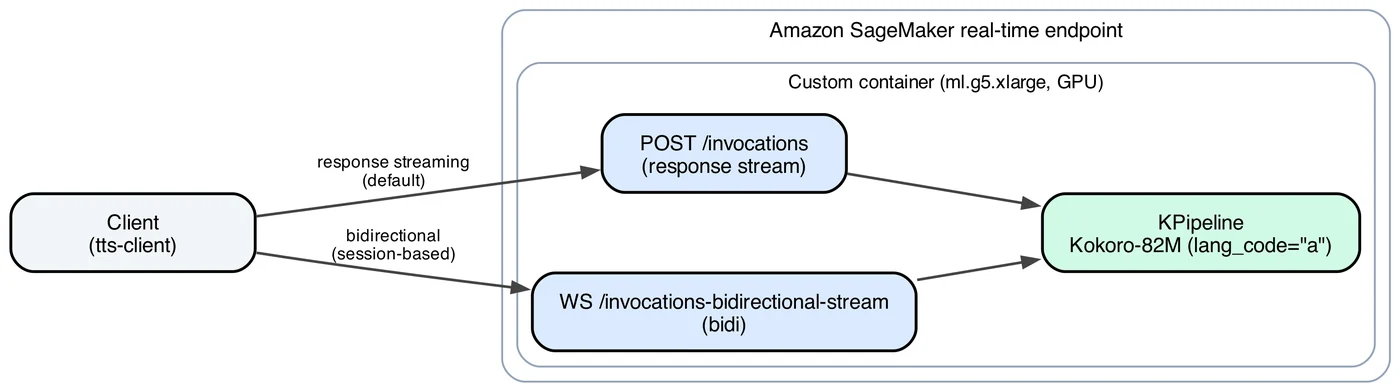
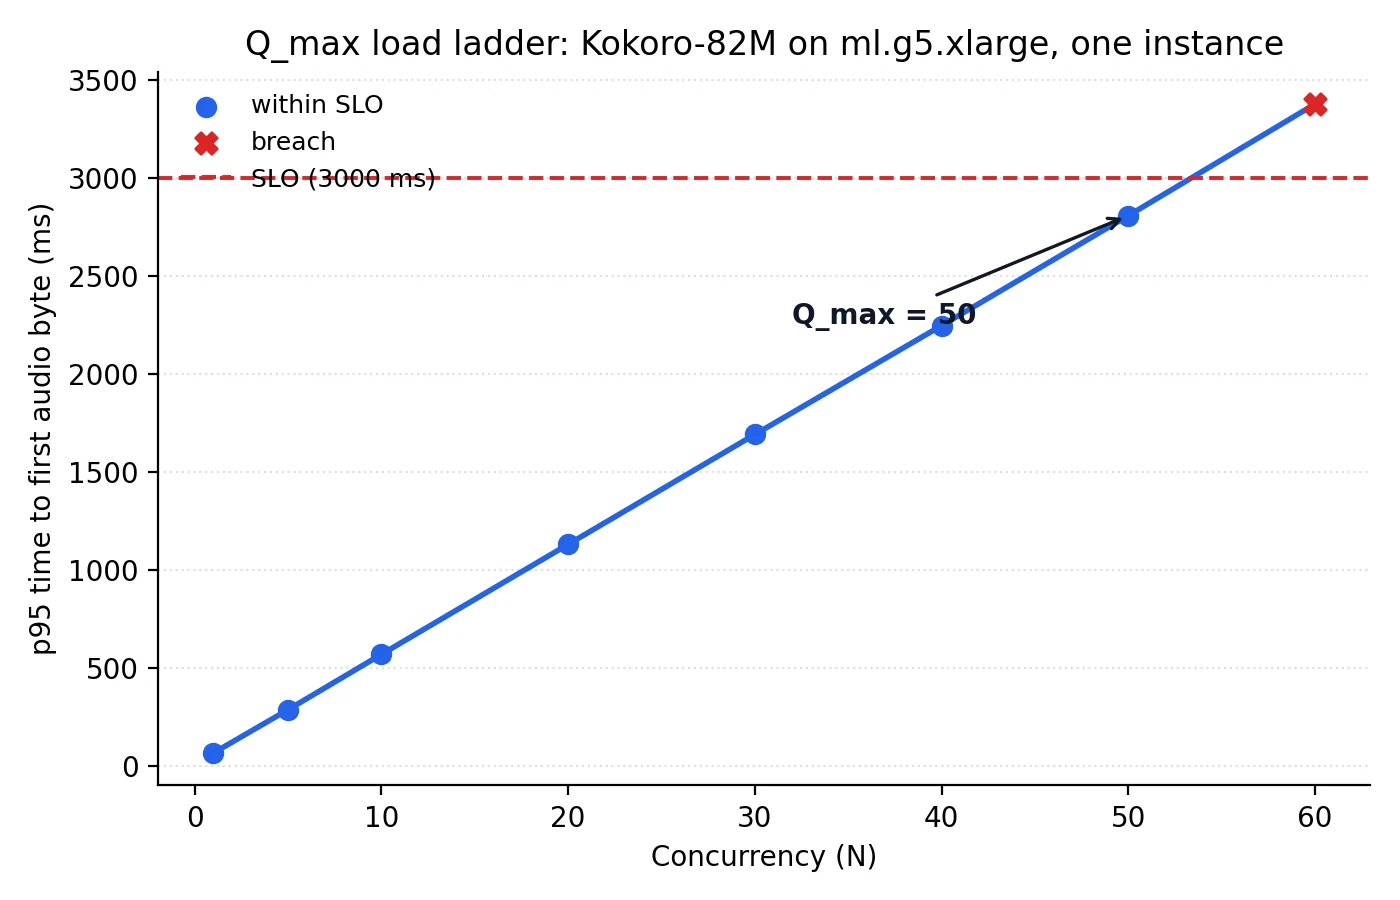
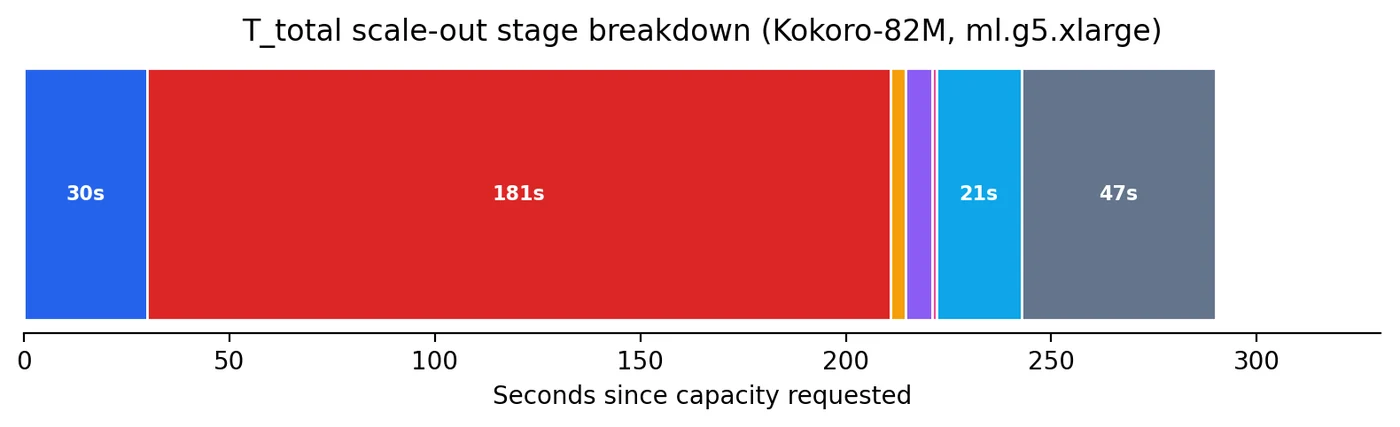
تواجه فرق التطوير التي تنشر نماذج تحويل النص إلى كلام مخصصة على Amazon SageMaker AI تحدياً حقيقياً عند ضبط عتبات التوسع التلقائي. غالباً ما يعتمد المهندسون على التخمين لتحديد هذه العتبات، مما يؤدي إما إلى إهدار نفقات وحدات معالجة الرسوميات (GPU) أو إلى تجاوز أهداف مستوى الخدمة (SLO) المتعلقة بالزمن المستجيب. في هذا السياق، تقدم أمازون ويب سيرفيسز نهجاً جديداً يعتمد على القياسات الفعلية بدلاً من التخمين، حيث يتم نشر نموذج Kokoro-82M كحاوية مخصصة على نقطة نهاية مباشرة، ثم اشتقاق سياسة توسع تلقائي دقيقة بناءً على قياسين حيين: أقصى حد للتزامن (Q_max) والوقت الكلي للتوسع (T_total).
لماذا لا تعمل المقاييس الافتراضية مع النطق
تختلف متطلبات نماذج تحويل النص إلى كلام عن نماذج اللغة الكبيرة التقليدية، حيث لا تعتمد على توليد الرموز (tokens) واحدة تلو الأخرى، بل تنتج العبارة الكاملة في مسار واحد متزامن. نموذج Kokoro-82M، وهو مشتق من StyleTTS2، يعمل بشكل غير تكراري (non-autoregressive) ولا يحتوي على حلقة توليد يمكن ربطها بمقاييس الأداء التقليدية. لذلك، يعتمد الحل المقترح على مقياس ConcurrentRequestsPerModel الذي توفره Amazon SageMaker AI تلقائياً، مما يزيل الحاجة إلى إعدادات مخصصة قد تفشل في النشر الفعلي. يتم قياس هذا المقياس على نافذة زمنية من 10 ثوانٍ، مع مراعاة الفرق بين متوسط عدد الطلبات المتزامنة والقيمة القصوى، لضمان دقة التحويل إلى وحدات CloudWatch.
البنية التحتية والنشر عبر AWS CDK
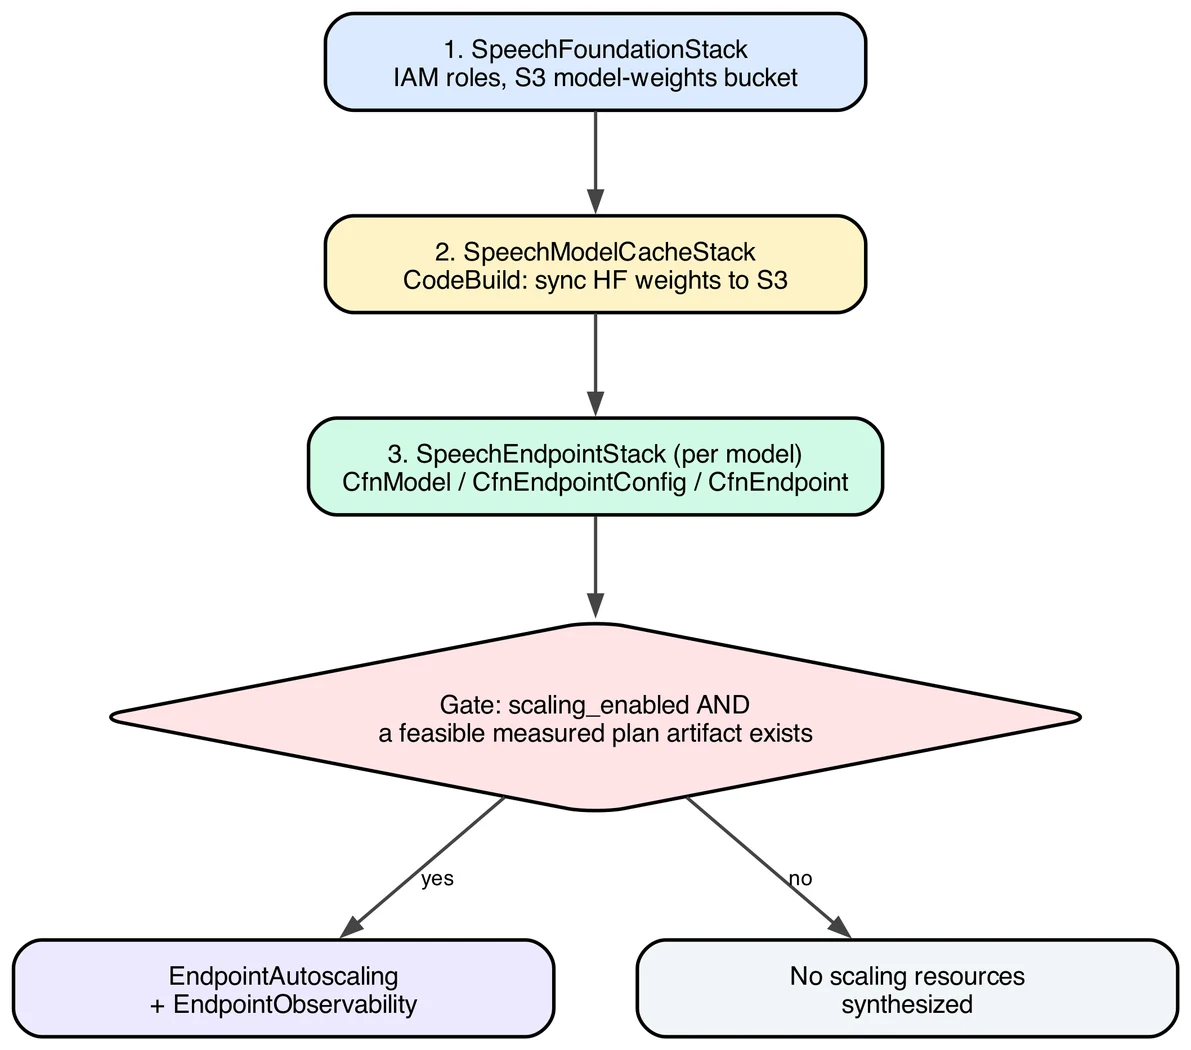
يعتمد النشر على ثلاث طبقات من أكواد AWS Cloud Development Kit (AWS CDK) لضمان دقة الإعدادات ومنع وصول أي تكوين غير مقاس إلى بيئة الإنتاج. الطبقة الأولى تنشئ أدوار IAM وخزانات Amazon S3 لتخزين أوزان النموذج، بينما تزامن الطبقة الثانية أوزان النموذج من Hugging Face إلى الخزان. أما الطبقة الثالثة فتبني صورة الحاوية المخصصة وتقوم بنشرها إلى Amazon ECR، مع إنشاء نموذج Amazon SageMaker AI ونقطة النهاية. تتضمن هذه الطبقة بوابة منطقية تمنع تفعيل موارد التوسع التلقائي إلا بعد وجود خطة قياسات فعلية، مما يضمن أن كل رقم في السياسة مشتق من أداء حقيقي.
متطلبات التنفيذ والقياسات الحية
يتطلب تنفيذ هذا الحل حساباً في AWS بصلاحية إنشاء الموارد الأساسية، بالإضافة إلى أدوات مثل Python 3.11 وuv وDocker لبناء صورة الحاوية. كما يتطلب توفر حصة خدمة من نوع ml.g5.xlarge مع سعة إضافية كافية لإجراء قياسات التوسع. يتم قياس Q_max كأعلى حد للتزامن يمكن لمعالج واحد تحمله دون تجاوز أهداف مستوى الخدمة، بينما يقيس T_total المدة الزمنية الكاملة لعملية التوسع من البداية إلى النهاية. تعتمد هذه القياسات على أداة مخصصة تقيس كلاً من المقياس الأصلي من CloudWatch والقياس المباشر من العميل، ثم تحسب النسبة بينهما لتحويل العتبات إلى وحدات قابلة للنشر. في حالة نموذج Kokoro-82M، جاءت النسبة 1.0، مما يعني تطابق القياسين مباشرة.
النتائج والتوصيات الأمنية
يوفر هذا النهج سياسة توسع تلقائي دقيقة ومبنية على بيانات فعلية، مما يقلل من مخاطر إهدار الموارد أو تدهور الأداء أثناء ذروات الطلب. ومع ذلك، تحذر أمازون من أن الحاوية النموذجية تستخدم إصداراً قديماً من PyTorch يحتوي على ثغرة أمنية معروفة (PYSEC-2026-2286)، والتي تم إصلاحها في الإصدار 2.10.0. لذلك، يُنصح بمراجعة وترقية هذا الإصدار قبل أي استخدام خارج نطاق إثبات المفهوم. يمكن للمطورين الوصول إلى الكود المصدري الكامل والأدوات المستخدمة في المستودع الرسمي على GitHub، مما يتيح لهم تكرار التجربة وتكييفها مع احتياجاتهم الخاصة.
المصادر
- AWS Machine Learning BlogStop guessing auto scaling targets for TTS on Amazon SageMaker AI
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
تقنية Kokoro TTS على Amazon SageMaker AI لتقليل زمن الاستجابة
تعرف على كيفية دمج نموذج Kokoro-82M مع Amazon SageMaker AI لبث الصوت من وكلاء الذكاء الاصطناعي وتقليل التأخير الزمني بشكل ملحوظ للمستخدمين.
نشر نماذج Hugging Face على SageMaker AI باستخدام وكلاء البرمجة
تعرّف على كيفية نشر نماذج Hugging Face عبر أمازون SageMaker AI باستخدام تقنيات وكلاء البرمجة الذكية لضمان بيئات عمل احترافية ومستقرة.
إدارة التوسع التلقائي لنقاط نهاية Amazon SageMaker AI بـ CDK
استكشف كيفية استخدام AWS CDK وموارد CloudFormation المخصصة لإدارة التوسع التلقائي لنقاط نهاية Amazon SageMaker AI وتجاوز فشل النشر.
أمازون تكشف آلية جديدة لتقييم نماذج الذكاء الاصطناعي عبر SageMaker
تتيح أمازون ويب سيرفيسز الآن نشر نماذج الذكاء الاصطناعي وتقييم أدائها بسرعة عبر SageMaker JumpStart، مع أدوات قياس الأداء وحذف نقاط النهاية تلقائياً.