StateBench يكشف حدود نماذج الذكاء الاصطناعي في تتبع التغيرات الطويلة
أظهرت اختبارات جديدة أن النماذج المتقدمة تفشل في مهام تتبع الحالة المعقدة عندما تزداد طول المدخلات، مما يسلط الضوء على قيود معمارية أساسية.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق معيار StateBench لتقييم التتبع الطويل
أعلنت مؤسسة Ai2 عن إطلاق StateBench، وهو معيار مصمم خصيصاً لقياس قدرة نماذج اللغة على تتبع التغيرات في حالة الكيانات عبر مستندات طويلة. يهدف هذا المعيار إلى فهم كيف تحافظ النماذج على دقة المعلومات عندما تتطور الأحداث أو تتغير القيم عبر فترات زمنية أو نصية ممتدة، وهو تحدٍ أساسي في تطبيقات مثل قراءة الكود أو متابعة القصص المعقدة. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
يبرز أهمية هذا المعيار في تمييزه بين أنواع مختلفة من صعوبة تتبع الحالة. فبينما قد تكفي بعض المهام في العثور على آخر تحديث لقيمة معينة، تتطلب مهام أخرى أكثر تعقيداً تتبع سلسلة من التغييرات المترابطة، حيث يؤدي تفويت خطوة واحدة إلى خطأ في النتيجة النهائية. هذا التمييز ضروري لفهم القدرات الحقيقية للنماذج في بيئات العمل الواقعية.
أربعة مستويات صعوبة مستوحاة من البرمجة
يتكون StateBench من أربعة مستويات صعوبة تسمح بعمليات تحديث حالة متزايدة التعقيد. يمكن فهم هذه المستويات من خلال تشبيهات برمجية: المستوى الأول (R-trivial) يعتمد على إسناد قيم ثابتة لا تتغير، مما يتطلب من النموذج استرجاع القيمة الأولية فقط. المستوى الثاني (Aperiodic) يسمح بإعادة الإسناد بالقيمة، حيث يجب على النموذج تحديد أحدث قيمة وتجاهل السابقة،类似于 ضبط درجة حرارة التكييف.
يتطلب المستوى الثالث (Soluble) تحديثات ذاتية المرجعية، حيث تُبنى كل تحديث على القيمة الحالية، مما يشبه احتساب النقاط في لعبة رياضية. أما المستوى الرابع والأصعب (General finite) فيضيف الإسناد بالمرجع، حيث يمكن لمتغير أن يأخذ قيمة متغير آخر، مما يخلق اعتماديات معقدة تشبه تتبع كرة مخفية تحت أكواب يتم تبديل مواقعها باستمرار.
قيود نظرية في بنية Transformers
تواجه نماذج Transformers قيوداً نظرية موثقة جيداً في التعامل مع متغيرات الحالة ذات السلاسل الطويلة من الاعتماديات. هذه القيود هي ما دفع الباحثين لتطوير بنى بديلة وهجينة، مثل Gated DeltaNet، التي تحمل ذاكرة تشغيلية متقدمة. بينما ركزت الاختبارات السابقة على أصعب الحالات، يهدف StateBench إلى فهم الفروق الدقيقة بين البنى المختلفة عبر طيف كامل من الصعوبات، وليس فقط في الحالات القصوى.
تستند هذه المستويات إلى نظرية Krohn–Rhodes، وهي فرع من الجبر يصف كيفية تفكيك مشكلات تتبع الحالة إلى بدائيات ذرية. يمثل كل مستوى في التسلسل الهرمي للمعيار فئة من المشكلات التي يمكن بناؤها من مجموعة مختلفة من هذه البدائيات، مما يوفر إطاراً نظرياً قوياً للمقارنة بين القدرات الحسابية المختلفة.
اختبار النماذج المفتوحة المصدر
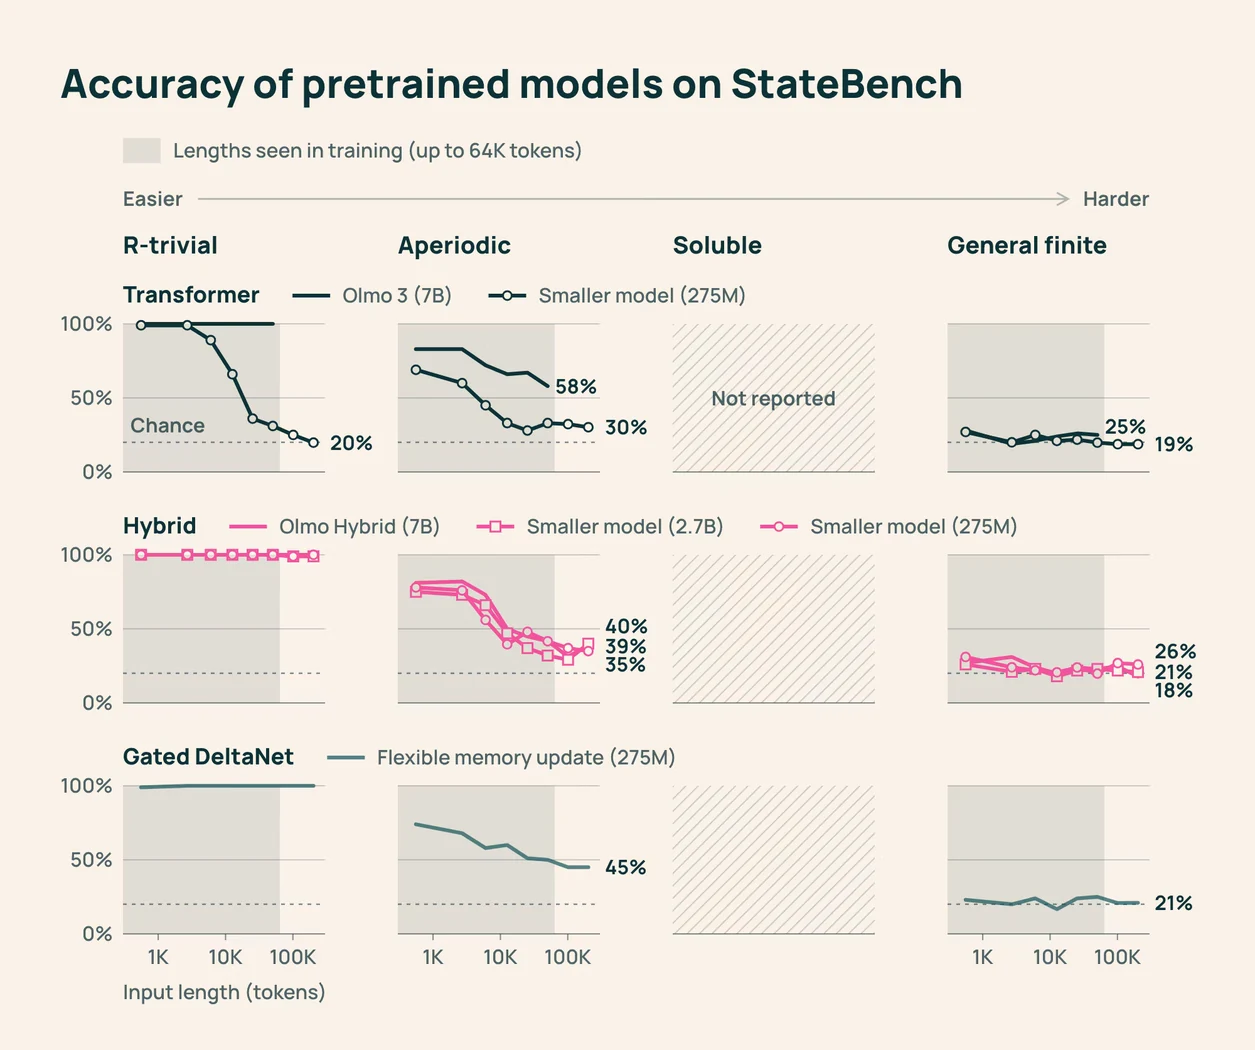
اختبرت الفريق مجموعة من النماذج المفتوحة المصدر المسبقة التدريب على مستويات StateBench المختلفة. شملت هذه النماذج Olmo 3 (بنية Transformer) وOlmo Hybrid (الذي يضيف طبقات Gated DeltaNet)، بالإضافة إلى نماذج أصغر حجماً. جميع هذه النماذج تم تدريبها على نفس البيانات، ولم تتعرض لأي سياق أطول من 64,000 توكن خلال مرحلة التدريب، بينما اختُبرت على مدخلات تتجاوز هذه الطول بكثير.
أظهرت النتائج أن معظم النماذج أدت أداءً جيداً في المشكلات البسيطة (R-trivial)، لكن دقتها انخفضت في المشكلات الدورية (Aperiodic) مع زيادة طول المدخلات، وبقيت عند مستوى الصدفة في المشكلات العامة. كما لاحظ الباحثون أن صيغة المشكلة تؤثر بشكل كبير على الأداء؛ فبينما حققت بعض النماذج درجات عالية في صيغ RULER، فشلت في صيغ تحرير جداول البيانات لنفس المشكلات.
أداء النماذج الرائدة في المهام الصعبة
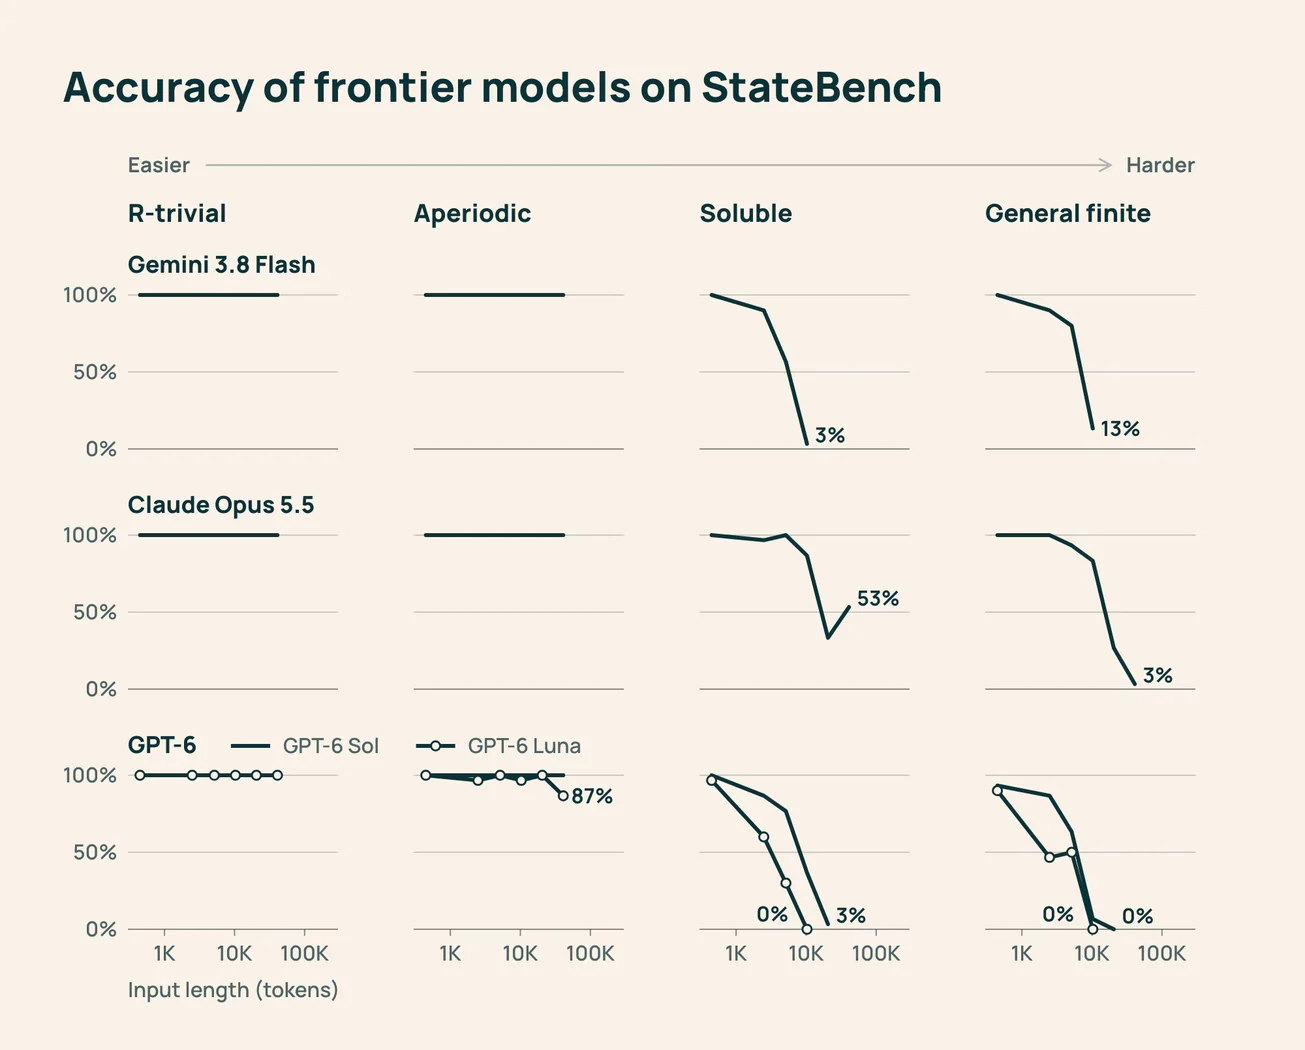
اختُبرت أربعة نماذج رائدة، بما في ذلك Gemini 3.8 Flash وClaude Opus 5.5 وGPT-6 Sol وLuna، على قراءة سلاسل الإسناد وتوليد القيم النهائية للمتغيرات. أظهرت جميع هذه النماذج أداءً قوياً في المستويين البسيط والدوري. ومع ذلك، انخفضت الدقة بشكل حاد في المستويين القابلين للذوبان والعامة مع زيادة طول المدخلات، لتصل إلى 13% أو أقل في أطول المشكلات العامة.
يعزى هذا التراجع جزئياً إلى الحساسية العالية في المستويات الصعبة، حيث يمكن أن تؤثر خطوات أكثر بكثير على النتيجة النهائية. هذا يقلل من هامش الخطأ المسموح به للنموذج، مما يجعل أي تفويت لتحديث واحد كافياً لإنتاج إجابة خاطئة تماماً. هذه النتائج تشير إلى أن الطول وحده ليس التحدي الوحيد، بل تعقيد الاعتماديات هو العامل الحاسم.
التدريب المباشر يكشف حدود البنية
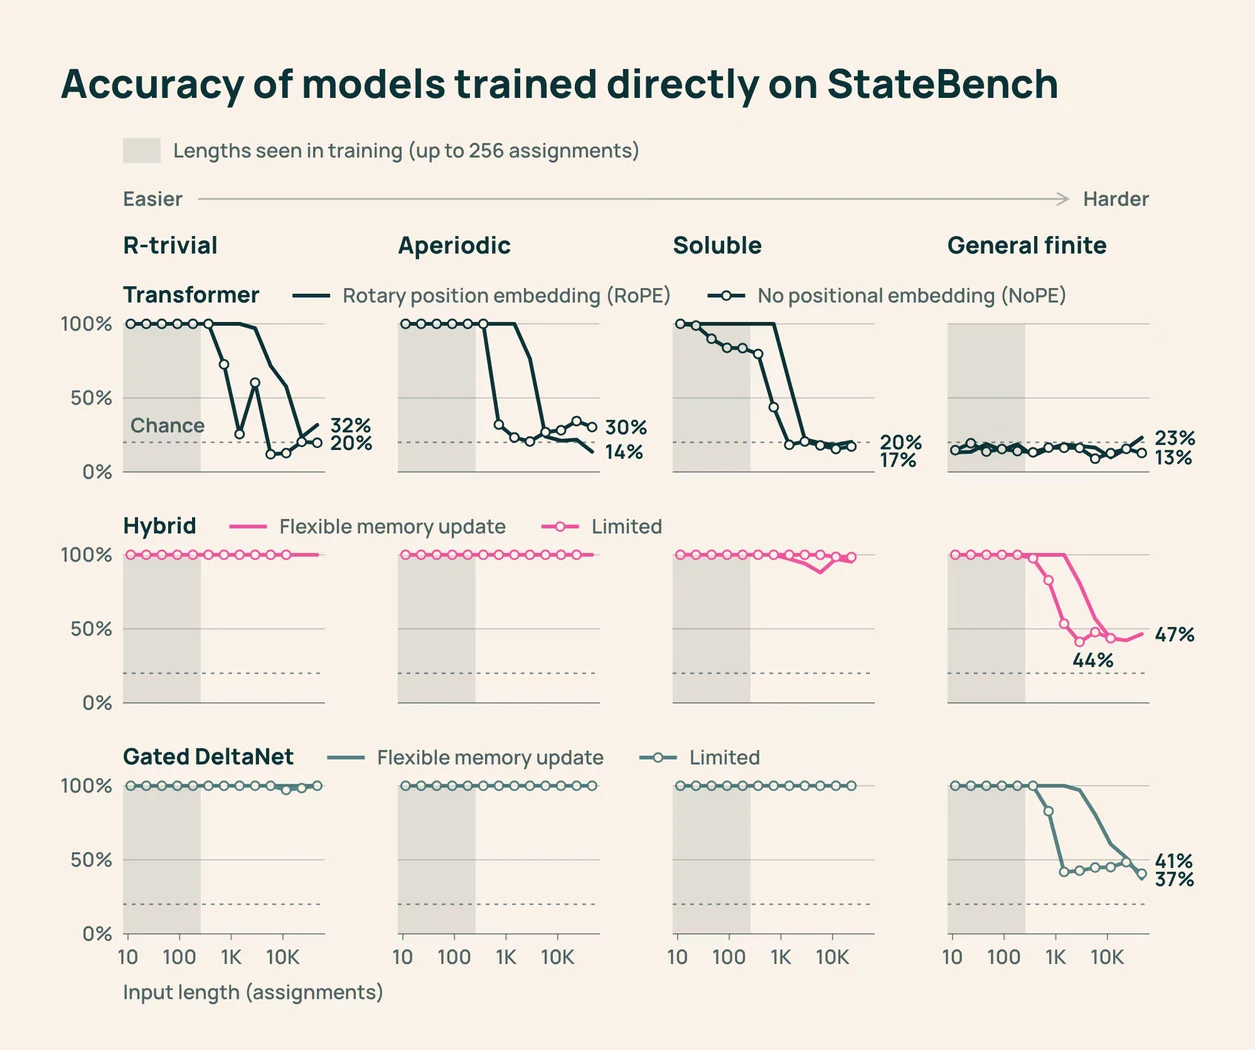
لتحديد ما إذا كانت الصعوبات التي تواجهها النماذج في المستويات العليا ناتجة عن حدود البنية المعمارية نفسها، أم عن قصور في بيانات التدريب المسبق، أجرى الباحثون تجارب تدريب مباشر مستهدف. يُعتبر هذا الإعداد أكثر ملاءمة لكشف الدرجة التي تأتي منها مشاكل تتبع الحالة من البنية التحتية والمُحسِّن (Optimizer) بدلاً من البيانات المستخدمة في التدريب المسبق.
أظهرت النتائج أن النماذج العودية والهجينة يمكنها التعميم لمسافات أبعد بكثير من Transformers عندما يتم تدريبها مباشرة على هذه المهام. هذا يؤكد أن الفجوة في الأداء ليست دائماً بسبب نقص البيانات، بل قد تكون مرتبطة بالقدرة الحسابية الجوهرية للبنية في إدارة الذاكرة والتبعيات الطويلة. توفر هذه الرؤى إرشادات قيمة للمطورين عند اختيار البنى المناسبة لتطبيقات السياق الطويل.
المصادر
- Hugging Face BlogStateBench: Testing how language models track state changes over long documents
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
FairStress يكشف تحيزات خفية في قرارات نماذج الذكاء الاصطناعي
أطلقت مؤسسة Ai2 معيار FairStress الجديد لقياس العدالة السكانية في نماذج اللغة الكبيرة، كاشفةً عن تحيزات خفية تظهر عند اختبار استقرار القرارات أمام الحجج المضادة.
دراسة Ai2 تكشف عدم موثوقية نماذج الذكاء الاصطناعي في تقييم حداثة الأفكار البحثية
أطلقت Ai2 معياراً جديداً يوضح أن تغييرات طفيفة في التعليمات البرمجية قد تقلب حكم نماذج اللغة الكبيرة على حداثة الأفكار العلمية بنسبة تتجاوز 50 نقطة مئوية.
أوبن إيه آي تطلق نموذجي الذكاء الاصطناعي GPT-6 Sol وLuna
أعلنت أوبن إيه آي عن إطلاق نموذجي الذكاء الاصطناعي GPT-6 Sol وLuna لتقديم ذكاء متطور بتكلفة معيشية واقتصادية منخفضة وكفاءة أعلى.
نظام LitPivot من Ai2 يعيد تشكيل تطوير الأفكار البحثية
أطلقت Ai2 نظام LitPivot الذي يربط بين تطوير الأفكار البحثية والمراجع الأدبية ديناميكياً، مما يساعد الباحثين على تحسين جودة أبحاثهم عبر تقييم دقيق للسياق.