تقنيات النمذجة الفضائية لتطبيقات الصوت على أيه دبليو إس
تقدم الشراكة بين كارتيسيا وأمازون وبس خدمات صوتية ذكية فائقة السرعة بالاعتماد على نماذج مساحة الحالة المتطورة وبنية سحابية قوية.
 رضوان عبدالهاديمحرر وكاتب تقني
تطور الذكاء الاصطناعي الصوتي وتحديات زمن الاستجابة
تشهد تقنيات الذكاء الاصطناعي التخاطبي تحولاً جذرياً في طريقة تفاعل البشر مع الأنظمة الرقمية الحديثة. فمن المساعدات الافتراضية ومراكز الاتصال المدعومة بالذكاء الاصطناعي إلى أدوات الترجمة الفورية، باتت الواجهات الصوتية تمثل النمط الافتراضي للتواصل لملايين المستخدمين حول العالم. ومع ذلك، لا يزال تقديم تجربة صوتية طبيعية بالكامل يشكل أحد أصعب التحديات الهندسية في البنية التحتية للذكاء الاصطناعي نظراً لتوقع المستخدمين استجابة فورية تشبه التفاعل البشري الطبيعي.
يؤدي التأخير الزمني المفرط إلى كسر التدفق الطبيعي للمحادثة وتقويض ثقة المستخدم في النظام. ولكي تبدو الكلمات المتولدة اصطناعياً طبيعية، يجب أن تصل ضمن النافذة الزمنية المعتادة لتبادل الأدوار بين البشر. وفي هذا السياق، تستعرض المدونة التقنية الصادرة عن AWS Machine Learning Blog أحدث الطرق المبتكرة لمعالجة هذه التحديات عبر البنية السحابية المتقدمة.
تواجه نماذج تحويل النص إلى كلام التقليدية القائمة على محولات النصوص صعوبات كبيرة في التعامل مع زمن استجابة البث المباشر؛ لأنها تعالج التسلسلات بالكامل قبل إصدار أي مخرجات. هذا القيد المعماري يخلق توالياً أساسياً بين جودة المخرجات وارتفاع معدل التأخير. ولتجاوز ذلك، تبرز فئة جديدة من النماذج الهندسية القادرة على حل هذه المعادلة الصعبة بفضل كفاءتها العالية في معالجة البيانات المتدفقة.
نماذج مساحة الحالة كبديل متطور للمحولات التقليدية
تتبنى نماذج مساحة الحالة مقارنة بالمحولات التقليدية نهجاً مختلفاً جذرياً في معالجة تسلسلات البيانات. فبينما تعتمد المحولات على آلية الانتباه التي تقارن كل عنصر في التسلسل بالعناصر الأخرى، مما يرفع من حجم الحسابات الرياضية بشكل تربيعي مع زيادة طول التسلسل، تتعامل نماذج مساحة الحالة مع التسلسل كنظام يتطور باستمرار مع مرور الوقت، مع معالجته خطوة بخطوة والاحتفاظ بحالة داخلية مدمجة.
تتميز هذه النماذج بكفاءة عالية تجعلها ملائمة للغاية لمعالجة البيانات الصوتية الحية والمباشرة. ومن أبرز مزاياها الحفاظ على الاعتمادات طويلة المدى دون اضمحلال الإشارة، والتمتع ببصمة ذاكرة ثابتة تختلف عن المحولات التي تخزن كافة الرموز السابقة مؤقتاً، فضلاً عن دعم البث المباشر الأصلي الذي يعالج المدخلات رمزاً تلو الآخر دون الحاجة لتعديلات معمارية معقدة.
تتطلب التطبيقات الصوتية الفورية مثل المساعدات الآلية تفاعلات لا تحتمل أي تأخير زمني ملموس. ولتحقيق ذلك بكفاءة عالية على مستوى الشركات، تتكامل الابتكارات التقنية مع الحلول المقدمة من شركاء المنصة البارزين مثل Cartesia لتقديم تجارب صوتية متكاملة وسلسة للمستخدمين النهائيين في مختلف القطاعات.
تطبيقات النماذج الصوتية المتقدمة في قطاعات متعددة
يتسارع الطلب على تقنيات الذكاء الاصطناعي الصوتي الفوري عبر العديد من القطاعات الحيوية. ففي مراكز الاتصال، تحتاج الوكلاء الذكية التي تتعامل مع ملايين التفاعلات إلى توليد كلام فوري للحفاظ على الحوار الطبيعي. وفي مجال الرعاية الصحية عن بعد، تتطلب استشارات المرضى أصواتاً ذات زمن استجابة منخفض لضمان التواصل الدقيق والفعال بين الطبيب والمريض.
تمتد التطبيقات لتشمل قطاع الألعاب والعوالم الافتراضية، حيث تتطلب التجارب الغامرة توليداً صوتياً فورياً لتفاعل الشخصيات غير اللاعبين بمرونة عالية مع اللاعبين. إضافة إلى ذلك، تستفيد أدوات إمكانية الوصول وقارئات الشاشة من هذه الاستجابة اللحظية لخدمة المستخدمين ذوي الإعاقات البصرية بكفاءة أفضل ودون أي تأخير مزعج.
تساعد هذه الحلول المتقدمة وكلاء المبيعات في إجراء الاتصالات الواردة والصادرة والرد دون توقفات محرجة للتعامل مع اعتراضات العملاء المحتملين والاحتفاظ بهم على الخط، مما يعزز فاعلية الحملات التسويقية والخدمية عبر مختلف القنوات الرقمية المتاحة.
نماذج سونيك وإينك لتوليد وتحويل الكلام الفوري
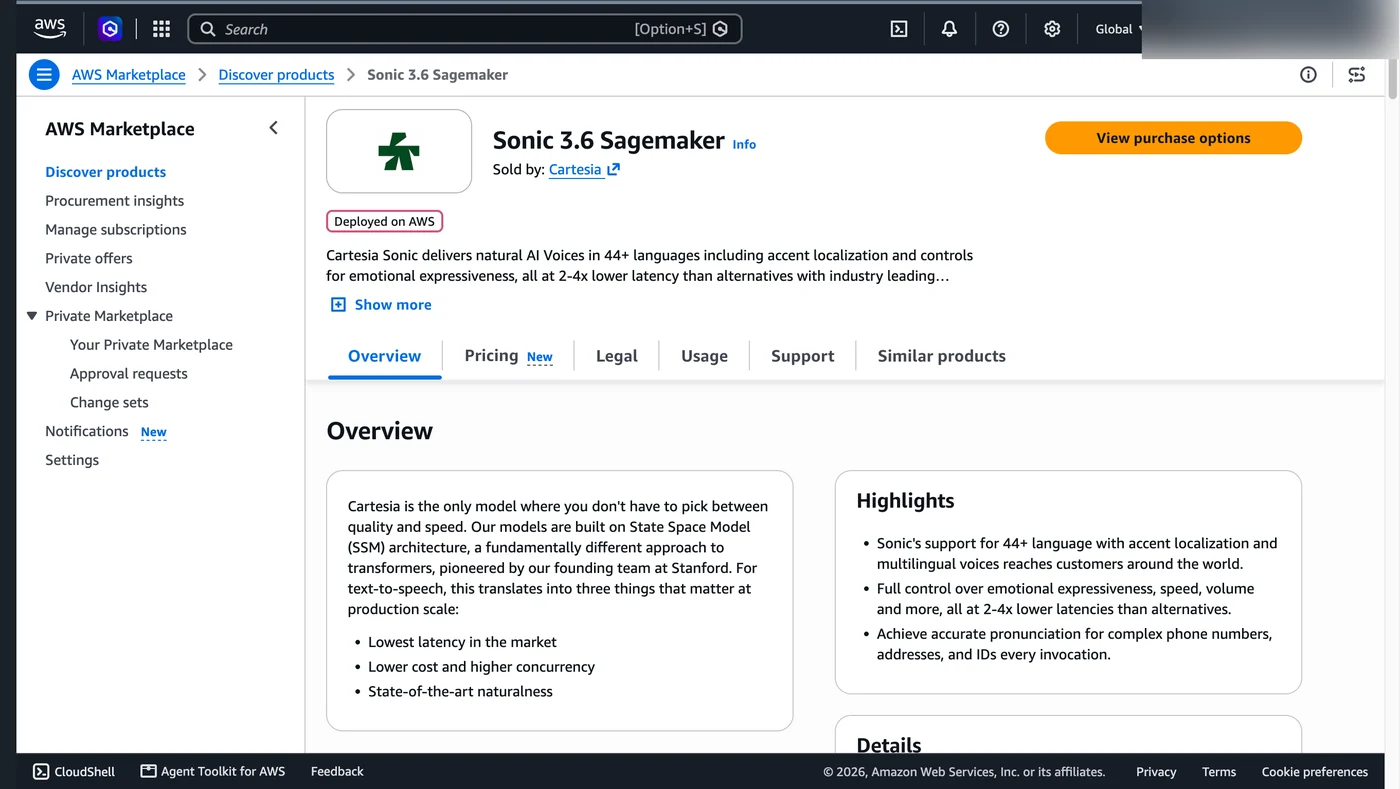
توظف شركة كارتيسيا مزايا نماذج مساحة الحالة في نموذجها الأساسي سونيك المخصص لتوليد الكلام وتحويل النصوص إلى أصوات فائقة الواقعية. يتميز النموذج بقدرته على إيصال بايت الصوت الأول خلال مدة تقارب 90 جزءاً من الألف من الثانية، مما يجعل المستخدم يشعر بأن النظام يستجيب بشكل فوري تقريباً، مع دعم واسع لأكثر من 44 لغة مختلفة وبجودة صوتية عالية تحاكي الطبيعة البشرية.
يتميز نموذج سونيك أيضاً بقدرته على استنساخ الأصوات بدقة عالية بناءً على عينات صوتية قصيرة لا تتجاوز عشر ثوانٍ، إلى جانب اعتماده على بنية أساسية تدعم البث المتدفق لتبدأ عملية توليد الصوت قبل اكتمال تلقي النص الكامل. وهو ما يجعله خياراً مثالياً للفرق الراغبة في تقليل الزمن اللازم للوصول إلى مرحلة الإنتاج الفعلي بأقل تكلفة تشغيلية ممكنة.
في المقابل، يتخصص نموذج إينك في تحويل الكلام إلى نص بدقة عالية مصممة خصيصاً لتطبيقات الذكاء الاصطناعي التخاطبي. فهو يوفر خاصية الكشف التلقائي عن انتهاء دور المتحدث لمعالجة فترات التوقف المحرجة، وإصدار نصوص جزئية أثناء حديث المستخدم لتمكين النماذج الكبيرة من صياغة الردود بشكل مسبق.
خيارات ونماذج نشر التطبيقات الصوتية على منصة أيه دبليو إس
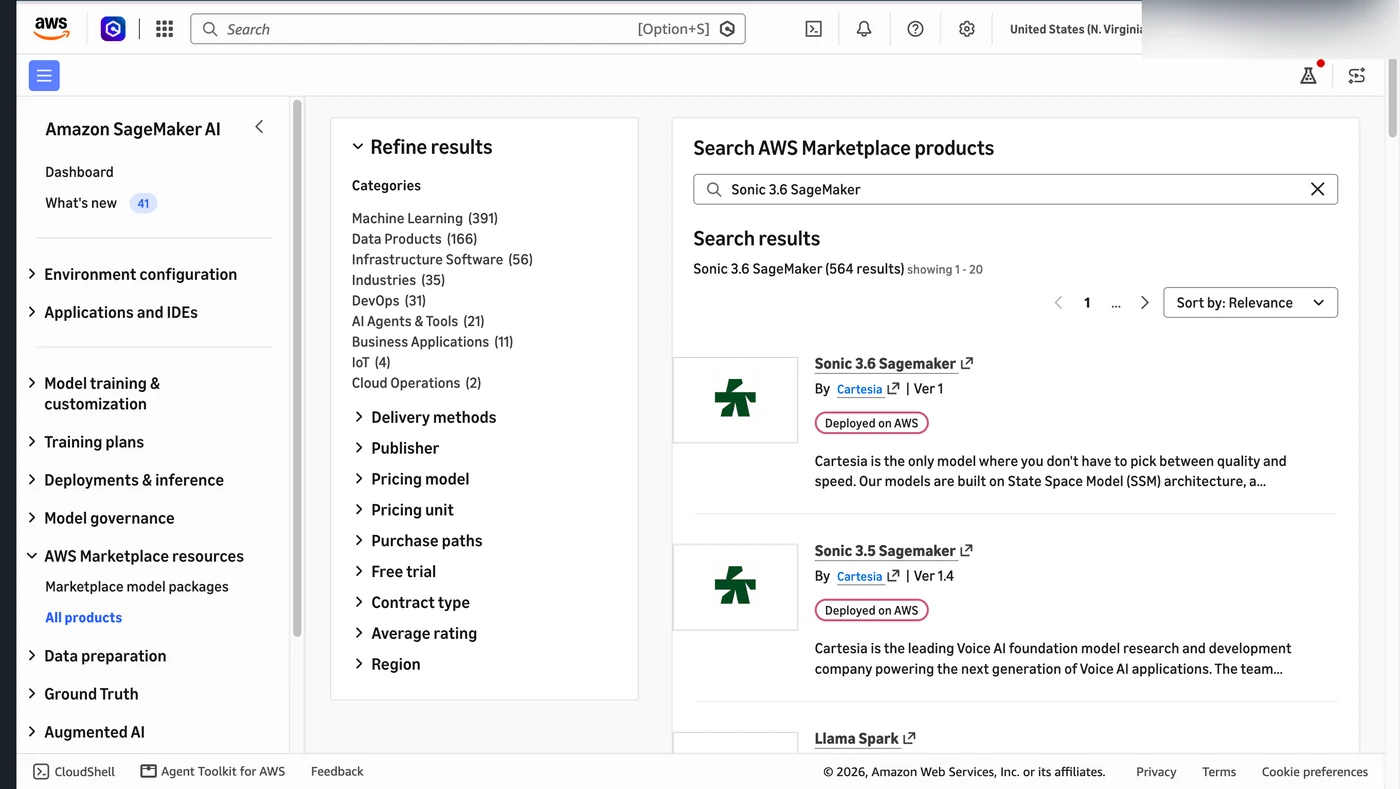
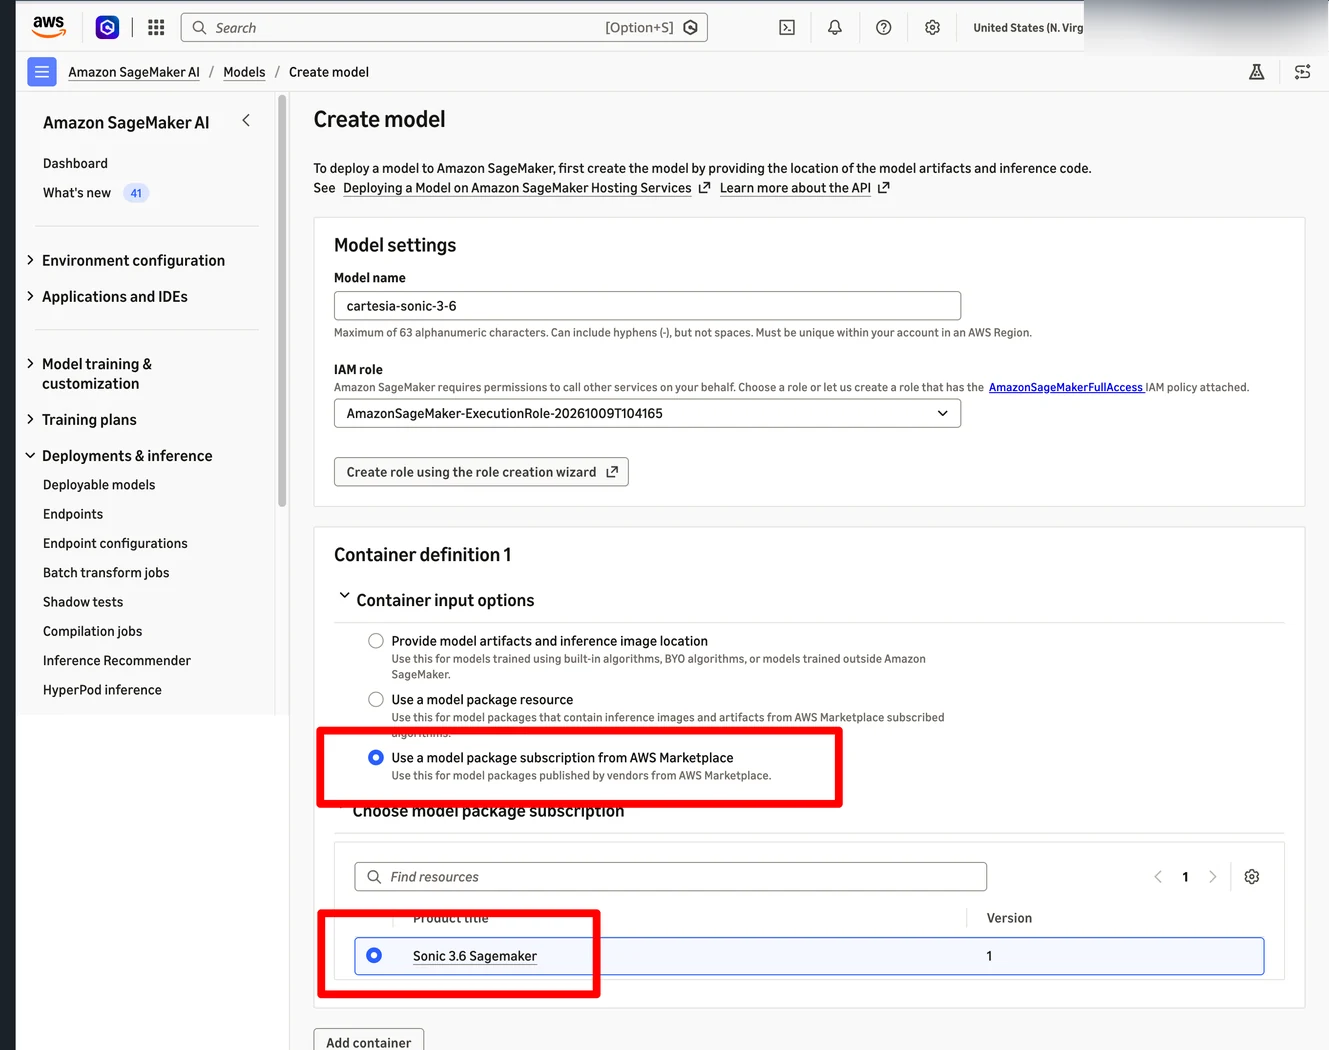
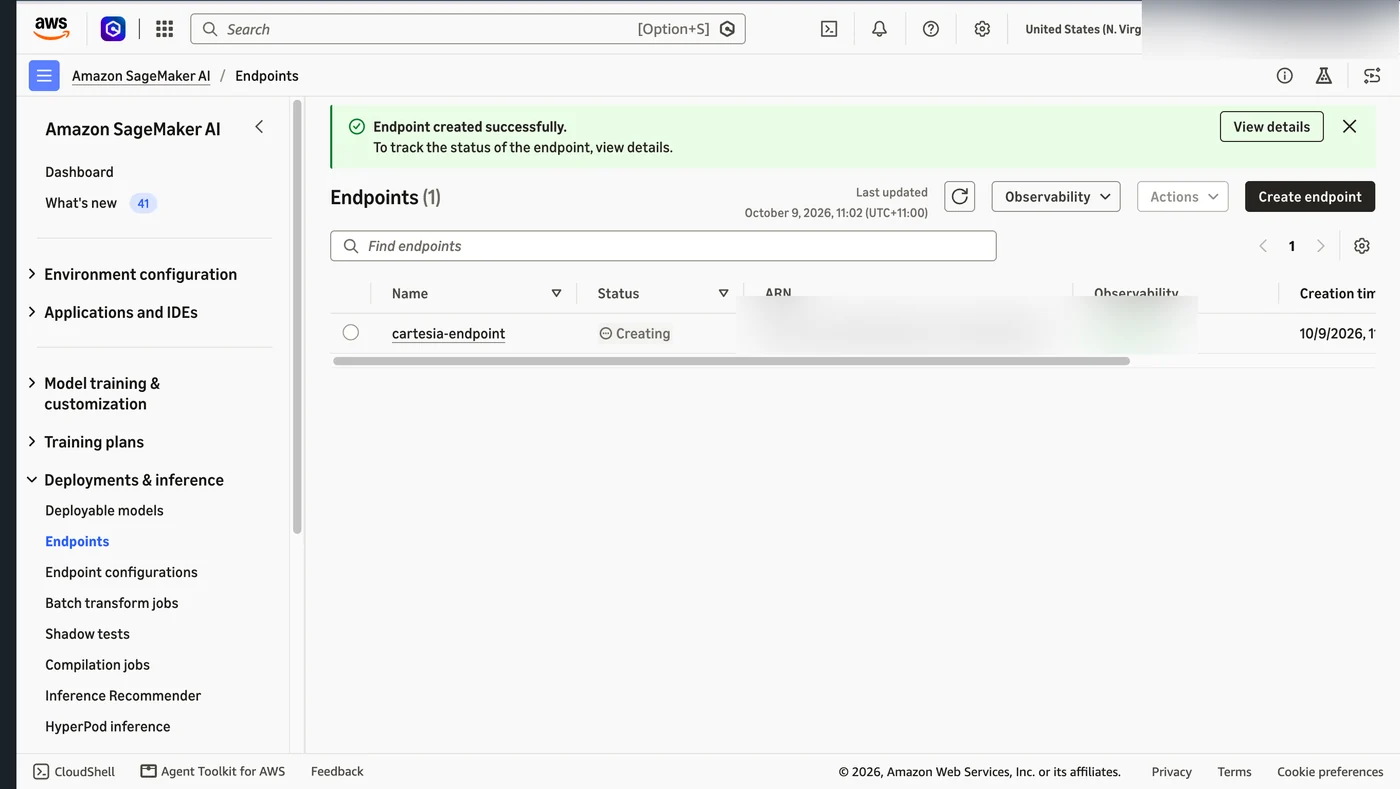
تتيح البنية التحتية السحابية إمكانية نشر نماذج كارتيسيا مباشرة داخل حسابات المستخدمين الخاصة لضمان سيادة البيانات والتحكم بمستوى زمن الاستجابة والامتثال للمعايير التنظيمية. يتوفر نموذج سونيك كحزمة نماذج عبر متجر الخدمات الرقمية، ويمكن نشره بسهولة ضمن بيئة العمل الافتراضية الخاصة بالمستخدم دون مغادرة بيانات الاستدلال لحدود الحساب.
تتعدد مسارات النشر لتلبية متطلبات مختلف المطورين وفرق العمل التقنية. ويُعد استخدام بيئات الحوسبة السحابية المدارة المسار الأسرع للوصول إلى نقاط نهاية سريعة وآمنة، حيث يمكن للمطورين الاستفادة من حزم النماذج المتاحة والبدء الفوري في تشغيل أحمال العمل الصوتية الكثيفة ضمن بيئات متكاملة ومختبرة مسبقاً.
يمكن للمؤسسات الراغبة في توسيع نطاق تطبيقاتها الاستعانة بالوثائق التقنية المتوفرة عبر Cartesia get-started guide لمعرفة الخطوات الأولى للتكامل البرمجي، أو الاطلاع على المشاريع البرمجية في Cartesia GitHub repository للاستفادة من النماذج الجاهزة وأكواد المصدر المفتوحة.
المصادر
- AWS Machine Learning BlogBuilding ultra-low-latency voice AI applications on AWS
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
AWS تحسّن أداء نماذج MoE على Amazon SageMaker AI
تكشف AWS عن تحسينات هندسية لنوى نماذج الخبراء المتعددين ترفع throughput حتى 10% وتسرّع ظهور أول رمز بنسبة تصل إلى 9% على H200.
توليد الصور والفيديوهات عبر vLLM-Omni على SageMaker AI
تعرف على كيفية نشر نماذج توليد الصور والفيديوهات باستخدام حاويات التعلم العميق vLLM-Omni على منصة Amazon SageMaker AI بمرونة كاملة.
EXL تبتكر حلاً ذكياً على AWS لتسريع مراجعة المطالبات الطبية
تطلق شركة EXL حلاً تقنياً مدعوماً بالذكاء الاصطناعي على AWS يختصر وقت مراجعة المطالبات الطبية من 100 دقيقة لكل ملف بفضل النماذج اللغوية المتخصصة.
أمازون SageMaker AI تستعرض 13 تحديثاً تقنياً لتعزيز استدلال الذكاء الاصطناعي
تستعرض أمازون SageMaker AI أبرز تحديثات عام 2026 في منصتها لاستدلال نماذج الذكاء الاصطناعي التوليدي، مع التركيز على تحسين الكفاءة، التوسع، وسرعة التشغيل.