AWS تحسّن أداء نماذج MoE على Amazon SageMaker AI
أعلنت AWS عن تحسينات في نوى نماذج الخبراء المتعددين المدمجة على Amazon SageMaker AI. وتستهدف التحديثات رفع الاستفادة من معالجات H200 وتقليل زمن الاستجابة والكلفة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحسين نوى MoE على SageMaker AI
قدّمت AWS مجموعة من التحسينات الهندسية لنوى نماذج الخبراء المتعددين، أو MoE، عند تشغيلها بصورة مدمجة على Amazon SageMaker AI. وتركّز هذه التحسينات على عمليات توجيه الرموز، وتبديل البيانات، وتنفيذ الحسابات المتخصصة للخبراء داخل عملية GPU مجمّعة بدلاً من تشغيل حلقات منفصلة ومتتابعة.
تقول AWS إن التحسينات، التي تشمل إعادة ترتيب معاملات الضرب، وتوجيه نماذج FP8 إلى خلفية Triton، والتخلص من إعادة الترجمة المتكررة لـ Triton، حققت مجتمعة زيادة تصل إلى 10% في معدل المعالجة، وتسريعاً يصل إلى 9% في زمن الوصول إلى أول رمز على وحدات معالجة الرسوميات NVIDIA H200.
لماذا تمثل نوى MoE عنق زجاجة؟
تعتمد بنية MoE على تنشيط عدد محدود من الخبراء لكل رمز، ما يسمح بتوسيع سعة نماذج اللغة الكبيرة مع إبقاء الحساب المنفذ لكل رمز منخفضاً نسبياً. لكن عمليات MoE تستحوذ على جزء كبير من زمن الحساب الكلي؛ لذلك فإن أي قصور في تنفيذها ينعكس مباشرة على زمن استجابة الطلب وتكلفة تشغيله.
تجمع البنية المدمجة Fused MoE توجيه الرموز، وتحريك البيانات، والحسابات الخاصة بالخبراء في عملية واحدة مجمعة على GPU. ويمنح ذلك أفضلية زمنية مقارنة بإطلاق نوى مستقلة لكل خطوة، لكنه يزيد تعقيد تنفيذ النواة وتصحيحها، ويجعل الوصول إلى إشغال مرتفع للمعالج مرتبطاً بتحسينات مصممة خصيصاً للعتاد.
إعادة ترتيب الضرب للاستفادة من WGMMA
تستخدم بنية Hopper تعليمات Warp Group Matrix Multiply Accumulate، المعروفة اختصاراً بـ WGMMA، لتنفيذ عمليات ضرب المصفوفات بالتعاون بين مجموعة من 128 خيطاً. وتفرض هذه التعليمات شكلاً غير متماثل للمعاملات، إذ يثبت بُعد الصفوف M للمعامل الأول عند مقياس أساسي قدره 64، بينما يظل بُعد الأعمدة N أكثر مرونة.
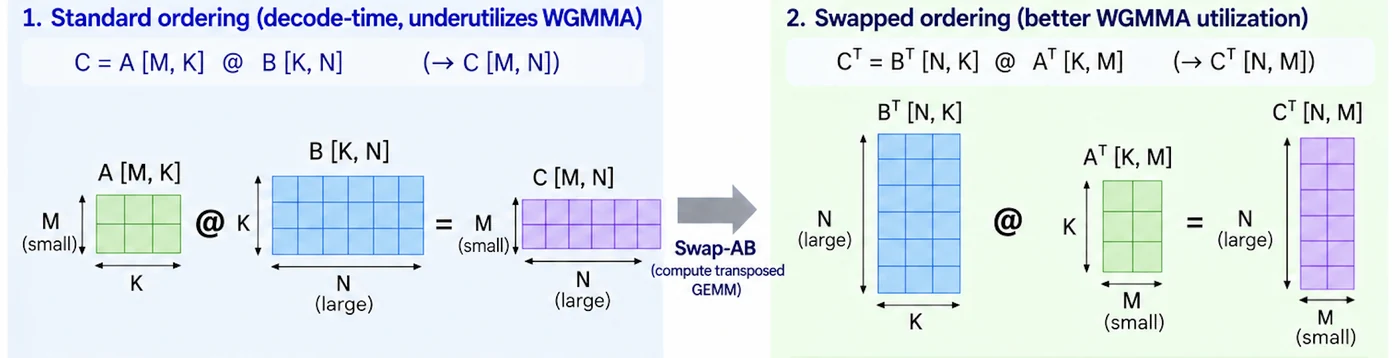
تظهر المشكلة بوضوح أثناء مرحلة فك الترميز، حين يعالج النظام رمزاً واحداً لكل تسلسل مستخدم. عندها قد ينخفض M إلى أقل من 64، أو إلى صف واحد فقط. وتصبح المصفوفة الأولى متجهًا أفقياً ضئيلاً، في حين تبقى أوزان الخبير كتلة كبيرة. ونتيجة لذلك لا تملأ المصفوفة الأولى تخطيط الصفوف الذي تتطلبه WGMMA، فتظل أجزاء واسعة من أنوية Tensor Core غير مستغلة.
ميزة Swap-AB في أحمال الخبراء المتعددين
عالج مهندسو AWS عدم التوافق هذا عبر استغلال خاصية الجبر الخطي التي تتيح تبديل ترتيب الضرب بعد نقل المصفوفات. وتضع هذه الخطوة البُعد الكبير الخاص بالخبراء في الموضع الأول ذي الحد الأدنى الثابت للصفوف، بدلاً من ترك البُعد الصغير الخاص بالرموز في ذلك الموضع.
في النواة المدمجة، لا يمثل بُعد N حجم الطبقة المخفي فحسب، بل يجمع أيضاً حجم الخبراء النشطين وحجمهم الوسيط. ومع اختيار ثمانية خبراء، يمكن أن يمتد هذا البُعد إلى عشرات أو مئات الآلاف من المعاملات. ويساعد وضع الكتلة الكبيرة في الموضع المناسب على ملء التخطيط المطلوب، كما يتيح لمحركات النسخ في Hopper جلب البيانات مسبقاً من الذاكرة المشتركة إلى السجلات بصورة غير متزامنة.
بحسب AWS، أدى هذا التعديل إلى زيادة تتراوح بين 2 و4% في معدل الإخراج الإجمالي عبر نماذج MoE واسعة النطاق على H200. وقد رفعت الشركة هذا التحسين إلى مشروع vLLM، وأصبح متاحاً ابتداءً من الإصدار 0.24.0.
اختيار الخلفية المناسبة لنماذج FP8
لا يقتصر أثر الأداء على تفاصيل النواة الداخلية، بل يشمل أيضاً الخلفية البرمجية التي تنفذ حسابات MoE. ويوجّه vLLM أنظمة التكميم المختلفة إلى Triton أو FlashInfer مع CUTLASS أو خلفيات أخرى، وفقاً لطبيعة النموذج والعملية الحسابية.
أظهرت عمليات القياس التي أجرتها AWS أن نماذج FP8 ذات التكميم على مستوى الموتر، عند تشغيلها على بنية Hopper، تستفيد من خلفية Triton أكثر من المسار الافتراضي FLASHINFER_CUTLASS، خصوصاً في أحمال MoE ذات التزامن المنخفض. ويرتبط ذلك بقدرة Triton على استخدام إعدادات مخصصة على مستوى العملية بدلاً من الاعتماد الكامل على تكوينات جامدة يحددها إطار العمل.
أثر التحسينات على خدمة النماذج
توضح هذه النتائج أن تحسين أداء MoE لا يعتمد على تغيير المعمارية الرياضية للنموذج، بل على مواءمة تنفيذها مع خصائص العتاد ومسار التشغيل. فإعادة ترتيب المعاملات تستهدف تخطيط Hopper، واختيار Triton يعالج اختلاف سلوك الخلفيات مع FP8، بينما يزيل منع إعادة الترجمة المتكررة لـ Triton كلفة إضافية من دورة الخدمة.
تأتي هذه العمل ضمن جهود AWS لتحسين استضافة نماذج اللغة الكبيرة على SageMaker AI. ويمكن الاطلاع على تفاصيل التحسينات ونتائج القياس في <a>مدونة AWS للتعلم الآلي</a>، التي تعرض تجربة المهندسين مع نوى Fused MoE على H200 وتشرح كيفية الاستفادة من التغييرات في بيئات تشغيل النماذج.
المصادر
- AWS Machine Learning BlogMixture-of-Experts kernel engineering on Amazon SageMaker AI
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
Meta تطلق نموذج Muse Spark Open على Amazon SageMaker JumpStart
أصبح نموذج Meta للبرمجة مفتوح الأوزان متاحاً على Amazon SageMaker JumpStart، مما يتيح للمطورين نشره بسهولة مع دعم نافذة سياق ضخمة وتخصيص كامل للبنية التحتية.
AWS تتيح بناء تطبيقات صوتية فورية عبر vLLM-Omni على SageMaker
تعتمد AWS على حاوية vLLM-Omni لتوزيع نموذج Qwen3-TTS على SageMaker AI، مما يتيح بثّ الصوت الفوري عبر اتصالات ثنائية الاتجاه لتحسين تجربة الوكلاء الصوتيين.
توليد الصور والفيديوهات عبر vLLM-Omni على SageMaker AI
تعرف على كيفية نشر نماذج توليد الصور والفيديوهات باستخدام حاويات التعلم العميق vLLM-Omni على منصة Amazon SageMaker AI بمرونة كاملة.
هجرة وكلاء الذكاء الاصطناعي متعدد النماذج إلى Amazon Bedrock AgentCore
تقدم AWS نمطاً تقنياً لنقل وكلاء الذكاء الاصطناعي متعدد النماذج من بنية ذاتية الإدارة إلى Amazon Bedrock AgentCore runtime مع الحفاظ على تنسيق النماذج وتقليل العبء التشغيلي.