
توليد الصور والفيديوهات عبر vLLM-Omni على SageMaker AI
تتيح أمازون وبلاتفورم vLLM-Omni للمطورين إمكانية نشر نماذج توليد الوسائط المتعددة عبر نقاط نهاية متخصصة للوقت الفعلي والاستدلال غير المتزامن.
 رضوان عبدالهاديمحرر وكاتب تقني
مقدمة حول دمج vLLM-Omni مع SageMaker AI
في إطار التطور المستمر لتقنيات الذكاء الاصطناعي التوليدي، أصبح بإمكان المطورين تحويل النصوص الوصفية إلى صور ثابتة ثم تحريكها بمرونة لتصبح مقاطع فيديو قصيرة على منصة Amazon SageMaker AI. يعتمد هذا النهج المتقدم على نشر نقطتي نهاية منفصلتين ولكن من نفس حاوية التعلم العميق AWS vLLM-Omni DLC، مما يقلل من تباين حزمة التوجيه ويسهل عملية إدارة النماذج المتخصصة.
تعتبر هذه المقالة امتداداً لسلسلة تقنية متخصصة تتناول حاويات التعلم العميق من أمازون، حيث ركز الجزء الأول على تطبيقات الصوت الفورية باستخدام البث ثنائي الاتجاه، بينما يركز الجزء الحالي على آليات الاستدلال المباشر وغير المتزامن للصور والفيديوهات.
آلية توليد الصور الثابتة عبر الاستدلال الفوري
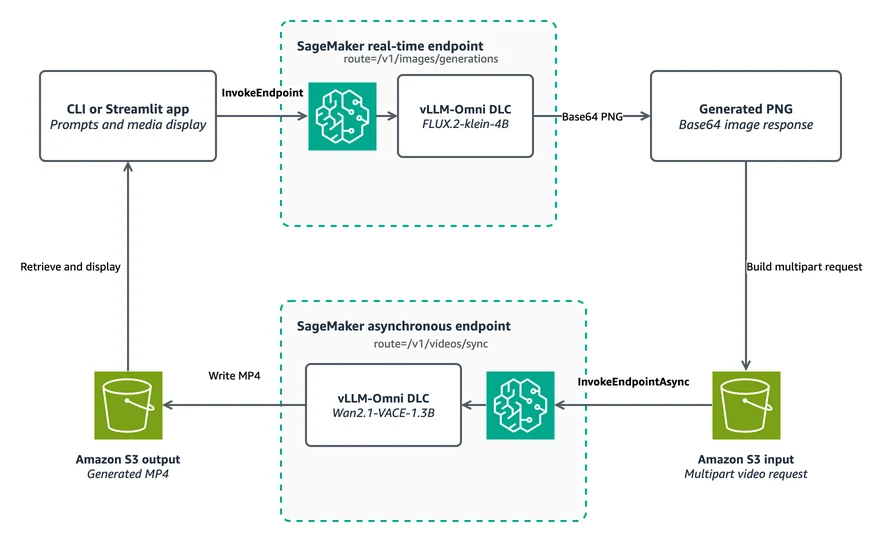
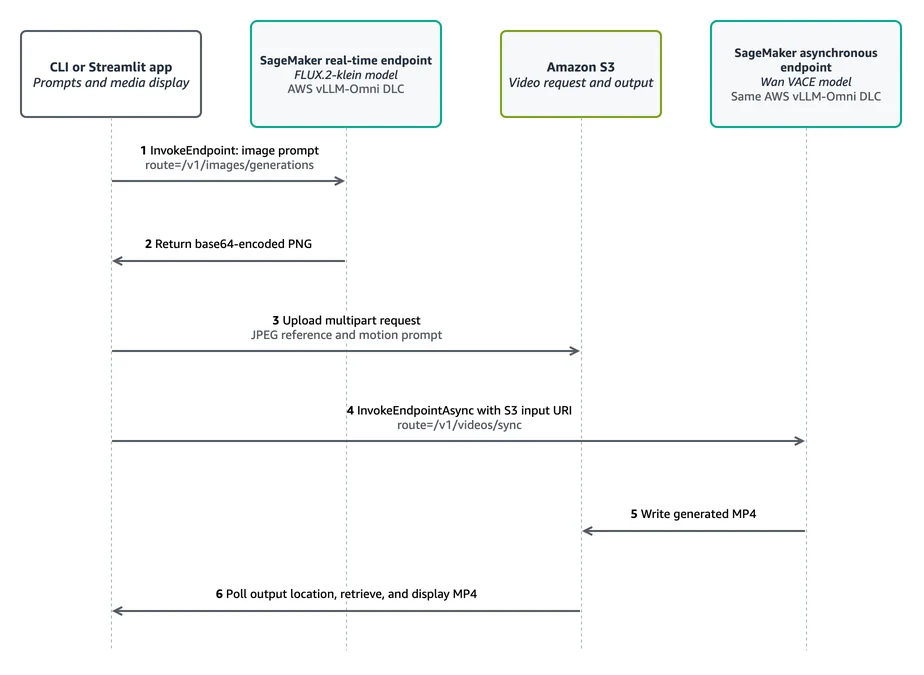
يبدأ سير العمل بإرسال موجه نصي إلى نقطة نهاية مخصصة للوقت الفعلي لتوليد الصور باستخدام نموذج FLUX.2-klein-4B. تقوم نقطة النهاية هذه بمعالجة الطلب وإرجاع صورة بصيغة PNG مشفرة بنظام base64 مباشرة إلى التطبيق، وهو ما يتطلبه سير العمل لضمان توفر الصورة قبل الانتقال للخطوة التالية.
تستفيد هذه المرحلة من سرعة الاستجابة المباشرة التي توفرها نقاط النهاية الفورية، مما يتيح للمستخدم معاينة الصورة وتعديل الأبعاد قبل تحويلها إلى فيديو متحرك عبر النماذج اللاحقة.
تحويل الصور إلى فيديوهات باستخدام الاستدلال غير المتزامن
بمجرد الحصول على الصورة الثابتة وتعديل أبعادها، يقوم التطبيق بتمريرها مع موجه حركي إلى نموذج Wan2.1-VACE-1.3B المخصص لإنشاء الفيديوهات. نظراً لأن عمليات توليد الفيديو تستغرق وقتاً أطول وتحمل حمولات مركبة، يتم استخدام الاستدلال غير المتزامن عبر Amazon S3.
تتولى منصة الاستدلال غير المتزامن طابور الطلبات وتخزين المخرجات بصيغة MP4 في التخزين السحابي، مما يتيح للعميل استطلاع حالة الطلب واسترجاع الملف النهائي بسلاسة دون الحاجة لفتح اتصال متزامن طويل الأمد.
تكوين البنية التحتية ونشر الحاويات
تعتمد هذه التجربة على استخدام AWS Deep Learning Containers لتغليف كافة الحزم والتبعيات اللازمة للتدريب والاستدلال. يضمن استخدام نفس صورة الحاوية عبر متغيرات البيئة توحيد البيئة التشغيلية مع تخصيص أنواع المثيلات حسب متطلبات كل نموذج.
يوفر نموذج الكود المتاح للمستخدمين إمكانية استنساخ المستودع، ضبط الأذونات، وتشغيل سكريبت النشر الذي يقوم بإنشاء نقطتي النهاية للصور والفيديوهات وحفظ حالتهما لاستخدامها لاحقاً.
خطوات التنفيذ والأوامر البرمجية للاستخدام
لبدء العمل، يتعين على المطور استنساخ المستودع الخاص بأمثلة الاستضافة، ثم إنشاء بيئة افتراضية بايثون وتثبيت المتطلبات اللازمة عبر مدير الحزم لتفادي أي تعارض في الإصدارات.
بعد ضبط دور التنفيذ الخاص بـ SageMaker وتنفيذ سكريبت النشر، يمكن تشغيل سير العمل النهائي عبر سطر الأوامر باستخدام الموجهات النصية والحركية المطلوبة للوصول إلى النتيجة المرجوة وتخزين ملفات الفيديو بنجاح.
المصادر
- AWS Machine Learning BlogGenerate images and video with vLLM-Omni on SageMaker AI – Part 2