إنTEL تكشف عن خدمات استنتاج مصغّرة لتسريع نماذج الذكاء الاصطناعي
أطلقت شركة إنTEL حزمة برمجية جديدة تتيح للمؤسسات تشغيل نماذج اللغة الكبيرة بكفاءة قصوى على البنية التحتية الحالية دون الحاجة إلى شراء أجهزة جديدة أو إجراء تعديلات يدوية معقدة.
 رضوان عبدالهاديمحرر وكاتب تقني
إعلان عن خدمات الاستنتاج المصغّرة
أعلنت شركة إنTEL رسمياً عن إطلاق خدمات الاستنتاج المصغّرة (Intel® Inference Microservices)، وهي حزمة برمجية مصممة لتسهيل الحصول على أداء محسّن لنماذج اللغة الكبيرة (LLM) على المعالجات الحالية. تهدف هذه الخدمة إلى القضاء على الحاجة إلى أيام أو أسابيع من الضبط اليدوي المعقد للعتاد، حيث تتولى الحاوية البرمجية اكتشاف المعالج وتطبيق الإعدادات المثلى تلقائياً عند بدء التشغيل. ويمكن الرجوع إلى Intel Newsroom للاطلاع على التفاصيل الأصلية للمصدر.
آلية العمل التلقائية
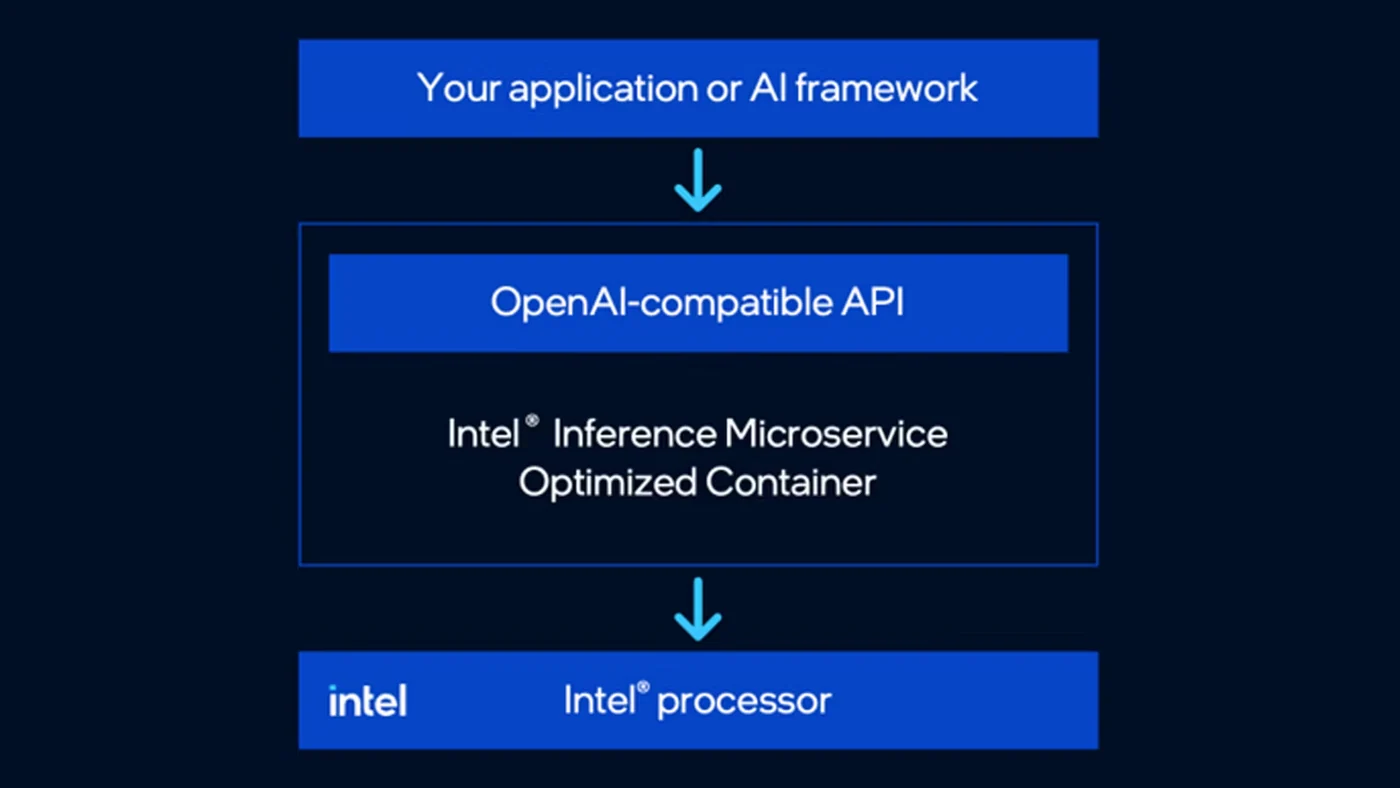
تعتمد الخدمة على مبدأ أن المستخدم يختار النموذج، بينما تختار الحاوية الإعدادات المناسبة. عند التشغيل، تفحص الحاوية المعالج المضيف، بما في ذلك عدد الأنوية، ترتيب الذاكرة عبر عقد NUMA، والمسرعات المدمجة مثل Intel AMX وAVX-512. بناءً على هذه البيانات، تختار الحاوية ملف إعدادات (Profile) تم قياسه وتحقق منه مسبقاً من قبل فريق إنTEL لضمان أفضل أداء ممكن لهذا النموذج على هذا العتاد المحدد.
التكامل السلس مع أدوات الذكاء الاصطناعي
تقدم الخدمة واجهة برمجة تطبيقات متوافقة مع OpenAI، مما يعني أن معظم أطر عمل الذكاء الاصطناعي الحالية، مثل OpenAI SDK وLangChain وLlamaIndex، يمكنها التفاعل معها دون أي تعديلات. لا يحتاج المطورون إلى تثبيت محركات استنتاج منفصلة أو إعداد بيئات Python معقدة، بل يكفي توجيه طلباتهم إلى عنوان URL أساسي واحد، مما يسهل عملية النشر بشكل كبير.
الفوائد التشغيلية والمالية
تساعد هذه الخدمة المؤسسات على تقليل وقت الوصول إلى الإنتاج بشكل ملحوظ، حيث تستبدل عملية الضبط والمعايرة الطويلة بأمر سحب وتشغيل بسيط. كما أنها تتيح للمشاريع البدء فوراً باستخدام سعة المعالجات الموجودة بالفعل، بدلاً من انتظار دورات الشراء الطويلة للحصول على أجهزة جديدة. هذا يقلل من الحاجة إلى متخصصين في تحسين أداء الاستنتاج، وهو ما يعتبر عنق زجاجة شائعة في برامج الذكاء الاصطناعي المؤسسية.
التوافق والمرونة المستقبلية
يستهدف الإصدار الأول من الخدمة معالجات Intel Xeon من الجيل الرابع والخامس والسادس، ويعمل على Docker أو Kubernetes. تؤكد إنTEL أن الواجهة البرمجية هي العقد الأساسي، وليس العتاد نفسه، مما يعني أن توسيع الخدمة لتشمل أجهزة إنTEL الأخرى في المستقبل لن يتطلب إعادة كتابة التطبيقات، بل تغييرات في النشر فقط. كما تتيح الخدمة للمطورين رؤية الإعدادات المطبقة دون الحاجة إلى تشغيل النموذج فعلياً، مما يعزز الشفافية.
التزام إنTEL بالمعايير المفتوحة
أوضح بيل بيرسون، نائب الرئيس في إنTEL، أن التحسينات المقدمة في هذه الإصدارات هي نفسها التي تساهم بها الشركة في الأطر المفتوحة مثل vLLM. تهدف إنTEL إلى تقديم حزمة مضبوطة وموثوقة دون إجبار العملاء على إجراء عمليات الضبط بأنفسهم، مع التزام مستمر بإضافة تحسينات جديدة ودعم المزيد من دقة البيانات والمحركات البرمجية في الإصدارات القادمة.
المصادر
- Intel NewsroomAnnouncing Intel® Inference Microservices: Tuned LLM Inference on Intel® Processors
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
أمازون تطلق SageMaker HyperPod Inference Gateway لتعزيز كفاءة الذكاء الاصطناعي
أطلقت أمازون AWS بوابة SageMaker HyperPod Inference Gateway لترشيد استهلاك وحدات معالجة الرسوميات وتقليل زمن استجابة نماذج اللغة الضخمة في بيئات Kubernetes.
إنتل تكشف عن مخطط مفتوح لتحويل نماذج الذكاء الاصطناعي إلى تطبيقات إنتاجية
تقدّم إنتل استراتيجية برمجية مفتوحة تربط معالجات Xeon وبطاقات GPU بنماذج الذكاء الاصطناعي، لتسهيل الانتقال من التجارب إلى بيئات الإنتاج عبر أطر برمجية مألوفة.
أمازون SageMaker AI تستعرض 13 تحديثاً تقنياً لتعزيز استدلال الذكاء الاصطناعي
تستعرض أمازون SageMaker AI أبرز تحديثات عام 2026 في منصتها لاستدلال نماذج الذكاء الاصطناعي التوليدي، مع التركيز على تحسين الكفاءة، التوسع، وسرعة التشغيل.
Intel تكشف عن بنية تحتية مفتوحة لتسريع عصر الذكاء الاصطناعي الوكيل
كشفت Intel عن معالجات Xeon وأجهزة GPU D-series لدعم الذكاء الاصطناعي الوكيل، مع تركيز على الكفاءة والبنية المفتوحة لتلبية الطلبات المتزايدة.