
أمازون تطلق SageMaker HyperPod Inference Gateway لتعزيز كفاءة الذكاء الاصطناعي
أداة توجيه ذكية جديدة من أمازون تهدف إلى تحسين أداء استدلال النماذج اللغوية الضخمة عبر تخصيص المهام بذكاء للوحدات المتاحة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحديات التوجيه في بيئات الذكاء الاصطناعي
تعد عملية تشغيل نماذج اللغة الضخمة (LLMs) على نطاق واسع في تجمعات وحدات معالجة الرسوميات (GPU clusters) عملية مكلفة للغاية، وتزداد تعقيداً مع استخدام موازنات التحميل التقليدية في Kubernetes. تشير مدونة [AWS Machine Learning Blog](https://aws.amazon.com/blogs/machine-learning/introducing-amazon-sagemaker-hyperpod-inference-gateway/) إلى أن خوارزميات التوزيع التقليدية، مثل "الدور الدائري" (Round-robin)، تفتقر إلى الرؤية الداخلية لما يحدث داخل الوحدات، مما يؤدي إلى هدر الموارد.
في ظل غياب الوعي ببيانات GPU الحية، تضطر المؤسسات إلى الإفراط في توفير الموارد لتعويض التباطؤ، حيث يمكن أن يرتفع زمن استجابة الرمز الأول إلى أكثر من 4 ثوانٍ أثناء فترات الذروة. ويوضح خبراء [Artificial Intelligence](https://aws.amazon.com/blogs/machine-learning/) أن هذا النمط يسبب تراكم الطلبات خلف الوحدات المشغولة بينما تظل القدرات الأخرى غير مستغلة، وهو ما استدعى ابتكار حل جديد للتحكم في تدفق العمليات.
بوابة SageMaker HyperPod: حل ذكي للتحكم في الاستدلال
أعلنت شركة أمازون عن إطلاق SageMaker HyperPod Inference Gateway، وهو نظام توجيه أصلي داخل Kubernetes يتم نشره كإضافة مدارة (Add-on) على البنية التحتية الحالية لـ HyperPod. يعمل هذا النظام من خلال تحليل إشارات GPU في الوقت الفعلي، ليقوم بتوجيه كل طلب استدلال إلى الوحدة (Pod) الأكثر ملاءمة لمعالجته في تلك اللحظة.
بفضل هذا التصميم، يمكن للمستخدمين تقليل زمن استجابة الرمز الأول بنسبة تصل إلى 82%، وهي قفزة نوعية في الأداء دون الحاجة إلى تغييرات في خوادم النماذج أو تطبيقات العميل. على سبيل المثال، قد يجد مستخدم روبوت الدردشة الذي كان ينتظر 4.4 ثانية للحصول على الرمز الأول، أن وقت الانتظار قد انخفض إلى أقل من 800 مللي ثانية.
آلية العمل: طبقتان من الذكاء التقني
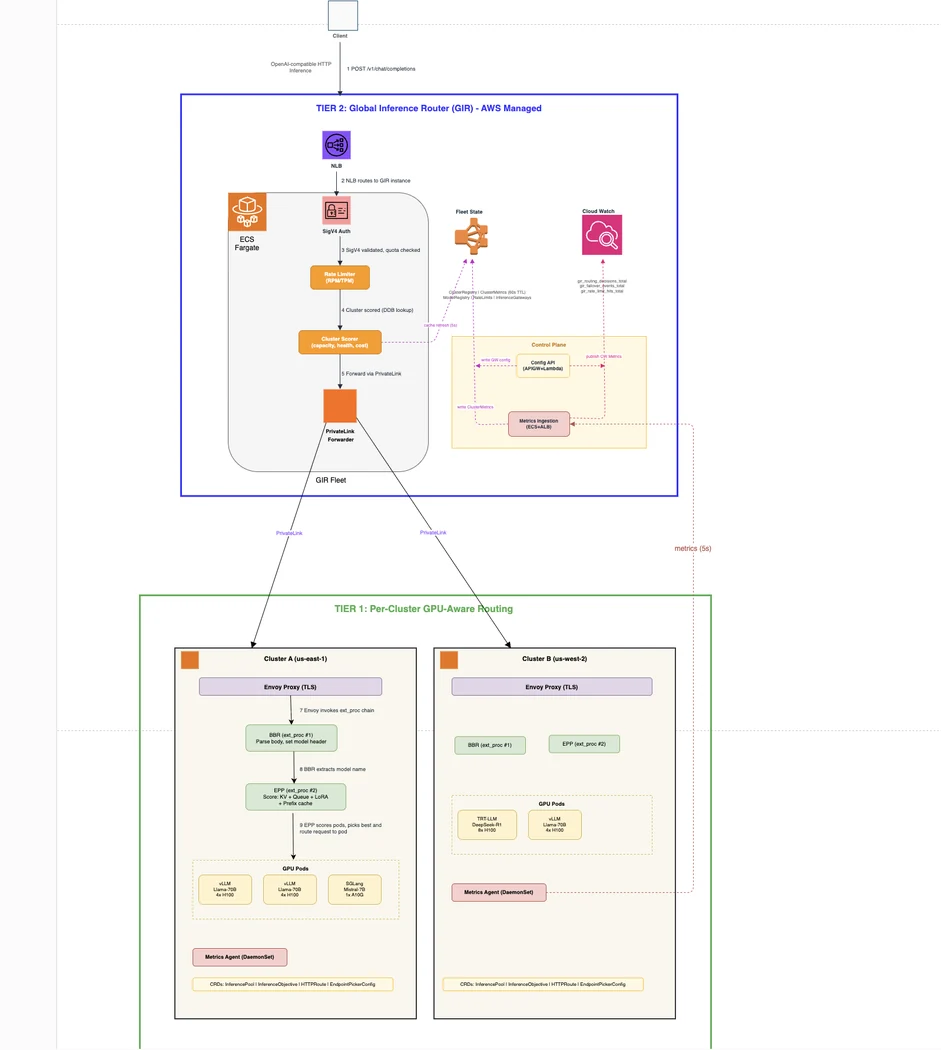
يعتمد النظام على هيكلية من مستويين. المستوى الأول هو بوابة لكل تجمع (Cluster)، والتي تعمل كإضافة مدارة داخل Amazon EKS. تتضمن هذه البوابة محركاً ذكياً يقوم بفحص مقاييس Prometheus من كل وحدة تخدم النماذج، ويستخدم خوارزمية تسجيل موزونة لاختيار النهاية الخلفية المثلى بناءً على عدة عوامل منها استخدام ذاكرة التخزين المؤقت (KV cache)، وعمق الطابور، ووجود مهايئات LoRA في الذاكرة.
أما المستوى الثاني، والمقرر توفيره قريباً، فهو "الموجه العالمي للاستدلال" (GIR). صُمم هذا المستوى ليوفر تنسيقاً على مستوى الأسطول بالكامل عبر تجمعات ومناطق متعددة، مع دعم التبديل التلقائي عند الفشل (Failover) وتشكيل حركة المرور بشكل واعٍ بالتكاليف، مما يجعل النظام قابلاً للتوسع في البنى التحتية العملاقة.
مميزات تقنية تعزز الإنتاجية
يوفر النظام ميزة التوجيه المستند إلى محتوى الطلب (Body-Based Router)، حيث يمكن للبوابة التعامل مع نماذج متعددة في تجمع واحد. يقوم النظام آلياً بتوجيه كل طلب إلى تجمع النماذج الصحيح بناءً على الحقل المذكور في نص الطلب، وهو ما يزيل تعقيد منطق التوجيه من جانب تطبيق العميل.
كما يُعد النظام مثالياً للعمل مع مهايئات LoRA الدقيقة، حيث يفضل النظام توجيه الطلبات إلى الوحدات التي تحمل المهايئ المطلوب بالفعل في ذاكرة GPU. هذا يمنع التأخير الناتج عن تبديل المهايئات المكلف. وفي حالة عدم وجود المهايئ في أي وحدة، يتم توجيه الطلب إلى الوحدة التي تمتلك أكبر قدرة متاحة لتحميل المهايئ بسرعة، مما يضمن تدفقاً سلساً للبيانات.
المراقبة والقياس
لا يكتفي النظام بالتوجيه الذكي، بل يوفر رؤية شاملة عبر مصفوفة من المقاييس التي يتم إرسالها إلى أنظمة المراقبة القائمة. يمكن للمهندسين مراقبة مستوى الوحدات (KV cache، عمق الطابور)، ومستوى التجمع (إجمالي الطلبات، زمن الاستجابة)، وحتى مستوى الأسطول بالكامل عبر Amazon CloudWatch.
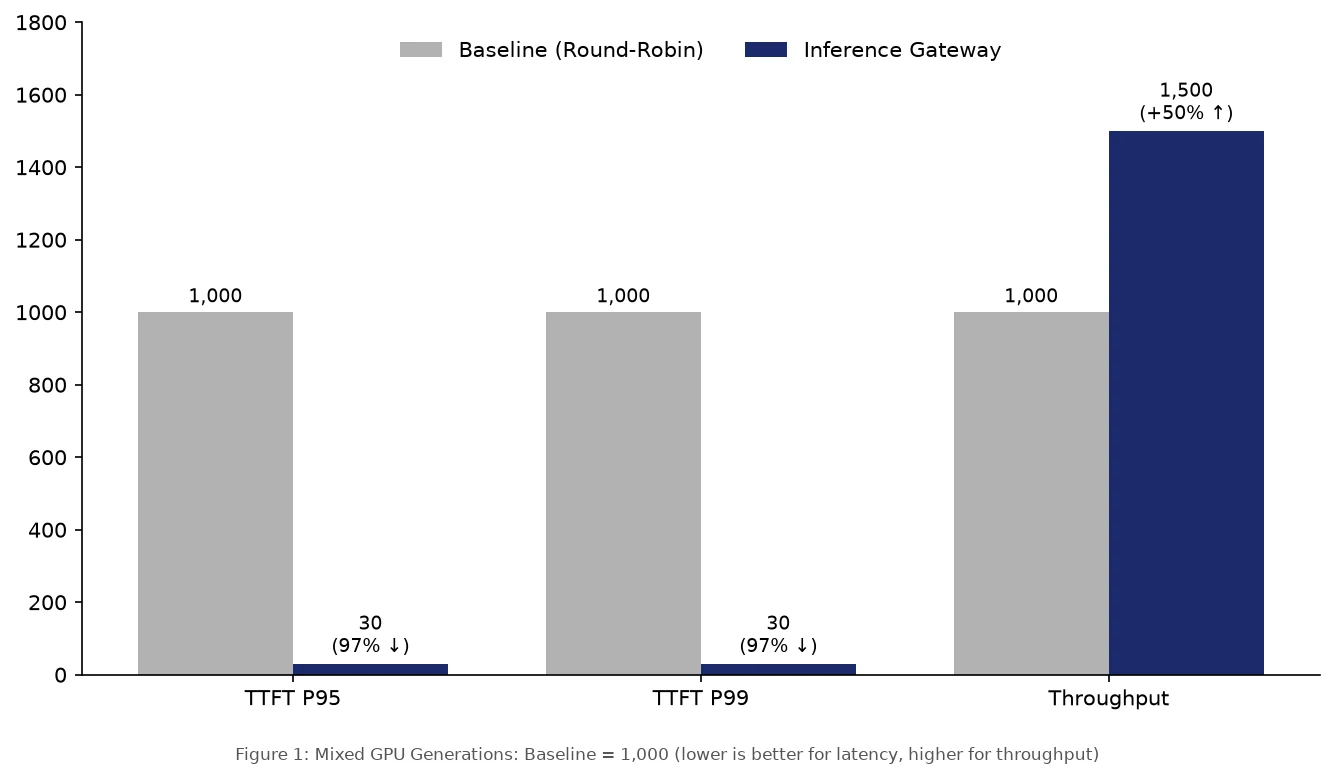
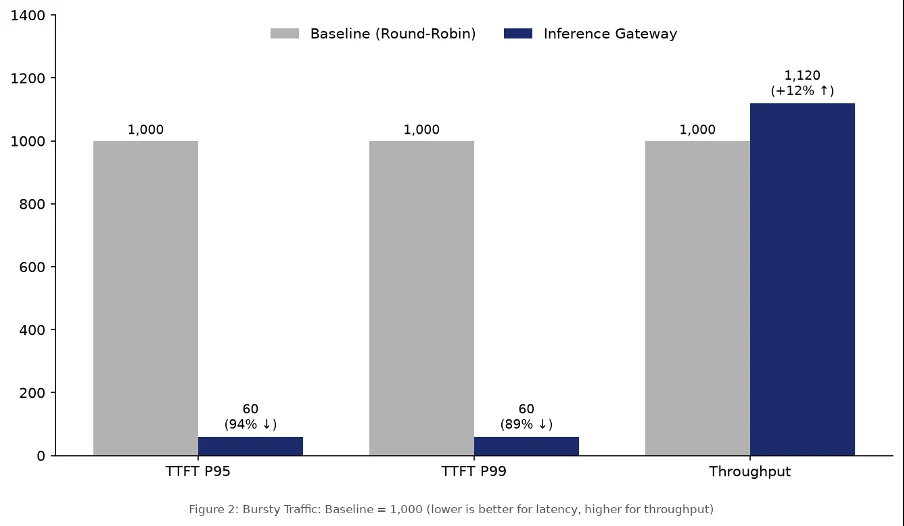
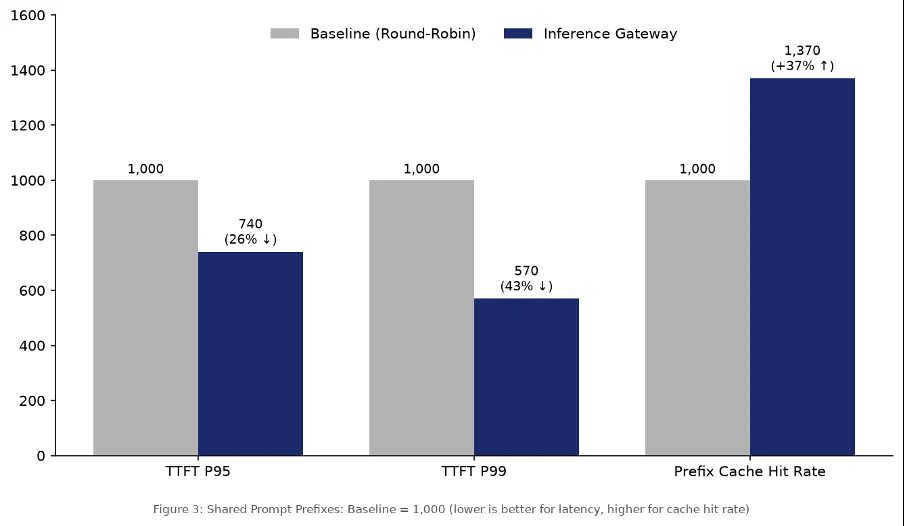
لقد أثبتت الاختبارات التي أجرتها الشركة على نماذج يتراوح حجمها من 8 مليار إلى 235 مليار معامل، أن النظام يتفوق بشكل خاص في سيناريوهات الواقع مثل التعامل مع طلبات متفجرة الحجم أو نصوص متكررة، حيث يضمن النظام توزيعاً عادلاً للعبء ورفعاً للكفاءة التشغيلية دون أي حاجة لتدخل يدوي من المبرمجين أو تعديل في كود المصدر.
المصادر
- AWS Machine Learning BlogIntroducing Amazon SageMaker HyperPod Inference Gateway