
Cloudflare Basin: منصة بيانات Serverless متاحة الآن
أصبحت منصة التحليلات الجديدة من Cloudflare متاحة للجميع، مما يفتح آفاقاً جديدة لإدارة البيانات الضخمة بكفاءة وتكلفة أقل.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق عام لمنصة Basin
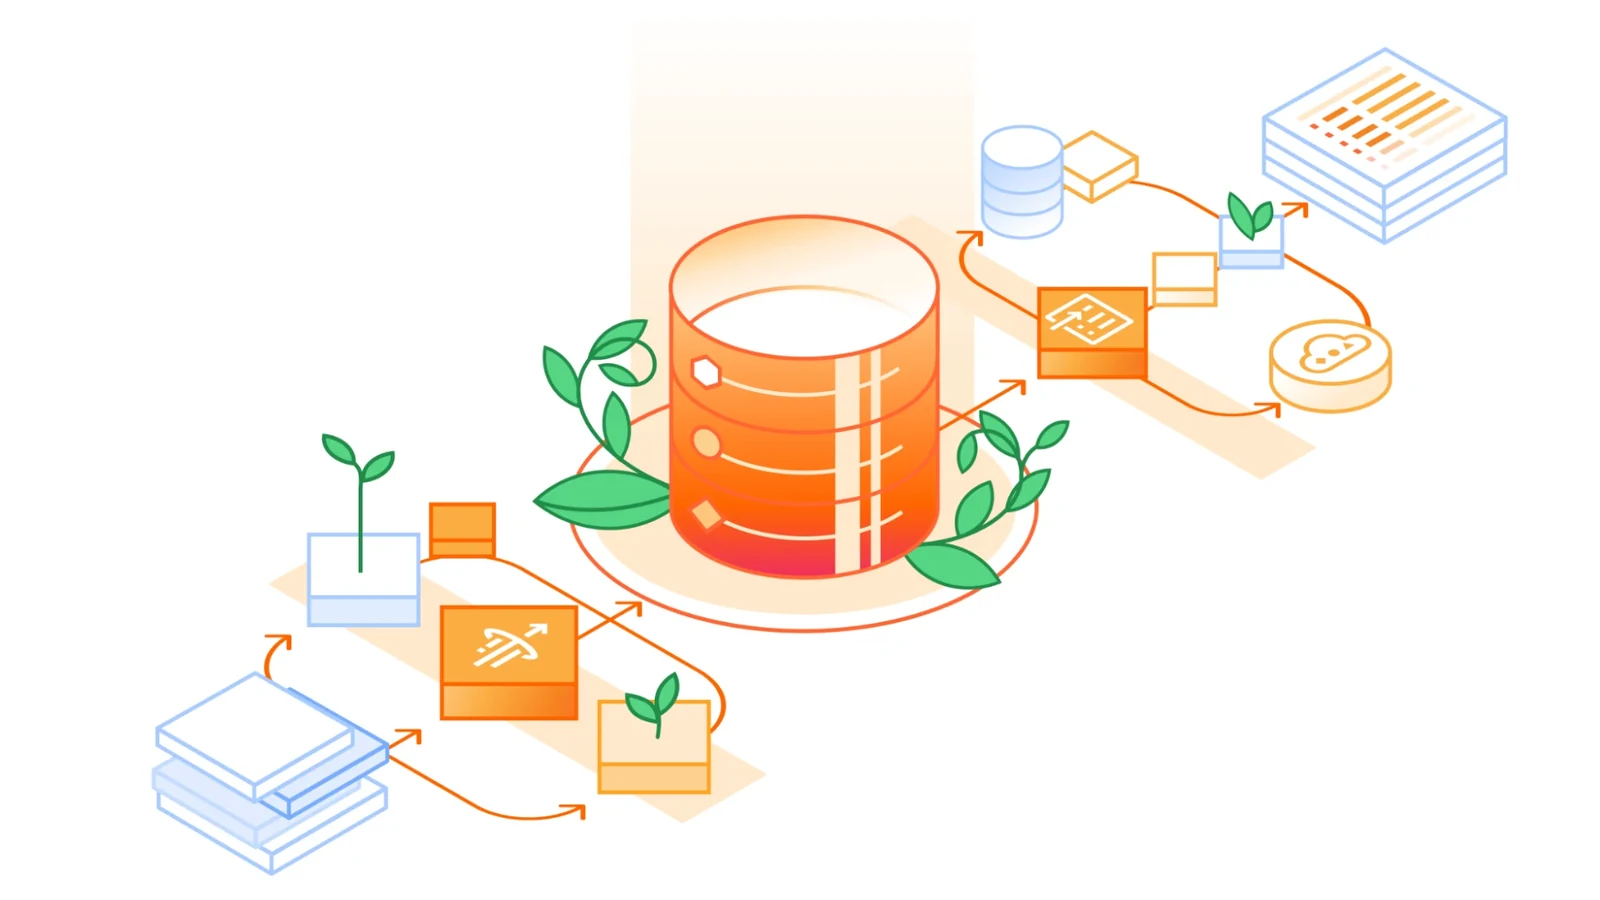
أعلنت شركة Cloudflare رسمياً عن توفر منصة Basin بشكل عام (GA)، وهي منصة تحليلات بيانات خالية من الخوادم (Serverless). تأتي هذه الخطوة بعد عام من الإطلاق التجريبي المفتوح، حيث تم إعادة تسمية منصة البيانات السابقة لتعكس طموحات الشركة في توحيد أدواتها. تعتمد المنصة بشكل أساسي على معيار Apache Iceberg المفتوح لتخزين البيانات، ومخزن الكائنات R2، مما يجعلها حلاً شاملاً لمعالجة البيانات الضخمة.
مكونات المنصة الرئيسية
تتكون عائلة Basin من ثلاثة منتجات مترابطة تغطي دورة حياة البيانات التحليلية. أولاً، Basin Pipelines (المعروفة سابقاً بـ Cloudflare Pipelines) مسؤولة عن استقبال الأحداث من مصادر متنوعة مثل Workers أو HTTP أو Logpush، وتحويلها باستخدام SQL، ثم كتابتها كجداول Iceberg أو ملفات في R2. ثانياً، Basin Catalog (سابقاً R2 Data Catalog) يدير بيانات Iceberg الوصفية (Metadata) ويحافظ تلقائياً على الجداول لضمان السرعة وكفاءة التكلفة. ثالثاً، Basin SQL (سابقاً R2 SQL) هو محرك SQL موزّع وخالي من الخوادم يتيح الاستعلام المباشر عن جداول Iceberg على شبكة Cloudflare.
السرعة وكفاءة الأداء
ركّزت Cloudflare خلال العام الماضي على تحسين سرعة المنصة، سواء في بدء التشغيل أو تنفيذ الاستعلامات الكبيرة. يتيح للمطورين إنشاء كتالوج، وإعداد خط أنابيب لاستقبال البيانات، والاستعلام عنها في ثوانٍ معدودة. هذا الأمر حاسم مع تزايد بناء تطبيقات البيانات عبر وكلاء البرمجة (Coding Agents) التي تتطلب استجابة فورية دون انتظار موارد. كما يعمل Basin Catalog على ضغط البيانات الوصفية وملفات البيانات لتقليل عمليات الإدخال والإخراج، بينما يستخدم Basin SQL الإحصائيات لتقسيم الاستعلامات إلى مهام أصغر وتوزيعها عبر Workers، مما يحافظ على الأداء حتى مع نمو حجم البيانات.
الانفتاح وقابلية نقل البيانات
يعتمد نجاح Basin جزئياً على نمو نظام Apache Iceberg المفتوح، الذي يسمح للمطورين بالاحتفاظ ببياناتهم والتحكم فيها، مع فصل طبقة التخزين عن طبقة الحساب. بفضل Basin، يمكن قراءة وكتابة البيانات باستخدام أي محرك متوافق مع Iceberg، بما في ذلك PyIceberg وDuckDB وSnowflake وApache Spark. هذه القابلية للنقل (Portability) ممكنة بفضل عدم فرض رسوم على إخراج البيانات (Zero Egress)، مما يتيح للمطورين الوصول إلى بياناتهم المخزنة لدى Cloudflare من أي أداة أو منطقة سحابية دون تكاليف إضافية.
نموذج التسعير والمرونة
تقدم المنصة نموذج تسعير مبنياً على الاستخدام (Usage-based) بفضل بنيتها الخالية من الخوادم. لا يتم احتساب الرسوم إلا عند استهلاك البيانات أو معالجتها أو الاستعلام عنها، مما يلغي الحاجة لدفع تكاليف بنية تحتية ثابتة أو رسوم شهرية. هذا النموذج يجعل بناء حلول تحليلية للمشاريع الصغيرة أو الهواة شبه مجاني، بينما يتوسع الاقتصاد بشكل منطقي مع احتياجات المؤسسات الكبيرة. كما أشارت شركة Bobsled، التي تستخدم المنصة لبناء منتجات بيانات جاهزة للذكاء الاصطناعي، إلى أن Basin تتيح الوصول في أي منطقة بتكاليف أقل بكثير وموثوقية إنتاجية عالية.
قدرات الاستقبال والتحويل
منذ الإطلاق التجريبي، أنشأ المستخدمون عشرات الآلاف من خطوط الأنابيب (Pipelines) لاستخدامات متنوعة. من الأمثلة الشائعة تحويل سجلات HTTP الخاصة بـ Cloudflare قبل تخزينها، مما يقلل من حجم التخزين المطلوب ويمنع كتابة القيم الحساسة أو غير الضرورية. وسعت Cloudflare من قابلية التوسع لتدعم استقبال ما يصل إلى 3 جيجابايت في الثانية لكل تدفق. كما أُضيفت تكاملات جديدة، مثل دمج Logpush لتحويل السجلات إلى ملفات Parquet مضغوطة أو جداول Iceberg، وجعل روابط Worker واعية بالمخطط (Schema-aware) لتوليد أنواع TypeScript تلقائياً.
الخطوات التالية للمطورين
لبدء استخدام المنصة، توفر Cloudflare شروحات تفصيلية توضح كيفية استخدام Basin Pipelines لتسليم الأحداث إلى جداول Iceberg يديرها Basin Catalog، ثم الاستعلام عنها باستخدام Basin SQL. يمثل هذا الإطلاق العام مرحلة مهمة في استراتيجية Cloudflare لتقديم منصة تحليلات متكاملة على الحافة (Edge)، تجمع بين السرعة والانفتاح وكفاءة التكلفة، وتستهدف تلبية احتياجات فرق البيانات المتقدمة في بناء وتوزيع بيانات جاهزة للذكاء الاصطناعي.
المصادر
- Cloudflare BlogIntroducing Cloudflare Basin: an open, serverless data platform, now generally available