
SageMaker HyperPod و Qumulo تتيحان تدريب نماذج الذكاء الاصطناعي عبر مناطق AWS
تجاوزت حلول التخزين السحابي التقليدية حدود الكفاءة، حيث تتيح البنية الجديدة قراءة البيانات عن بُعد بكفاءة محلية.
 رضوان عبدالهاديمحرر وكاتب تقني
تجاوز تحدي الفاصل الجغرافي بين البيانات والحوسبة
تواجه فرق الذكاء الاصطناعي تحدياً كبيراً عندما تكون موارد الحوسبة المثالية وبيانات التدريب غير موجودة في نفس منطقة AWS. يتطلب تدريب النماذج الكبيرة سعة هائلة من وحدات معالجة الرسومات، لكن الوصول إلى البيانات عبر مناطق مختلفة يضيف زمن استجابة شبكي وتكاليف نقل. كانت الخيارات التقليدية تقتصر إما على تكرار نقل بيانات ضخمة بمقدار بيتا بين المناطق، أو قبول زمن الاستجابة البيني مما يؤدي إلى إبطاء عملية التدريب. هنا يأتي دور الجمع بين Amazon SageMaker HyperPod و Qumulo، حيث يتيح هذا التآزر للفرق إبقاء نماذجها الحالية دون الحاجة إلى نقل البيانات أو التضحية بالمخرجات.
معمارية الحل: مصدر واحد للبيانات
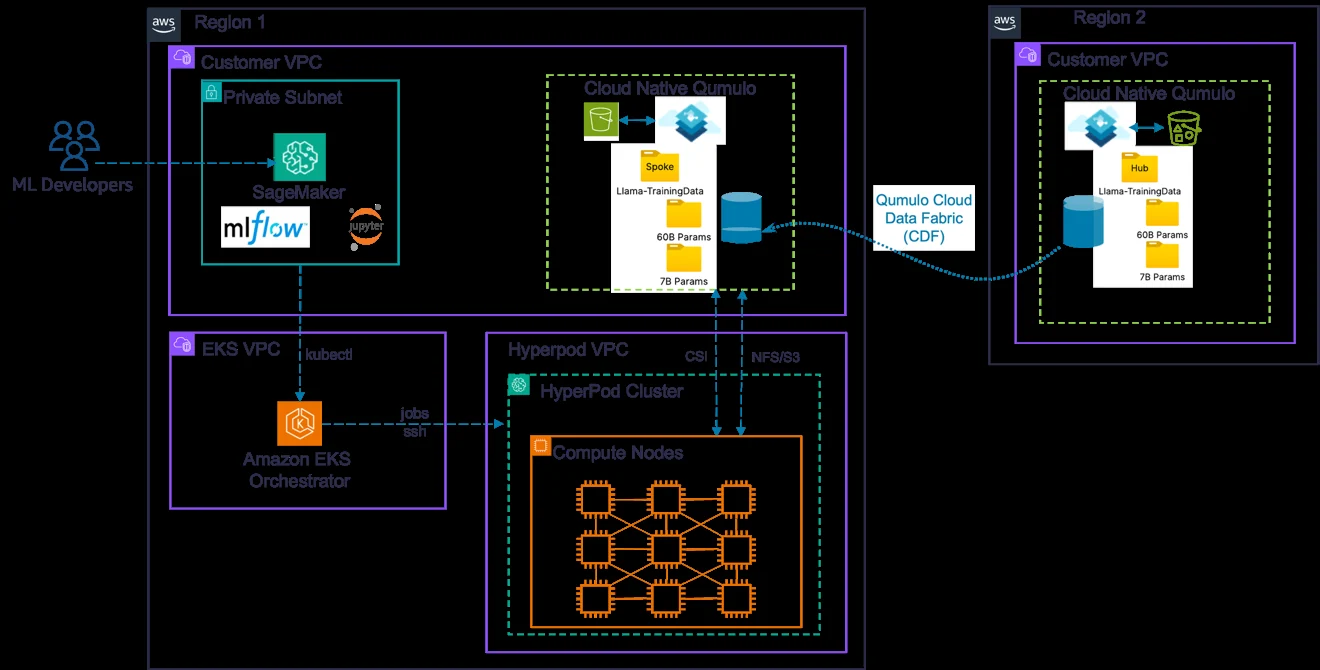
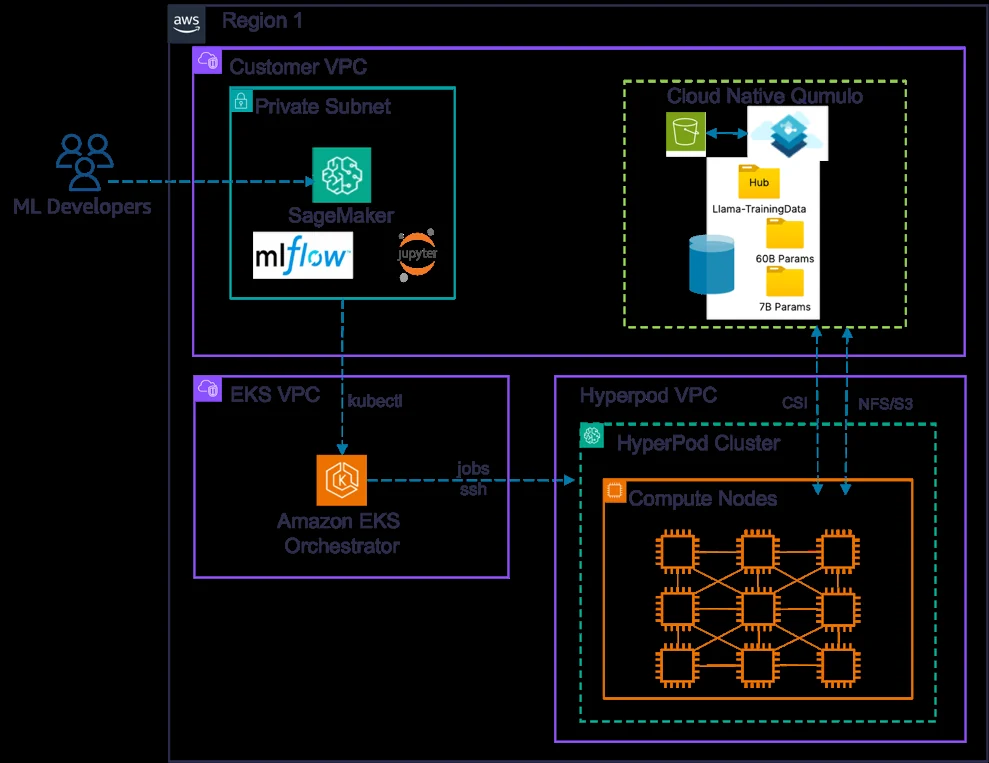
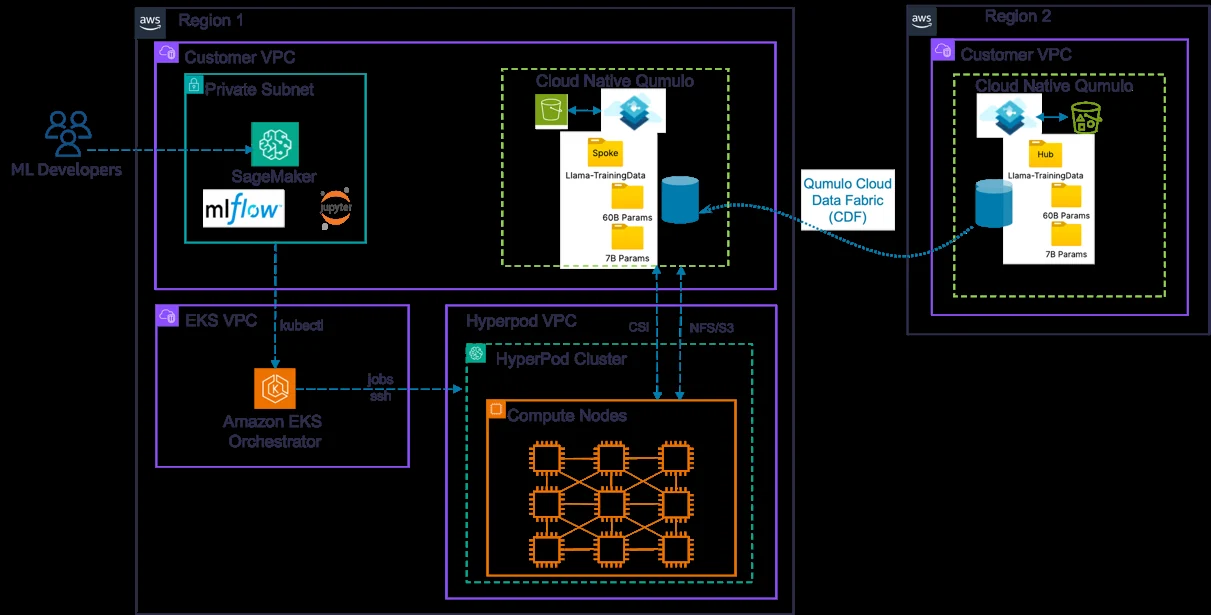
يقدم هذا الحل معمارية تعتمد على مبدأ "مصدر الحقيقة الوحيد"، حيث يتم تخزين مجموعة بيانات التدريب في منطقة AWS واحدة باستخدام Cloud Native Qumulo (CNQ). يتم ربط كل عنقود HyperPod بمثال CNQ محلي عبر نظام الملفات الشبكي (NFS). يقوم عنقود CNQ البعيد (Spoke) بجلب البيانات من العنقود المركزي (Hub) عبر ربط Virtual Private Cloud (VPC)، مما يجعل المجموعة الكاملة متاحة دون الحاجة إلى وصول مباشر من عقد الحوسبة عبر المناطق. تضمن هذه البنية أن تقرأ عقد الحوسبة من نفس مسار التركيب المحلي في كلتا المنطقتين، مما يبسط إدارة البيانات ويقلل التعقيد التشغيلي.
دور Cloud Data Fabric في إدارة البيانات
يلعب Cloud Data Fabric (CDF) دوراً محورياً في الحفاظ على نسخة واحدة موثوقة من مجموعة البيانات في العنقود المركزي، مع إسقاطها إلى عنقودات بعيدة كفضاء POSIX موحد. عند إنشاء عنقود بعيد، يقوم CDF بتكرار بيانات النظام الأساسية (Metadata) إليه، مما يسمح بتصفح مساحة الأسماء الكاملة خلال ثوانٍ قبل انتقال بيانات الملفات الفعلية. عند تركيب نظام الملفات، يخدم CDF كل عملية قراءة من أقرب مصدر صالح: من ذاكرة NVMe المحلية في حالة الإصابة، أو من العنقود المركزي في حالة عدم الإصابة. كما يستخدم CDF تحكمًا متقدمًا في الازدحام يوازن بين عرض النطاق الترددي وزمن الانتقال، مما يحافظ على معدل نقل بيانات شبه كامل حتى على المسارات التي تصل فيها زمن الرحلة الدائري (RTT) إلى 900 مللي ثانية.
التخزين المؤقت التنبؤي عبر NeuralCache
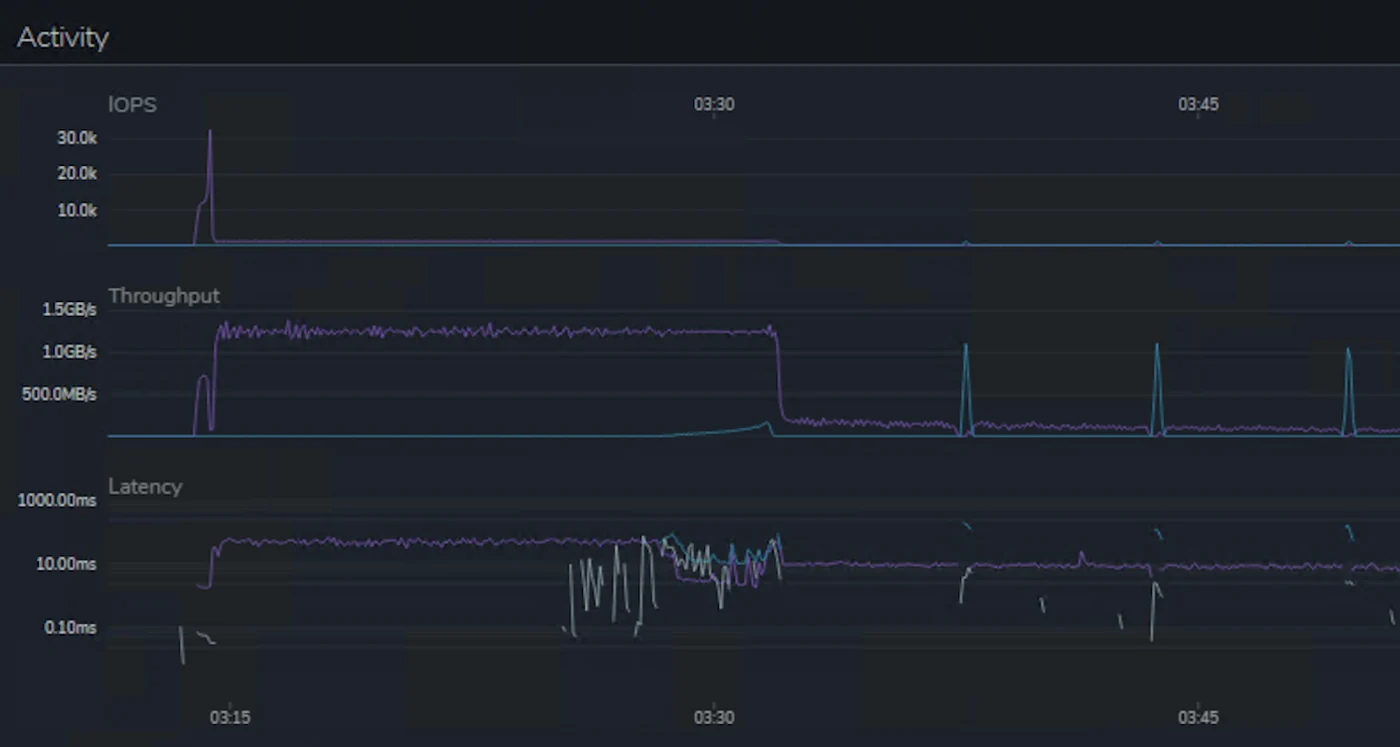
يعتبر NeuralCache طبقة التخزين المؤقت التنبؤي داخل CDF. يراقب هذا المكون قراءات كتل 4KB المتسلسلة التي يصدرها محمّل بيانات التدريب ويتعلم نمط الوصول. ثم يقوم بوضع البيانات بشكل تنبؤي قبل أن يصدر المهمة الطلب. خلال أول 100 إلى 150 دفعة، يتعلم النموذج التنبؤ بالكتل المطلوبة التالية ويجلبها مسبقاً من العنقود المركزي إلى تخزين NVMe المحلي في العنقود البعيد. بعد الإحماء، يتم تلبية 94-96% من عمليات القراءة من ذاكرة التخزين المؤقت المحلية بزمن استجابة أقل من 5 مللي ثانية، مما يجعل زمن الاستجابة بين المناطق شفافاً تقريباً.
نتائج التحقق من الأداء
تم التحقق من صحة الحل من خلال تشغيل نفس مهمة التدريب بشكل مستقل على عنقودين. شملت المهمة نموذج LLaMA v3 بمليار و20 مليون معلمة، مع استخدام عقدتي ml.p5.48xlarge لكل عنقود HyperPod، بإجمالي 16 وحدة معالجة رسومات H100. أظهرت النتائج أن العنقود البعيد، الذي يعمل في منطقة US West (Oregon) ويقرأ البيانات عن بُعد عبر CDF مع زمن استجابة شبكي 60 مللي ثانية، حقق نفس معدل الإنتاجية كالعنقود المركزي الموجود في US East (Ohio). بعد فترة إحماء قصيرة، تطابق أداء العنقود البعيد مع أداء العنقود المحلي، حيث بلغ معدل الإنتاجية بين 115 إلى 117 عينة في الثانية.
كفاءة استخدام الموارد
توفر البنية نتائج قابلة للقياس في كفاءة الموارد. أولاً، تتيح البنية السحابية الأصلية لـ CNQ توسيع الأداء بشكل مستقل عن حجم تخزين البيانات، مما يؤدي إلى استغلال كامل بنسبة 99% لوحدات معالجة الرسومات وتشبع لشبكة p5.48xlarge مع عمليات بيانات بزمن استجابة أقل من 3 مللي ثانية. ثانياً، تصل العناقيد البعيدة إلى استغلال مثالي؛ حيث يتقارب معدل الإنتاجية خلال أول 100-150 دفعة. تعتبر هذه فترة الإحماء الواحدة ضئيلة على نطاق واسع، حيث تمثل أقل من 1% من الوقت الكلي عند 10,000 دفعة، وأقل من 0.1% عند أكثر من 100,000 دفعة. نتيجة لذلك، تصل كفاءة وحدات معالجة الرسومات إلى 80-90% في المرحلة الأولية، ثم تستقر عند 98-100%.
المصادر
- AWS Machine Learning BlogMulti-Region training with Amazon SageMaker HyperPod and Qumulo