أمازون تتيح تدريب نماذج الذكاء الاصطناعي متعددة الأدوار عبر SageMaker
تتيح تقنية MTRL تدريب نماذج الذكاء الاصطناعي على نتائج المهام الكاملة بدلاً من الخطوات الفردية، مما يحسن أداء الوكلاء في سيناريوهات العمل المعقدة.
 رضوان عبدالهاديمحرر وكاتب تقني
تحدي التدريب التقليدي في المهام الوكيلة
يعاني التدريب الإشرافي التقليدي من عدم قدرته على التعامل مع المهام الوكيلة المعقدة التي تتطلب تسلسلاً من الإجراءات المترابطة. في هذه السيناريوهات، يعتمد كل قرار على الخطوات السابقة، ولا يوجد مسار واحد صحيح يمكن تقليده، مما يجعل التقييم النهائي هو المقياس الوحيد الموثوق لنجاح المهمة. ويمكن الرجوع إلى AWS Machine Learning Blog للاطلاع على التفاصيل الأصلية للمصدر.
تعالج تقنية التعلم المعزز متعدد الأدوار (MTRL) هذا التحدي من خلال تدريب النماذج على الإشارة النهائية لنتيجة المهمة بأكملها. يتيح هذا النهج للنماذج فهم السياق الكامل للمهمة بدلاً من التركيز على خطوات معزولة، مما يحسن من قدرتها على اتخاذ القرارات في بيئات العمل الديناميكية.
آلية عمل MTRL على منصة SageMaker AI
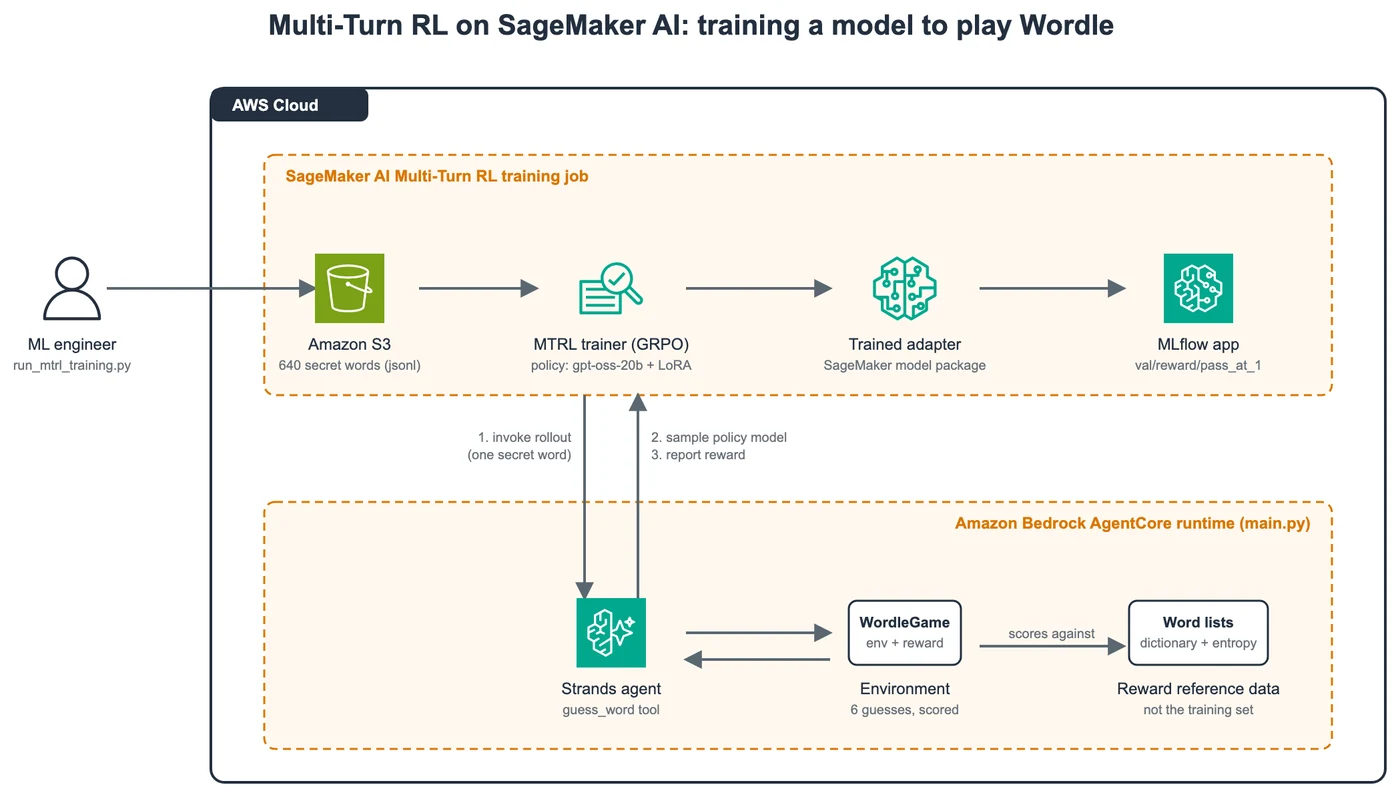
يعمل النظام من خلال إرسال أوامر إلى وكيل يستضيفه Amazon Bedrock AgentCore أو على بنية تحتية خاصة مثل Amazon EKS أو Amazon EC2. يتواصل الوكيل مع نموذج السياسة عبر نقطة نهاية متوافقة مع OpenAI، ويتخذ الإجراءات اللازمة في البيئة حتى انتهاء المهمة، ثم يعيد مكافأة واحدة تعكس النتيجة النهائية.
تستخدم الخوارزمية تحسين السياسة النسبية للمجموعات (GRPO) لتحديث محول LoRA على نموذج السياسة بناءً على توزيع المكافآت عبر عدة محاولات لنفس الكلمة. هذا يسمح للنموذج بتعلم الاستراتيجيات الأكثر فعالية من خلال مقارنة النتائج المختلفة لنفس المدخلات.
النموذج التعليمي: لعبة Wordle
تستخدم أمازون لعبة Wordle كمثال توضيحي لتطبيق MTRL، حيث يجب على اللاعب تخمين كلمة من خمسة أحرف خلال ست محاولات. توفر اللعبة قواعد بسيطة وموضوعية، مما يجعلها مثالية لتوضيح كيفية عمل التعلم المعزز متعدد الأدوار في بيئات ذات تغذية راجعة فورية.
على الرغم من أن النماذج المتقدمة تلعب هذه اللعبة بفاعلية، إلا أن الهدف من استخدام MTRL هو تمكين النماذج الأصغر والأقل تكلفة من إتقان مهام متعددة الخطوات محددة لكل شركة، مثل سير العمل الداخلي الذي لم يتم تدريب النماذج العامة عليه.
نتائج الأداء والتكاليف
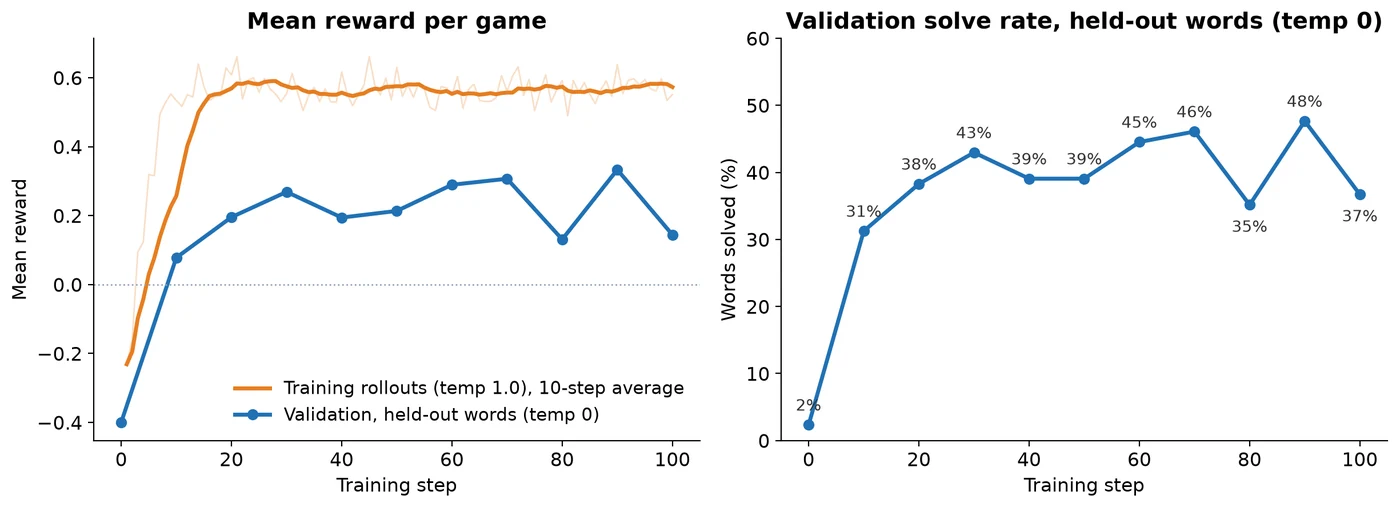
أظهرت التجارب أن تقنية MTRL رفعت معدل حل الكلمات للنموذج gpt-oss-20b من 61% إلى 84% عند استخدام جهد الاستدلال الافتراضي، ومن 15% إلى 69% عند الجهد المنخفض. بلغت تكلفة التدريب حوالي 339 دولاراً أمريكياً، مع استهلاك 491.6 مليون توكن للمعالجة المسبقة و159.7 مليون توكن للعينة.
تتضمن التكاليف أيضاً رسوم التشغيل على Amazon Bedrock AgentCore، والتي بلغت حوالي 79 دولاراً أمريكياً في هذه التجربة. تعتمد التكلفة النهائية على طول المسار وجهد الاستدلال، مما يتيح للمستخدمين التحكم في الميزانية من خلال ضبط هذه المعاملات.
متطلبات التنفيذ والأدوار
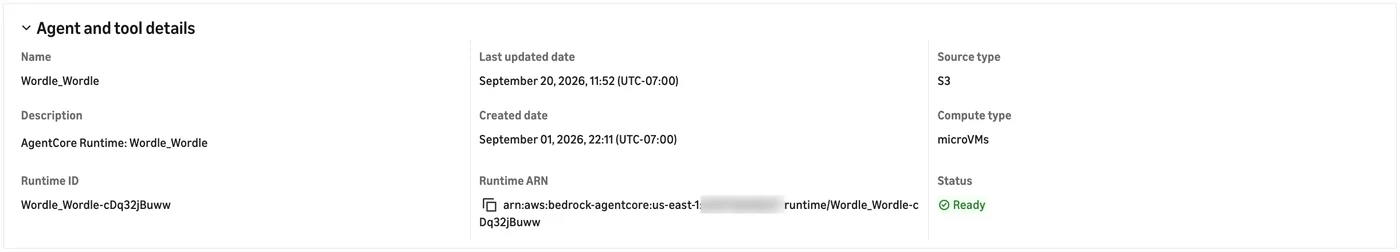
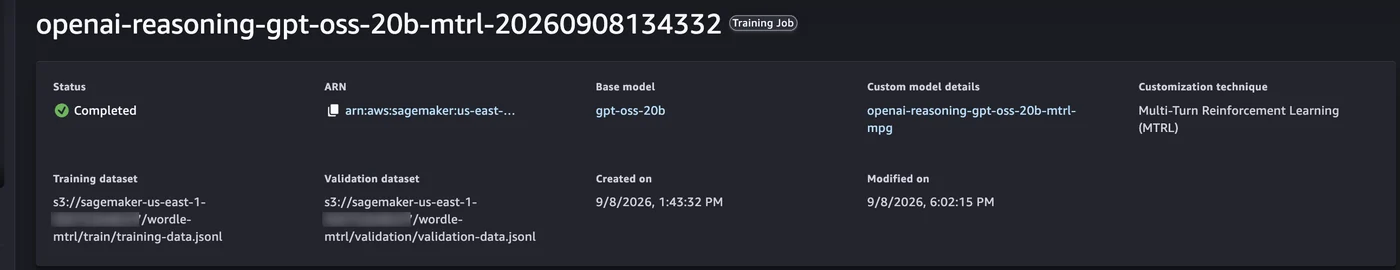
يتطلب تنفيذ هذا الدليل وجود بيئة تطوير تحتوي على Python 3.10 أو أحدث، وuv، وNode 20 أو أحدث، بالإضافة إلى واجهة AgentCore. كما يتطلب الأمر إنشاء دورين IAM منفصلين: واحد لتشغيل الوكيل وواحد لوظيفة التدريب، مع ضمان أن كلاهما يثق بالكيانات الصحيحة في AWS.
يجب أن يكون مستودع Amazon S3 في نفس المنطقة الجغرافية للوكيل، لأن عملية إنشاء الوظيفة ترفض المعرفات عبر المناطق. توفر المستودعات الرسمية أدوات جاهزة لتسهيل هذا الإعداد، مع التأكد من أن البيانات والنماذج المدربة تبقى ضمن حساب AWS الخاص بالمستخدم.
المصادر
- AWS Machine Learning BlogMulti-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
هجرة وكلاء الذكاء الاصطناعي متعدد النماذج إلى Amazon Bedrock AgentCore
تقدم AWS نمطاً تقنياً لنقل وكلاء الذكاء الاصطناعي متعدد النماذج من بنية ذاتية الإدارة إلى Amazon Bedrock AgentCore runtime مع الحفاظ على تنسيق النماذج وتقليل العبء التشغيلي.
أمازون تعيد ضبط وكيل بحث بالذكاء الاصطناعي عبر التعلم المعزز متعدد الأدوار
تقدم أمازون ويب سيرفيسز طريقة جديدة لضبط وكيل بحث صغير باستخدام التعلم المعزز متعدد الأدوار على SageMaker AI، مما يحقق موثوقية النماذج المتقدمة بتكلفة وزمن استجابة أقل.
أمازون تتيح بناء وكلاء ذكاء اصطناعي اقتصاديين عبر تقطير المعرفة
تشرح أمازون كيفية استخدام تقطير المعرفة التسلسلي على SageMaker AI لنقل سلوك النماذج الكبيرة إلى نماذج أصغر، مما يقلل التكاليف التشغيلية للوكلاء الذكيين.
أمازون تتيح نشر نماذج القرار عبر llama.cpp على SageMaker AI
تشرح أمازون كيفية استخدام حاويات التعلم العميق لنشر نماذج llama.cpp على SageMaker AI، مع إضافة SemIf لإرجاع احتمالات الخيارات المحددة بدقة على معالجات CPU أو GPU.