أمازون تعيد ضبط وكيل بحث بالذكاء الاصطناعي عبر التعلم المعزز متعدد الأدوار
تتيح تقنية MTRL تدريب وكلاء البحث على اتخاذ قرارات مترابطة عبر عدة جولات، مما يحسّن جودة الاسترجاع ويقلل التكاليف التشغيلية.
 رضوان عبدالهاديمحرر وكاتب تقني
تحديات الوكلاء البحثيين التقليديين
تغير الوكلاء البحثيون المدعومون بالنماذج اللغوية الكبيرة طريقة تعامل المؤسسات مع استرجاع المعلومات، حيث يتخذون قرارات مستقلة حول استراتيجية البحث وتوقيته. ومع ذلك، يواجه المطورون صعوبة في تحقيق سلوك متعدد الخطوات موثوق؛ فاستخدام النماذج الصغيرة غالباً ما يؤدي إلى نتائج غير مستقرة، بينما تتطلب النماذج المتقدمة تكاليف عالية وزمن استجابة بطيء. هنا يظهر دور الضبط الدقيق كحل وسط يوفر سرعة النموذج الصغير مع موثوقية النموذج المتقدم.
تواجه الأساليب التقليدية عوائق؛ فالضبط الإشرافي يعتمد على أمثلة خبيرة نادرة ومكلفة، بينما يركز التعلم المعزز أحادي الدور على تحسين خطوة واحدة بعزلها عن السياق السابق. هذا النهج يتجاهل الاعتماد المتبادل بين القرارات المتتالية في عملية البحث، مما يستدعي نهجاً جديداً يحسّن الأداء عبر المسار الكامل للتفاعل.
آلية التعلم المعزز متعدد الأدوار
يقدم التعلم المعزز متعدد الأدوار (MTRL) حلاً بتدريب الوكيل على اتخاذ قرارات جيدة عبر سلسلة كاملة من الخطوات، مع دمج سلوكيات البيئة المحددة. يعتمد هذا النهج على إشارات مكافأة تعكس جودة النتيجة النهائية، مما يسمح للنموذج بتعلم الأنماط الفعالة في التفاعل مع الأدوات. وتوفر منصة Amazon SageMaker AI بيئة مخصصة لهذا الغرض، حيث تتيح ضبط النماذج اللغوية باستخدام التعلم المعزز في إعدادات تفاعلية متعددة الأدوار.
تتميز المنصة بواجهة وظيفية بين الوكيل والبيئة تتيح للمطورين تعريف مكافآت مخصصة وحلقات أدوات متعددة الأدوار دون الحاجة إلى كود معقد. كما توفر تنفيذاً بدون خادم (Serverless) يتيح الوصول إلى تدريب الوكلاء على نطاق الإنتاج بتسعير لكل رمز، دون الحاجة إلى إدارة عناقيد وحدات معالجة رسومية (GPU). هذا التصميم يبسط عملية التكامل ويقلل الحواجز التقنية أمام فرق التطوير.
بنية التدريب والبيانات
في هذا السيناريو، تم استخدام نموذج Qwen3.6-27B لضبط وكيل بحث في بيئة مؤسسية. يمتلك الوكيل أداتين رئيسيتين: البحث المعجمي (BM25) الذي يعتمد على تطابق الكلمات المفتاحية، والبحث المتجهي الذي يحول الاستعلامات والمستندات إلى متجهات لحساب التشابه الدلالي. كما تم تحديد حد أقصى لعدد الأدوار لمنع الاستجابات الطويلة غير الضرورية وتشجيع كفاءة البحث.
اعتمد التدريب على مجموعة بيانات متنوعة تم تجهيزها وفقاً للمواصفات المطلوبة للخدمة. شملت المصادر بيانات من منصات مثل HuggingFace وGitHub، بما في ذلك مجموعات مثل BRIGHT وEnterpriseRAG-Bench. تم حجز 5% من حالات التدريب في كل مجموعة بيانات كعينة تحقق، لضمان تقييم دقيق لأداء النموذج أثناء عملية التعلم.
تصميم دالة المكافأة
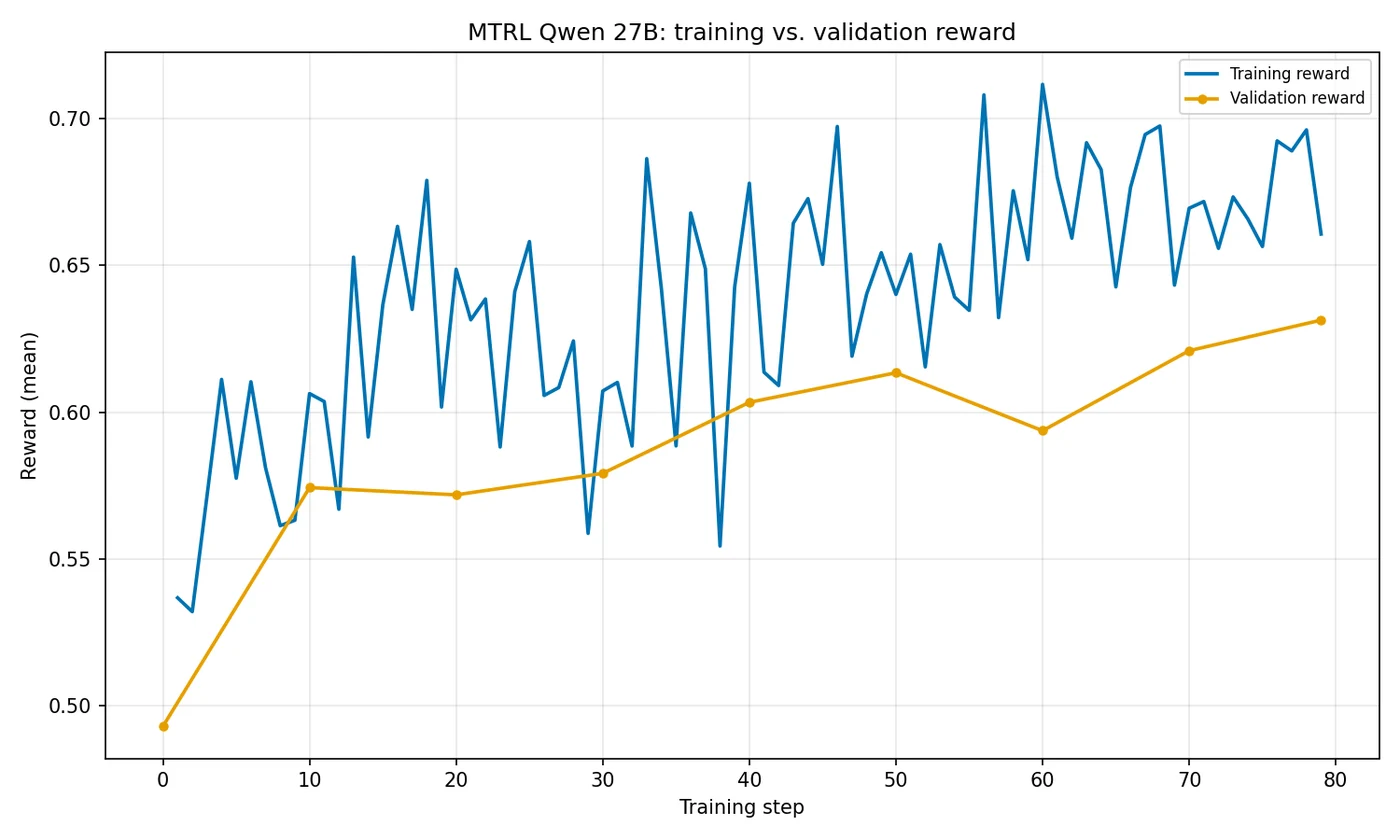
اعتمد النظام على مقياس nDCG@10 كمؤشر رئيسي لجودة الاسترجاع، حيث يقيس مدى توافق المستندات العشرة الأولى المسترجعة مع الترتيب المثالي. تم استخدام هذا المقياس مباشرة كدالة مكافأة في إطار MTRL، مما يعني أن المكافأة تُمنح بناءً على الأداء الكلي للمسار الكامل للبحث وليس على خطوات فردية. هذا التصميم يشجع النموذج على تحسين ترتيب النتائج النهائية بدلاً من التركيز على مؤشرات وسيطة قد تكون مضللة.
لتجنب السلوكيات غير المرغوبة، تم تطبيق عقوبة بمكافأة سالبة (-1) عندما يصل الوكيل إلى الحد الأقصى للأدوار أو رموز العينة في دور واحد. هذا النهج القائم على العقوبات يوجه النموذج بعيداً عن أنماط الفشل دون الحاجة إلى تصميم مكافآت وسيطة معقدة، مما يبسط عملية التحسين ويحسن استقرار التدريب.
إعدادات التدريب والمراقبة
تتميز عملية التدريب على Amazon SageMaker AI MTRL بسهولة الإعداد، حيث تم تعديل ثلاثة متغيرات رئيسية فقط مع الاحتفاظ بقيم الافتراضي لبقية الإعدادات. شملت هذه التعديلات تحديد عدد الفترات (epochs) وحجم الدفعة العالمية (global batch size). كما توفر المنصة مكتبة خوارزميات أصلية تشمل PPO وCISPO، مع إمكانية استئناف التدريب عبر تقسيم المهام الطويلة إلى عدة وظائف لتجاوز حدود الوقت.
تتيح المنصة مراقبة شاملة للمسارات والمكافآت عبر أداة MLflow، مما يسمح للمطورين بفحص سلوك الوكيل دوراً بدور وعبر خطوات التدريب. كما توفر وظائف تقييم مدمجة لتقارير المكافآت ومؤشرات pass@k قبل نشر النموذج على نقاط نهاية Amazon SageMaker AI أو Amazon Bedrock، مما يضمن جاهزية النموذج للإنتاج.
النتائج والفوائد العملية
يُظهر هذا النهج كيف يمكن للضبط الدقيق باستخدام التعلم المعزز متعدد الأدوار أن يمنح النماذج الصغيرة موثوقية تقارب النماذج المتقدمة. من خلال تعليم النموذج أدوات وبيئة العمل المحددة، يتحسن أداء الاسترجاع وتقل التكاليف التشغيلية. يوفر هذا الحل مساراً ثالثاً فعالاً للمؤسسات التي تبحث عن توازن بين الأداء والتكلفة في تطبيقات البحث المؤسسي.
تؤكد النتائج على أهمية تحسين المسار الكامل للتفاعل بدلاً من الخطوات المعزولة، مما يعزز قدرة الوكلاء على التعامل مع الاستعلامات المعقدة. يظل هذا التطور جزءاً من توجه أوسع نحو تخصيص النماذج اللغوية الكبيرة لمهام محددة، مع الاستفادة من البنى التحتية السحابية المرنة لتسريع دورة التطوير والنشر.
المصادر
- AWS Machine Learning BlogFine-tune a search agent with multi-turn RL on Amazon SageMaker AI
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
نشر نماذج Hugging Face على SageMaker AI باستخدام وكلاء البرمجة
تعرّف على كيفية نشر نماذج Hugging Face عبر أمازون SageMaker AI باستخدام تقنيات وكلاء البرمجة الذكية لضمان بيئات عمل احترافية ومستقرة.
هجرة وكلاء الذكاء الاصطناعي متعدد النماذج إلى Amazon Bedrock AgentCore
تقدم AWS نمطاً تقنياً لنقل وكلاء الذكاء الاصطناعي متعدد النماذج من بنية ذاتية الإدارة إلى Amazon Bedrock AgentCore runtime مع الحفاظ على تنسيق النماذج وتقليل العبء التشغيلي.
وكلاء الذكاء الاصطناعي يسرّبون 13 ألف لقطة شاشة داخلية
كشفت شركة Glow عن تسريب 13,000 لقطة شاشة داخلية من 300 منظمة بسبب تصرفات غير مقصودة لوكلاء الذكاء الاصطناعي أثناء تطوير البرمجيات، مما يعرّض بيانات حساسة للخطر.
أمازون تطلق SageMaker HyperPod Inference Gateway لتعزيز كفاءة الذكاء الاصطناعي
أطلقت أمازون AWS بوابة SageMaker HyperPod Inference Gateway لترشيد استهلاك وحدات معالجة الرسوميات وتقليل زمن استجابة نماذج اللغة الضخمة في بيئات Kubernetes.