
AWS تتيح بناء تطبيقات صوتية فورية عبر vLLM-Omni على SageMaker
تقدّم شركة AWS حلاً تقنياً جديداً لتسريع استجابة التطبيقات الصوتية من خلال بثّ الصوت أثناء توليده، بدلاً من انتظار اكتمال النص كاملاً.
 رضوان عبدالهاديمحرر وكاتب تقني
تسريع استجابة الوكلاء الصوتيين
تواجه التطبيقات الصوتية التفاعلية، وأدوات إمكانية الوصول، ومساعدات خدمة العملاء تحدياً رئيسياً يتمثل في التأخير الزمني بين معالجة الطلب وعرض النتيجة. لسد هذه الفجوة، تتيح شركة AWS الآن نشر نماذج تحويل النص إلى كلام (TTS) على منصة Amazon SageMaker AI باستخدام حاوية تعلم عميق متخصصة تُعرف باسم AWS vLLM-Omni Deep Learning Container. تتيح هذه التقنية بدء تشغيل الصوت قبل انتهاء النموذج من توليد الرد الكامل، مما يقلل من فترات الصمت المزعجة للمستخدمين.
توسيع قدرات vLLM ليشمل الوسائط المتعددة
يُعد مشروع vLLM-Omni امتداداً لتقنية vLLM الشهيرة، حيث يوسع نطاقها من توليد النصوص فقط إلى معالجة وتوليد الوسائط المتعددة مثل الصوت والصور والفيديو. توفر هذه الحاوية طبقة تجريد تسهّل إدارة خطوط الأنابيب المعقدة التي تتضمن مراحل متعددة، بدءاً من التوليد التلقائي وحتى مراحل الانتشار (Diffusion). كما توفر واجهات برمجية متوافقة مع معايير OpenAI، مما يسهّل على المطورين دمج هذه القدرات في تطبيقاتهم الحالية دون الحاجة إلى إعادة بناء البنية التحتية بالكامل.
آلية البث الثنائي الاتجاه
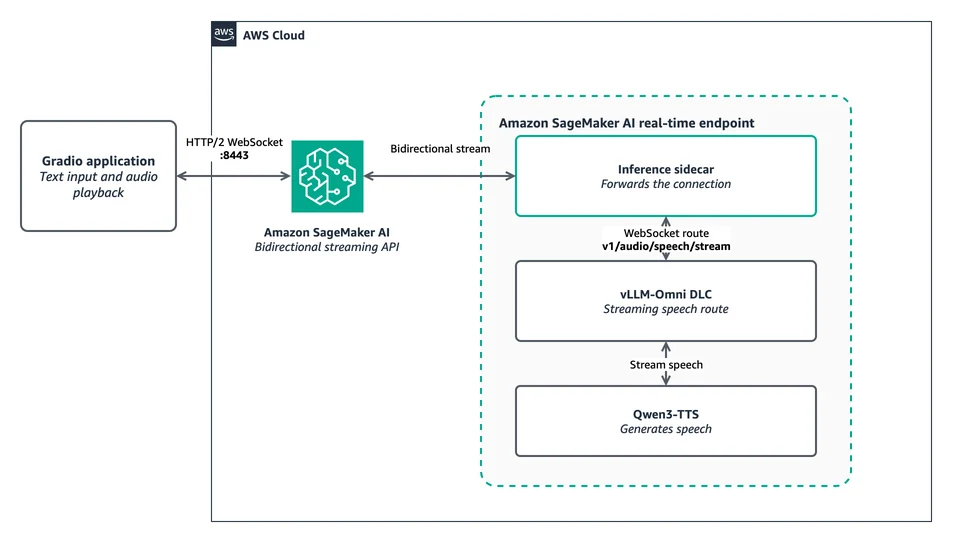
تعتمد هذه التقنية على ميزة البث الثنائي الاتجاه (Bidirectional Streaming) في SageMaker، والتي تستغل بروتوكول WebSocket فوق HTTP/2 لإنشاء اتصال دائم بين العميل والخادم. من خلال هذا الاتصال، يمكن إرسال النص إلى النموذج واستقبال مقاطع الصوت (Audio Chunks) فور توليدها. في هذا الجزء من الشرح، يتم استخدام نموذج Qwen3-TTS كمثال تطبيقي، حيث تُرسل النصوص عبر واجهة Gradio، ويعود الصوت المولد بجودة 24 كيلو هرتز عبر نفس القناة، مما يضمن استمرارية التدفق وسلاسة التجربة.
إدارة الموارد وتوزيع النماذج
لتحسين كفاءة التكلفة والأداء، يستخدم النظام ميزة مجمعات الحواسيب (Instance Pools) في SageMaker. يسمح هذا الإعداد بتحديد قائمة بأولويات لأنواع الحواسيب المتوافقة، مثل ml.g6.xlarge أو ml.g5.xlarge. يقوم النظام بمحاولة تخصيص الموارد من النوع الأول، وفي حال عدم توفرها، ينتقل تلقائياً إلى النوع التالي. يتطلب هذا الإعداد ضمان توفر الحصة (Quota) اللازمة لجميع أنواع الحواسيب المدرجة في القائمة، مع إمكانية تخصيص القائمة لتتناسب مع متطلبات الأداء والميزانية المحددة.
المتطلبات التقنية والإعداد
يتطلب تنفيذ هذا الحل امتلاك حساب AWS مع صلاحيات إنشاء واستدعاء نقاط النهاية (Endpoints) على SageMaker AI. كما يحتاج المطور إلى تثبيت عميل Python الخاص بـ SageMaker Runtime الإصدار 0.4.0 لدعم اتصالات HTTP/2. يتضمن الإعداد استنساخ مستودع أمثلة AWS، وتكوين الدور التنفيذي (Execution Role)، وتحديد مسار استدعاء النموذج بشكل صحيح لضمان تمرير الطلبات عبر وسيط الاستدلال (Sidecar) إلى حاوية vLLM-Omni داخل النظام.
مستقبل السلسلة التقنية
يُعد هذا المقال الجزء الأول من سلسلة تقنية تركز على حاويات التعلم العميق المتخصصة (Specialized DLCs) التي توفرها AWS. بينما يركز هذا الجزء على معالجة الصوت الفوري، ستتناول الأجزاء اللاحقة تطبيقات أخرى مثل توليد الصور والفيديو باستخدام نفس البنية التحتية. تهدف هذه السلسلة إلى تقديم أمثلة عملية قابلة للتكرار مع مقاييس أداء دقيقة، مما يساعد المطورين على اتخاذ قرارات مستنيرة عند بناء تطبيقات الذكاء الاصطناعي متعددة الوسائط.
المصادر
- AWS Machine Learning BlogBuild real-time voice applications with vLLM-Omni on SageMaker AI – Part 1