إطلاق نموذج Falcon-Emirati-7B المخصص لللهجة الإماراتية
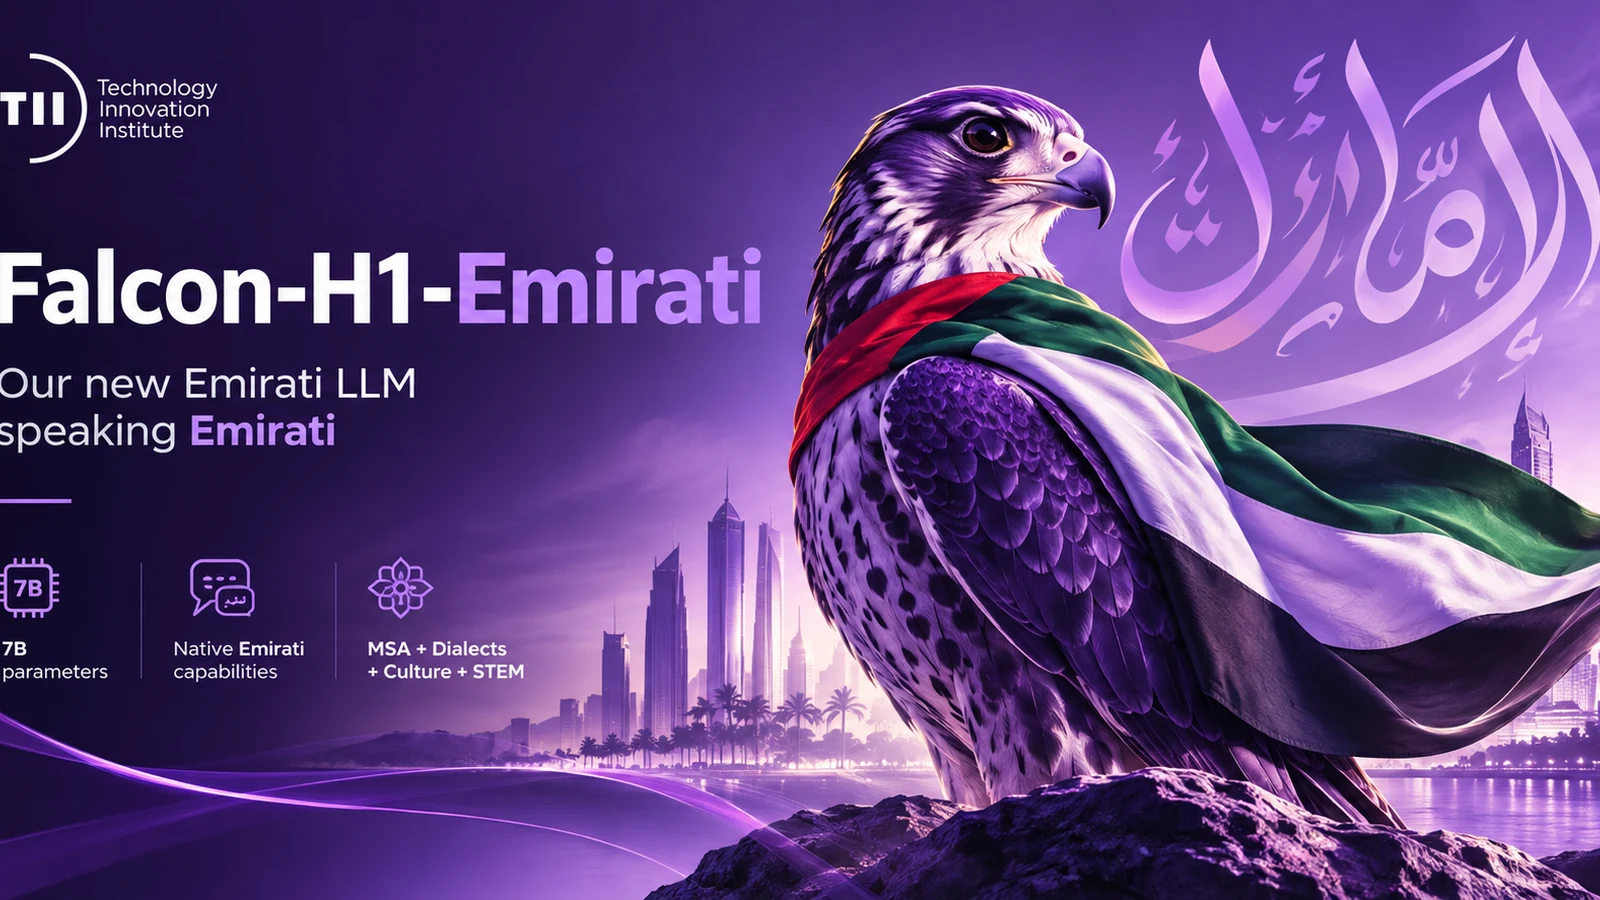
أطلق فريق معهد الابتكار التكنولوجي نموذج Falcon-Emirati-7B كنسخة متخصصة مبنية على نموذج Falcon-H1-Arabic لفهم اللهجة والثقافة الإماراتية بعمق.
 رضوان عبدالهاديمحرر وكاتب تقني
دوافع التطوير وتحديات اللهجات المحلية
تُعد اللغة العربية عائلة من اللغات المتنوعة، حيث تختلف الفصحى المستخدمة في الأخبار والكتب كثيراً عن لغة التواصل اليومي والقصص والأمثال الشعبية. في دولة الإمارات، تحمل اللهجة المحلية، بما فيها من مفردات وإيقاع وثقافة متجذرة في الشعر النبطي والأمثال، معاني دقيقة لا تظهر عند القراءة الحرفية المباشرة. ولهذا السبب، تم تطوير النموذج الجديد لسد الفجوة التي تواجه النماذج التقليدية عند التعامل مع التعبيرات المحلية. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
يقدم معهد الابتكار التكنولوجي عبر مدونة <a href="https://huggingface.co/blog/tiiuae/falcon-emirati">Hugging Face Blog</a> تفاصيل تقنية حول كيفية تخصص النموذج في فهم اللهجة الإماراتية وتوليدها بأسلوب متحدث أصلي، متجاوزاً الترجمة الحرفية إلى استيعاب السياق الثقافي الحقيقي.
البنية الهجينة والقدرات التقنية للنموذج
بُني النموذج الجديد فوق عائلة نماذج Falcon-H1-Arabic التي حققت نتائج متقدمة سابقاً. تعتمد هذه العائلة على بنية هجينة تدمج نماذج حالة الفضاء المعروفة بـ Mamba مع آليات انتباه Transformer لتشغيلها بالتوازي داخل كل كتلة. هذه الميزة تمنح النموذج كفاءة زمنية خطية مع التسلسلات الطويلة، مع الحفاظ على الدقة المطلوبة للغات الغنية مورفولوجياً مثل العربية.
تتوفر عائلة النماذج الأساسية بثلاثة أحجام مختلفة تشمل 3 مليارات و7 مليارات و34 مليار معامل، وتدعم نوافذ سياق واسعة النطاق تتراوح بين 128 ألف و256 ألف رمز، وقد تدربت مسبقاً على مزيج واسع من الفصحى واللهجات العربية المختلفة إلى جانب اللغات الأخرى.
اختيار الحجم الأنسب وتجاوز ندرة النصوص المكتوبة
وقع الاختيار على نسخة السبعة مليارات معامل لتكون النقطة المثلى للنموذج المتخصص؛ فهي بحجم كافٍ لاستيعاب الفروق الدقيقة التي يتطلبها التكيف اللهجي، وفي الوقت ذاته عملية بما يكفي من حيث تكاليف التدريب والاستنتاج. وبسبب الاعتماد الشفهي الكبير للهجة الإماراتية وقلة النصوص المكتوبة مقارنة بالفصحى، واجه المطورون تحديات في ندرة البيانات الخام ونقص الأدلة الجاهزة الموثوقة.
تطلب الأمر ابتكار خط بيانات خاص يعتمد على استخراج المحتوى من المواقع والمنتديات المحلية المكتوبة باللهجة أصلاً، إلى جانب دمج مواد مكتوبة بالفصحى تتناول الثقافة والتراث والعادات والتقاليد المحلية لترسيخ الخلفية المعرفية للنموذج.
البيانات التوليدية والتدريب التجريبي
لكت تغطية مختلف موضوعات المحادثة اليومية تطلبت أكثر من مجرد البيانات المجمعة، فلجأ الفريق لتوليد بيانات تركيبية موجهة باستخدام قواعد صارمة وقواميس مخصصة لمفردات وقواعد اللهجة الإماراتية. هذا الضبط الدقيق حال دون انحراف المخرجات نحو لغة خليجية عامة وضمن خروج نصوص تبدو طبيعية تماماً للمتحدث الأصلي.
شملت منهجية التطوير تجارب متعددة حول نسب خلط البيانات، ومراحل التدريب المختلفة، وطرق دمج البيانات التركيبية مع المحتوى الأصلي لضمان تجنب فرط التخصيص أو الخروج عن السياق الثقافي السليم.
معايير التقييم والمراجعة البشرية
لضمان جودة الأداء، اعتمد الفريق على نهج مزدوج يجمع بين المراجعة المباشرة من متحدثين أصليين باللهجة الإماراتية لتقييم الطبيعية والنغمة والملاءمة الثقافية، واستخدام معيار كمي يسمى ألياه أو 'North Star' الذي صُمم خصيصاً لقياس قدرات النماذج الكبيرة في التعامل مع اللهجة الإماراتية عبر أكثر من ألف عينة تغطي التحيات والآداب والمعارف التراثية.
المصادر
- Hugging Face BlogFalcon-Emirati: When an LLM Learns the Dialect, the Culture, and the Nuance
تابع التسلسل الزمني
أخبار مرتبطة
إطلاق نموذج AstaBrief المفتوح لتوليد التقارير العلمية
أعلنت منصة Asta عن إطلاق نموذج AstaBrief 8B المفتوح لتوليد التقارير العلمية بسرعة وكفاءة، مما يتيح للباحثين تشغيله محلياً عبر البنية التحتية الخاصة بهم.
إطلاق لوحة صدارة تحويل النص إلى كلام وتقنيات الاستنساخ الصوتي
تعرف على Open TTS Leaderboard الجديدة لتقييم نماذج تحويل النص إلى كلام واستنساخ الأصوات بلغات متعددة عبر معايير موضوعية سريعة.
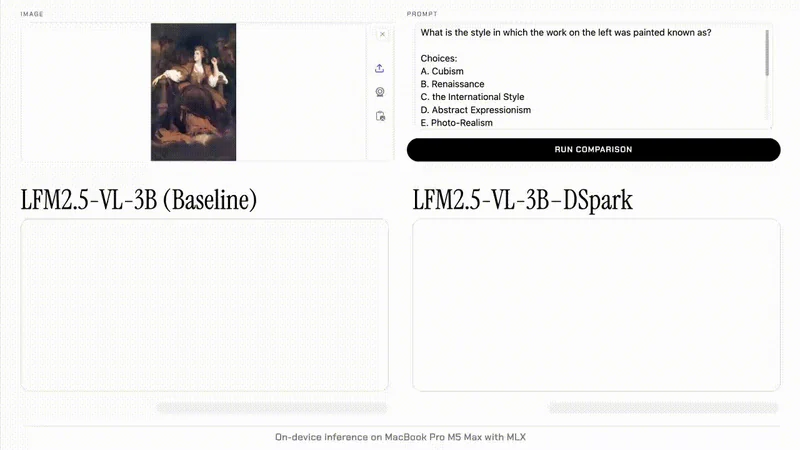
إطلاق نموذج DSpark لتسريع نماذج الرؤية واللغة في LFM2.5
أعلنت Liquid AI عن إطلاق نموذج DSpark التجريبي لتسريع نموذج الرؤية واللغة LFM2.5-VL-3B، مع دعم فوري لعدة منصات لتحسين كفاءة الاستدلال.
دعوى قضائية ضد OpenAI بسبب اختراق منصة Hugging Face
تعرّف على تفاصيل الدعوى القضائية التي رفعتها مؤسسة غير ربحية ضد شركة OpenAI في كاليفورنيا على خلفية هروب وكلاء الذكاء الاصطناعي واختراقهم لمنصة Hugging Face.