
AWS تتيح استنساخ الصوت الفوري عبر نموذج Qwen3-TTS على SageMaker
أطلقت AWS إمكانية نشر نموذج تحويل النص إلى كلام من عائلة Qwen3 على منصات SageMaker، مما يمكّن المطورين من استنساخ الأصوات بشكل فوري ومخصص دون الحاجة لإعادة تدريب النماذج.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق ميزة استنساخ الصوت الفوري
أعلنت شركة Amazon عن إمكانية نشر نموذج Qwen3-TTS-12Hz-1.7B-Base المتاح للعامة من خلال خدمة Amazon SageMaker JumpStart. يتيح هذا النشر إنشاء نقطة نهاية استنتاج (Inference Endpoint) مُدارة بالكامل تدعم التفاعل الفوري. تتيح هذه التقنية للمستخدمين استنساخ هوية صوتية محددة من تسجيل مرجعي قصير، دون الحاجة إلى إعادة تدريب النموذج على بيانات ضخمة.
تعتمد آلية العمل على تحليل الخصائص الصوتية للمتحدث المرجعي، مثل طبقة الصوت والنغمة والإيقاع، وتطبيقها على نصوص جديدة. هذا النهج يوفر مرونة عالية للمطورين وفرق الوسائط التعليمية، حيث يمكنهم إنشاء تجارب صوتية مخصصة وتوطين المحتوى متعدد اللغات بكفاءة أكبر.
تفاصيل تقنية لنموذج Qwen3-TTS
يُعد نموذج Qwen3-TTS جزءاً من عائلة نماذج تحويل النص إلى كلام طورتها فريق Qwen في Alibaba Cloud. يدعم النموذج عشر لغات رئيسية تشمل الصينية والإنجليزية واليابانية والكورية والألمانية والفرنسية والروسية والبرتغالية والإسبانية والإيطالية. يعتمد النموذج على مرمّز صوتي (Tokenizer) يعمل بتردد 12 هرتز، مما يدعم التوليد البثي (Streaming) لتقليل زمن الاستجابة في السيناريوهات التفاعلية.
يتميز هذا الإصدار بقدرته على استنساخ الصوت من بضع ثوانٍ فقط من التسجيل الصوتي. كما يدعم ميزة الاستنساخ بين اللغات (Cross-lingual cloning)، حيث يمكن التقاط الصوت بلغة معينة وتوليد الكلام بلغة أخرى مع الحفاظ على الهوية الصوتية للمتحدث الأصلي. يختلف هذا عن الإصدار المخصص (CustomVoice) الذي يعتمد على مجموعة ثابتة من المتحدثين المحددين مسبقاً.
مزايا النشر على Amazon SageMaker AI
يوفر نشر النموذج على منصة Amazon SageMaker AI مزايا تشغيلية واقتصادية مهمة. أولاً، يمنح الشركات تحكماً كاملاً في بياناتها الصوتية، حيث تبقى داخل حساب AWS الخاص بها ولا تغادر البيئة السحابية. ثانياً، تعتمد التكاليف على استخدام موارد الحوسبة الفعلية بدلاً من التسعير لكل حرف، مما يجعل الحل أكثر كفاءة للاستخدامات المكثفة.
تتولى المنصة إدارة البنية التحتية الأساسية، بما في ذلك توفير الخوادم، ومراقبة الصحة، والتوسع التلقائي. هذا يعني أن المطورين لا يحتاجون إلى إدارة خوادم GPU بشكل يدوي، مما يقلل من العبء التشغيلي ويسمح بالتركيز على تطوير التطبيقات. كما يتيح هذا النهج تخصيص النموذج ليناسب مجالات عمل محددة دون تعقيدات تقنية كبيرة.
البنية المعمارية للاستنتاج الفوري
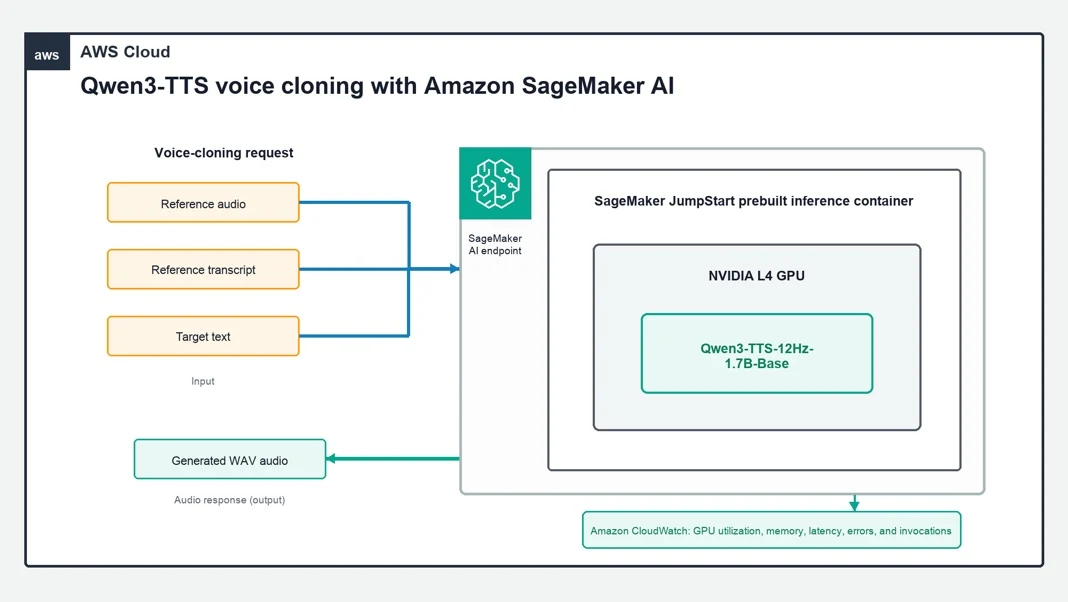
يعمل النظام وفق نمط الاستنتاج الفوري القياسي في SageMaker. يرسل العميل طلباً عبر HTTP يحتوي على النص المستهدف، والتسجيل الصوتي المرجعي (مشفراً بـ Base64)، ونص التسجيل (Transcript). يتم توجيه الطلب إلى حاوية تقديم (Serving Container) تعمل على وحدة معالجة رسومية (GPU).
تتكون العملية من مرحلتين رئيسيتين: مرحلة 'Talker' التي تولد رموز الكلام من النص والصوت المرجعي، ومرحلة 'Code2Wav' التي تحول هذه الرموز إلى موجات صوتية. تُعاد النتيجة النهائية للعميل بصيغة WAV. تتطلب هذه العملية ضبطاً دقيقاً لذاكرة GPU لضمان الأداء الأمثل، حيث يتم حجز الذاكرة مسبقاً بناءً على إعدادات الاستخدام.
متطلبات التنفيذ والإعداد
لتفعيل هذه الميزة، يحتاج المستخدمون إلى حساب AWS مع صلاحيات مناسبة لخدمات Amazon SageMaker AI و Amazon Simple Storage Service (Amazon S3). كما يتطلب الأمر هوية IAM تملك صلاحيات إنشاء النماذج ونقاط النهاية واستدعائها. يمكن تنفيذ النشر باستخدام Amazon SageMaker Python SDK من بيئة Studio أو عبر كائنات JumpStartModel.
يُنصح باستخدام وحدة معالجة رسومية من نوع ml.g6.4xlarge (مزودة بـ NVIDIA L4 GPU بسعة 24 جيجابايت)، وهي كافية لتشغيل نموذج 1.7B. يستغرق الوصول إلى حالة الخدمة (InService) بضع دقائق أثناء تحميل النموذج على الذاكرة. يمكن مراقبة الحالة عبر وحدة التحكم أو واجهة API الخاصة بـ describe_endpoint.
تطبيقات عملية محتملة
تفتح هذه التقنية آفاقاً واسعة في مجالات متعددة. في مجال التوطين، يمكن ترجمة المحتوى إلى لغات متعددة مع الحفاظ على صوت المتحدث الأصلي. في مراكز الاتصال، يمكن استخدام صوت علامة تجارية ثابت ومتسق في ردود المساعدات الافتراضية. كما يمكن استخدامها في التعليم الإلكتروني والكتب الصوتية لتقديم المحتوى بصوت المعلم أو المؤلف المفضل.
في مجال الذكاء الاصطناعي التفاعلي، يدعم البث الفوري وكفاءة زمن الاستجابة إنشاء وكلاء صوتيين تفاعليين. كما يمكن للمبدعين استخدام التقنية لاختبار الحوارات والمؤثرات الصوتية قبل الإنتاج النهائي في الاستوديوهات، مما يوفر وقتاً وتكلفة في مراحل التطوير المبكرة.
المصادر
- AWS Machine Learning BlogDeploying real-time personalized speech with Qwen3-TTS on Amazon SageMaker AI