
ServiceNow تكشف عن AutoSynthData لتوليد بيانات تدريب الوكلاء
أطلقت خدمة ServiceNow إطار عمل جديد يحوّل الفجوات المعرفية في نماذج الذكاء الاصطناعي إلى بيانات تدريبية عالية الجودة، بهدف تحسين أداء الوكلاء في بيئات المؤسسات.
 رضوان عبدالهاديمحرر وكاتب تقني
تحدي تخصيص الوكلاء لبيئات المؤسسات
تواجه المؤسسات صعوبة في تكييف نماذج الذكاء الاصطناعي مع بيئاتها الداخلية، حيث تتأثر المهام بأنظمة محددة وقواعد صارمة وحالة بيانات فريدة. قد تكون النماذج العامة قادرة على أداء مهام واسعة، لكنها تفشل في التعامل مع سيناريوهات محددة، مثل سوء استخدام أدوات معينة أو تجاهل قيود سياسية داخلية. هذه الفجوات هي ما تحتاج الشركات إلى سدّه لتحسين كفاءة وكلاء الذكاء الاصطناعي في العمليات التشغيلية اليومية. ويمكن الرجوع إلى Hugging Face Blog للاطلاع على التفاصيل الأصلية للمصدر.
يكمن التحدي الحقيقي في تحويل هذه نقاط الضعف إلى بيانات تدريبية فعالة. فالاعتماد على فشل فردي لا يكفي لتدريب نموذج، بل يتطلب إنشاء العديد من المهام الجديدة التي تختبر نفس القدرة في سياقات مختلفة. يجب أن تكون هذه المهام قابلة للتنفيذ في البيئة المستهدفة، وأن تشبه الطلبات الواقعية التي قد يطرحها المستخدمون، مع وجود آلية موثوقة للتحقق من نجاح الوكيل في إتمامها. ويمكن الرجوع إلى Back to Articles للاطلاع على التفاصيل الأصلية للمصدر.
آلية عمل إطار AutoSynthData
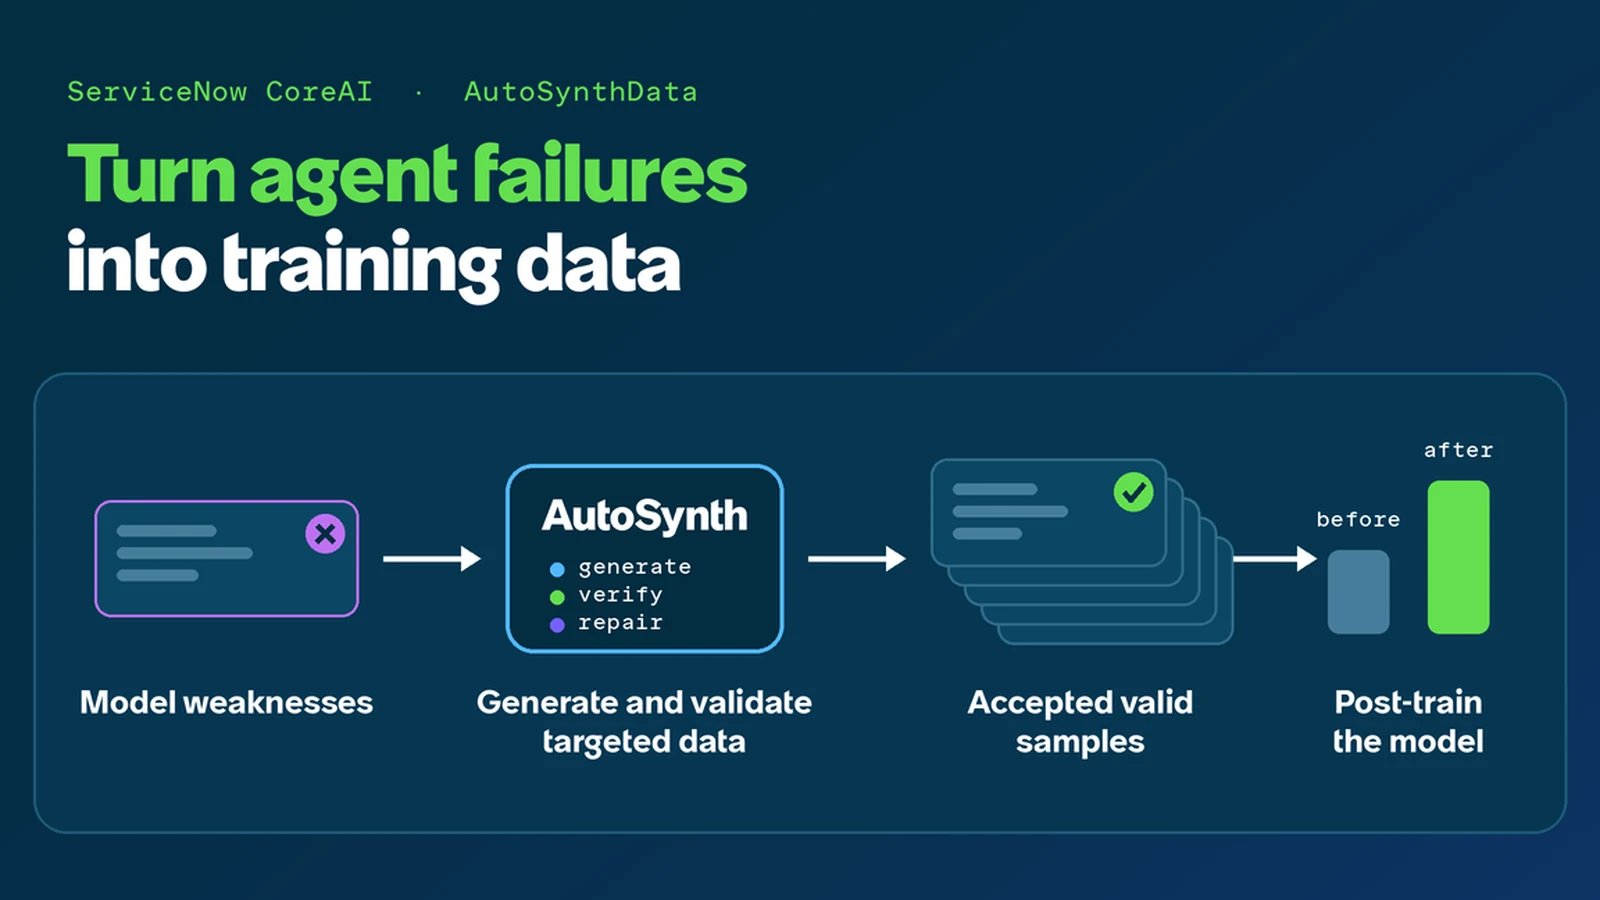
طوّرت خدمة ServiceNow، وتحديداً فريق CoreAI، إطار عمل AutoSynthData لتحويل الفجوات القدرية إلى بيانات تدريبية. يعتمد النظام على تقييم أداء النموذج المستهدف ومقارنته بأداء نموذج أقوى يعمل كمعلم. من خلال تحليل أخطاء النموذج المستهدف ونجاحات المعلم، يحدد النظام المهارات التي يجب تعلمها، ثم يولّد مهاماً جديدة تختبر هذه القدرات وتحققها في البيئة الفعلية.
تتضمن العملية تقييم النموذجين على مهام تشخيصية لتحديد أنماط الفشل والنجاح. يتم بعد ذلك استخلاص هذه النتائج في بطاقات مواصفات قدرات معقمة، لا تحتوي على تفاصيل المهام الأصلية أو المسارات، بل تركز على الخصائص المطلوبة. يستخدم المولّد هذه البطاقات لإنشاء مهام جديدة ذات صياغات وحالات ومسارات حل مختلفة، مما يضمن تنوع البيانات وتجنب التكرار.
معايير جودة المهام المولدة
لتكون المهمة مفيدة للتدريب، يجب أن تحقق ثلاث خصائص أساسية: الجدوى، والواقعية، والصعوبة. الجدوى تعني وجود مسار واحد على الأقل في البيئة الحالية يحقق طلب المستخدم مع احترام المواصفات النظامية، مما يستبعد المهام التي تعتمد على أدوات غير متوفرة أو انتقالات حالة مستحيلة. الواقعية تتطلب أن تشبه صياغة المستخدم طلباً طبيعياً في البيئة المستهدفة، لأن مساحة السلوكيات القابلة للتنفيذ أكبر بكثير من مساحة سير العمل الواقعي.
أما الصعوبة، فتتطلب أن تكشف المهمة عن نقطة ضعف في النموذج الحالي. فالمهام التي يحلها النموذج بثقة لا تقدم إشارات تدريبية جديدة. المنطقة المفيدة هي المهام القابلة للتنفيذ والواقعية، لكنها لم تُحل بشكل متسق بعد. يلعب الموثّق (Verifier) دوراً حاسماً هنا، حيث يجب أن يتسم بالاتساق مع المواصفات، والصحة في رفض المسارات الخاطئة، والاستكمال في قبول الحلول الصالحة دون تشفير مسار مرجعي واحد فقط.
منهجية توليد البيانات في مرحلتين
يعتمد AutoSynthData على منهجية من مرحلتين لبناء مجموعة البيانات. المرحلة الأولى هي مرحلة الهدف (Target)، حيث يتم إنشاء مجموعة أساسية من العينات التدريبية بناءً على مواصفات القدرات. تعمل العمّال (Workers) بشكل متوازٍ لتوليد مهام مستقلة، وتخضع كل مرشحة لعملية تحقق وتنفيذ وتقييم للمحلل قبل القبول. النتيجة هي دفعة من الأمثلة المدققة التي تركز على ما يحتاج النموذج إلى تعلمه.
المرحلة الثانية هي مرحلة التضاعف (Multiply)، حيث يتم توسيع المجموعة الأساسية من خلال إنشاء نسخ متغيرة جديدة من العينات المقبولة. لكل نسخة طلب مستخدم وحالة بيئة وتكوين كيانات ومسار مرجعي وموثّق خاص بها، وتخضع لنفس اختبارات التحقق. يمنع النظام استخدام العينة المضاعفة كمرجع لتوليد نسخة أخرى، مما يرسخ التوسع على مجموعة الهدف المدققة ويحد من الانحراف عبر الأجيال المتعاقبة من البيانات.
التطبيق في بيئة EnterpriseOps Gym
تمت توثيق خط أنابيب AutoSynthData باستخدام بيئة EnterpriseOps Gym، وهي بيئة تجريبية مصممة لمحاكاة عمليات المؤسسات. في هذه التجربة، تم تشغيل كل من النموذج المستهدف والمعلم الأقوى على مهام التقييم. تم فحص هذه التشغيلات لتحديد أماكن فشل النموذج المستهدف وكيفية نجاح المعلم، بالإضافة إلى الخصائص التي يجب أن يحققها الحالة النهائية الصحيحة، والأبعاد التي يمكن أن تتغير مع الحفاظ على اختبار القدرة المستهدفة.
أدت هذه العملية إلى إنشاء بطاقات مواصفات قدرات معقمة، حيث لم يتلقِ المولّد الموجهات الأصلية أو الكيانات أو المسارات من مهام التقييم، بل استلم البطاقات فقط لإنشاء مهام جديدة. هذا الفصل بين التقييم والتوليد يضمن أن البيانات التدريبية الجديدة تكون متنوعة وغير مرتبطة مباشرةً ببيانات الاختبار، مما يعزز قدرة النموذج على التعميم في بيئات مشابهة.
إتاحة البيانات والمجتمع التقني
لتسهيل تطبيق هذه المنهجية، تم إصدار مجموعة بيانات مفتوحة تتيح للمطورين والباحثين الوصول إلى البيانات المولدة. توفر هذه المجموعة أمثلة على كيفية تحويل الفجوات القدرية إلى مهام تدريبية قابلة للتنفيذ، مما يساهم في تسريع تطوير وكلاء الذكاء الاصطناعي المتخصصين. يمكن للمجتمع التقني استخدام هذه البيانات لفهم أفضل لآليات التوليد والتحقق في بيئات الوكلاء المعقدة.
تُعد هذه المبادرة خطوة مهمة نحو حل مشكلة ندرة البيانات عالية الجودة للتدريب المخصص (Fine-tuning) في بيئات المؤسسات. من خلال أتمتة عملية اكتشاف الفجوات وتوليد البيانات، يوفر AutoSynthData إطاراً قابلاً للتوسع يمكن تكييفه مع مختلف الأنظمة والسياسات المؤسسية، مما يعزز جاهزية الشركات لتبني تقنيات الوكلاء الذكية بشكل أكثر فعالية وأماناً.
المصادر
- Hugging Face BlogAutoSynthData: Generating Training Data for Enterprise Agents