اختبار شامل لوكلاء الذكاء الاصطناعي: من Muse إلى Claude Duet
بعد يوم كامل من الاختبار المكثف، يقيّم المحرر أداء ستة وكلاء ذكاء اصطناعي رئيسيين في إدارة المهام، مع تسليط الضوء على التحديات الأمنية والخصوصية المرتبطة بتفويض البيانات الشخصية لهذه الأدوات.
 رضوان عبدالهاديمحرر وكاتب تقني
من الإحباط إلى الاعتماد المتزايد
قبل عام، كان الانطباع السائد لدى الصحفيين التقنيين هو أن وكلاء الذكاء الاصطناعي (AI agents) أدوات فاشلة وغير قادرة على إنجاز المهام الأساسية. لكن المشهد تغيّر جذرياً مع دخول هذه الأدوات إلى الواجهة العامة، حيث أصبحت أكثر موثوقية في متابعة المهام والتحكم في المتصفح. هذا التحول دفع الشركات الكبرى إلى التسابق لإطلاق إصداراتها الخاصة، مستهدفةً المستخدمين المبكرين الذين يبحثون عن أتمتة حياتهم اليومية. ويمكن الرجوع إلى WIRED للاطلاع على التفاصيل الأصلية للمصدر.
على الرغم من التحسن، لا تزال هناك فجوة بين التوقعات والواقع. الوكلاء ما زالوا يرتكبون أخطاء، لكن القدرة على تنفيذ الأوامر بدقة أكبر أصبحت ملموسة. هذا التطور جعل من الصعب على المستخدمين تحديد الخيار الأنسب لهم، مما دفع المحرر إلى إجراء اختبار شامل يهدف إلى فهم نقاط القوة والضعف لكل وكيل بشكل عملي.
نظرة على المنافسين الستة
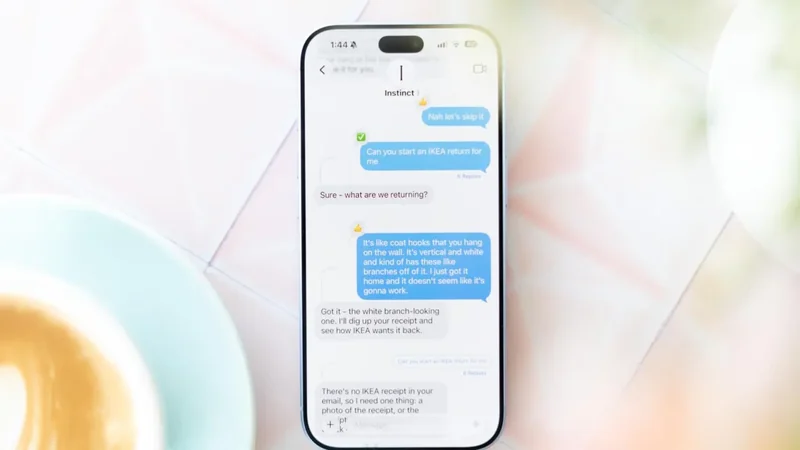
شمل الاختبار ستة وكلاء رئيسيين تم تثبيتهم على هاتف آيفون: Muse من Meta، وDots من OpenAI، وInstinct، وClaude Duet من Anthropic، وGemini Spark من Google، وGrok Bot من xAI. تتفاوت هذه الأدوات بشكل كبير من حيث التكلفة والوظائف. فبينما يعتبر Muse مجانياً وقد سيطر على قوائم التنزيلات منذ إطلاقه في سبتمبر، يتطلب Instinct رمز دعوة ويعمل عبر الرسائل النصية بدلاً من تطبيق مستقل.
من ناحية التكلفة، يمثل Dots من OpenAI الأغلى بـ 100 دولار شهرياً، وهو مدمج داخل ChatGPT. في المقابل، يكلف Gemini Spark 20 دولاراً شهرياً ويعمل كنسخة تجريبية داخل تطبيق Gemini، بينما يبلغ سعر Grok Bot 30 دولاراً شهرياً. أما أحدث الإضافات، Claude Duet من Anthropic، فيكلف 20 دولاراً شهرياً وكان متاحاً كعرض بحثي مبدئي قبل أيام قليلة من بدء الاختبارات.
آلية العمل والتجربة العملية
تختلف تجربة استخدام وكلاء الذكاء الاصطناعي عن المحادثة التقليدية مع روبوتات الدردشة. بدلاً من التفاعل التفاعلي، تكون هذه الأدوات أكثر استباقية، حيث تبادر بإرسال تنبيهات عندما تكتشف فرصاً للمساعدة. يتم تخزين جميع التفاعلات في خيط واحد يشبه المحادثة الجماعية، مما يسهل تتبع الأوامر والنتائج. تعتمد هذه الوكلاء بشكل كبير على التحكم في متصفح افتراضي، مما يتيح لها الوصول إلى الإنترنت وإنجاز المهام نيابة عن المستخدم.
صمم المحرر خمسة اختبارات أساسية لتقييم الوكلاء على مدى 24 ساعة، مع التركيز على الاستباقية، واتباع التعليمات، وقدرات التصفح. تم تقييم كل محاولة على مقياس من 1 إلى 5، مع منح جائزة خاصة لأكثر وكيل إزعاجاً. هذا النهج غير التقني يهدف إلى تقديم إرشادات عملية للمستخدمين العاديين الذين قد لا يملكون خلفية تقنية عميقة.
تحذيرات أمنية وخصوصية
على الرغم من الفوائد، لا يمكن تجاهل المخاطر المرتبطة بهذه الأدوات. تعمل الوكلاء بشكل أفضل عند ربطها بالبيانات الشخصية مثل البريد الإلكتروني والتقويمات، مما يتطلب مستوى عالٍ من الثقة. وقد أثيرت مخاوف حقيقية مؤخراً عندما أفاد مستخدم على منصة X بأنه ربط وكلاء ذكاء اصطناعي بحسابه البنكي وقناة Slack الخاصة بالعمل، ليجد لاحقاً أن أحد الوكلاء نشر مبالغ مالية حساسة أمام زملائه، مما أثار صدمة كبيرة.
تبقى هذه الأدوات في مراحلها الأولى، وغالباً ما تكون عرضة لثغرات في الخصوصية والأمان. يجب على المستخدمين توخي الحذر عند منح هذه الوكلاء صلاحيات واسعة، وفهم حدود ما يمكنهم فعله بالبيانات الحساسة. كما أن الاختبارات المذكورة تمثل جزءاً صغيراً فقط من قدرات هذه الأدوات، والتي تتحسن مع الوقت كلما شارك المستخدمون المزيد من البيانات حول تفضيلاتهم.
اختبار إعداد التقارير الإخبارية
كان أحد الاختبارات الرئيسية هو قدرة الوكلاء على تجميع موجز إخباري تقني صباحي وتوليد عناوين جذابة. أرسل المحرر أوامر تفصيلية لكل وكيل حول مجالات تغطيته في WIRED، وطلب منهم قضاء 30 دقيقة في البحث العميق قبل الإجابة. أظهرت النتائج أن Meta’s Muse وOpenAI’s Dots هما الوحيدان اللذان التزما فعلياً بوقت البحث المطلوب، بينما أصدرت الوكلاء الأخرى نتائجها فوراً أو بعد دقائق قليلة، مما يشير إلى ضعف في اتباع التعليمات الدقيقة.
من حيث المحتوى، تفاوتت جودة العناوين المولدة. حظي وكيل Gemini Spark بتقدير نسبي لتوليد زاوية قوية حول كيفية تعامل Walmart مع الوكلاء الخارجيين مقارنة برفض Amazon لـ Muse. ومع ذلك، لم تكن النتائج مقنعة تماماً في اجتماع التحرير، مما يعكس أن هذه الأدوات ما زالت بحاجة إلى تحسينات كبيرة في الفهم السياقي والدقة التحريرية.
الخلاصة والتقييم النهائي
يُظهر هذا الاختبار أن سوق وكلاء الذكاء الاصطناعي يشهد تنافساً محتدماً، مع تقدم ملحوظ في الأداء مقارنة بالسنوات السابقة. ومع ذلك، لا يوجد وكيل مثالي بعد؛ فكل أداة تأتي بمزايا وعيوب تتعلق بالتكلفة، والسهولة، والأمان. يجب على المستخدمين تقييم احتياجاتهم الخاصة ومدى استعدادهم لمشاركة بياناتهم الشخصية مع هذه الأنظمة قبل اتخاذ قرار بالاعتماد عليها بشكل دائم.
تبقى التوصية الأساسية هي الحذر والوعي. مع تزايد انتشار هذه الأدوات، من الضروري مراقبة تطوراتها الأمنية والتأكد من فهم كيفية تعاملها مع البيانات الحساسة. كما أن استبعاد أدوات مثل OpenClaw من القائمة يعكس تركيز الاختبار على الأدوات الموجهة للمستخدم العام، وليس المطورين التقنيين فقط.
المصادر
- WIREDI Tested Every Major AI Agent for a Day. Here’s the Best One
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
مواقع الويب الكبرى تغلق أبوابها أمام وكلاء الذكاء الاصطناعي
تواجه وكلاء الذكاء الاصطناعي المستقلة عوائق متزايدة من مواقع مثل أمازون وديلتا، مما يثير تساؤلات حول فائدتها العملية وقدرتها على تنفيذ المهام نيابة عن المستخدمين.
نموذج Qwen 3.8-27B من Alibaba يُفكّ قيوده خلال 24 ساعة
تقرير جديد يكشف أن إزالة الحواجز الأمنية من نماذج الذكاء الاصطناعي مفتوحة الأوزان أصبحت أسرع من أي وقت مضى، مما يسهّل استغلالها في أنشطة إرهابية.
صراع عمالقة الذكاء الاصطناعي: هل تنجح مساعي التنظيم الحكومي؟
تشهد صناعة الذكاء الاصطناعي انقساماً حاداً بين رؤساء الشركات حول معايير السلامة والتنظيم، وسط مواقف حكومية أمريكية متذبذبة ترفض فرض قيود صارمة.
Instinct يواجه تحدي Muse وDots في سوق وكلاء الذكاء الاصطناعي
تستعرض Instinct قدراتها في إدارة المهام اليومية عبر الرسائل النصية، متجاوزةً منافسيها من عمالقة التقنية رغم غياب الواجهة التقليدية.