إطلاق مجموعة بيانات Nemotron-pretraining-Indic-v1 لتدريب الذكاء الاصطناعي
أعلنت شركة إنفيديا بالتعاون مع مختبر AI4Bharat التابع لمعهد الهند للتكنولوجيا في مدراس عن إطلاق مجموعة بيانات ضخمة للتدريب المسبق باللغات الهندية.
 رضوان عبدالهاديمحرر وكاتب تقني
تعاون تقني لتوسيع نطاق اللغات الهندية
في خطوة تهدف إلى سد الفجوة الكبيرة في توفر البيانات التقنية باللغات المحلية، كشفت شركة nvidia بالتعاون مع معهد الهند للتكنولوجيا في مدراس عن إطلاق مجموعة بيانات متقدمة للتدريب المسبق تُعرف باسم Nemotron-pretraining-Indic-v1. تأتي هذه المبادرة في وقت يشير فيه الخبراء إلى أن تقنيات اللغات الهندية تتخلف عن نظيرتها الإنجليزية بسبب نقص البيانات المتاحة، وهو التحدي الذي يسعى هذا المشروع الجديد إلى معالجته جذرياً من خلال توفير حجم هائل من البيانات المنظمة والموثوقة للباحثين والمطورين في جميع أنحاء العالم.
تم تطوير هذه المجموعة بالتعاون الوثيق مع مختبر AI4Bharat، وهو مختبر أبحاث اللغات الهندية التابع لمعهد الهند للتكنولوجيا في مدراس والذي يقوده ميليش خابرا. وقد ركز الفريق على بناء موارد ومجموعات بيانات مفتوحة المصدر لخدمة اللغات الهندية، مستندين في ذلك إلى خبرات سابقة مثل مشروع Sangraha الذي وضع الأساس لأبحاث نماذج اللغات الهندية المفتوحة. يمثل هذا الإصدار المشترك توسعاً جوهرياً في بيانات التدريب الاصطناعية المتاحة للجمهور.
حجم ضخم وتغطية شاملة لـ 22 لغة هندية
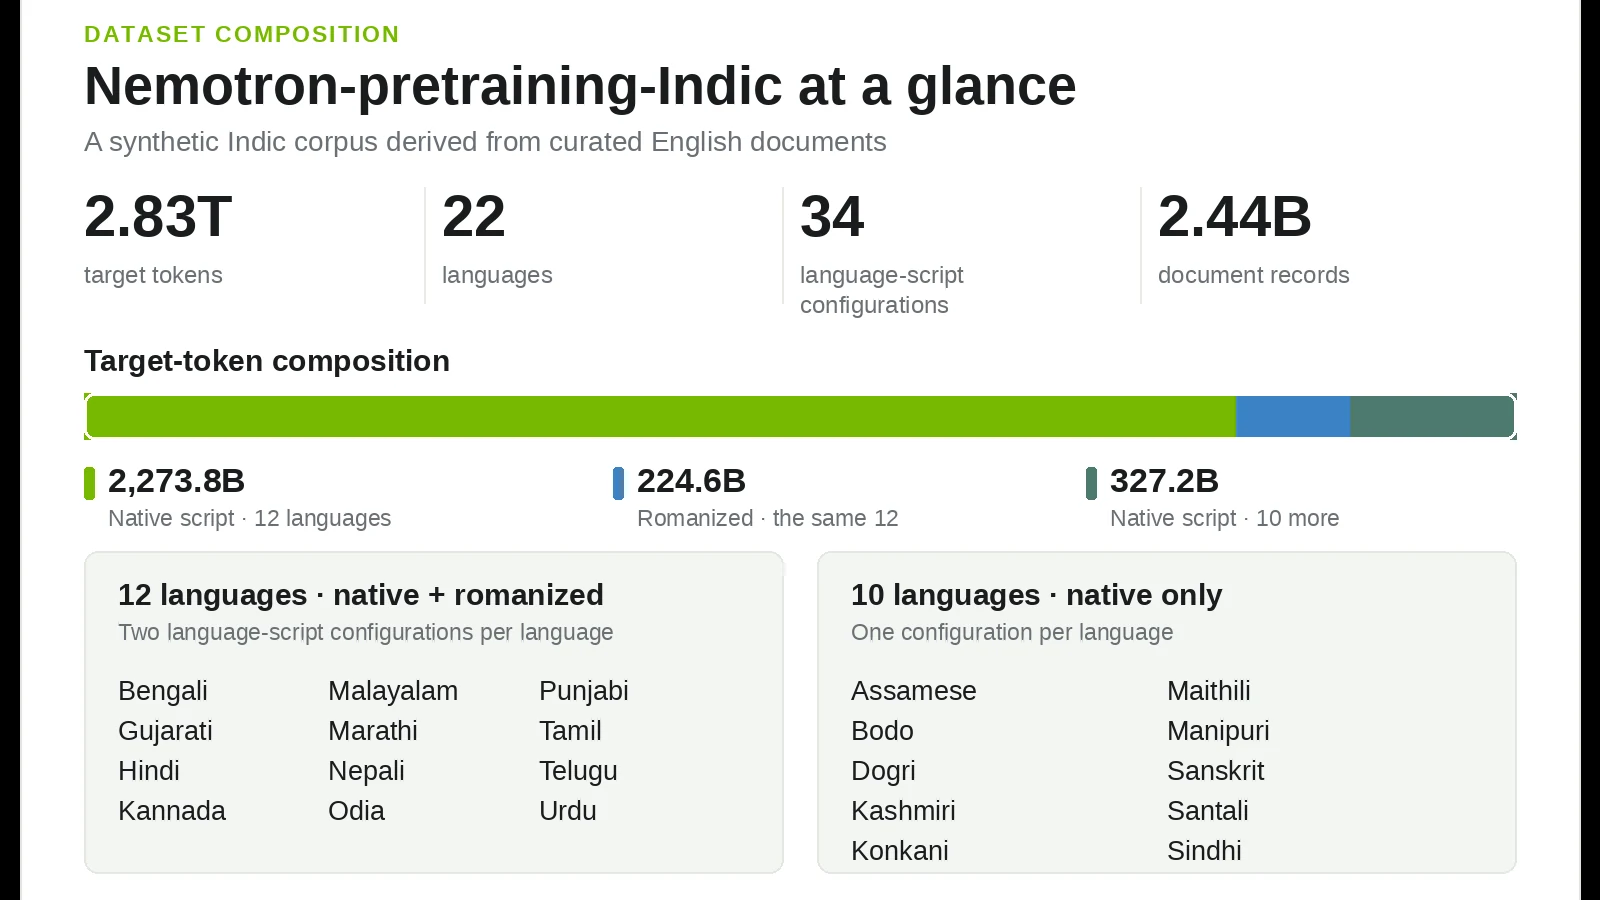
تغطي مجموعة البيانات الجديدة نحو 2.8 تريليون رمز لغوي موزع على 22 لغة هندية وردت في الدستور الهندي، وهي اللغات الأولى لنحو 97% من المواطنين الهندي, أي ما يقرب من 1.2 مليار مواطن استناداً إلى تعداد عام 2011. وقد نُشرت التفاصيل الكاملة لهذا الإنجاز التقني عبر Hugging Face Blog لتكون متاحة أمام مجتمع المطورين والباحثين الراغبين في بناء نماذج ذكاء اصطناعي تفهم السياقات الثقافية والمحلية بدقة عالية.
تشتمل البنية الكلية للمجموعة على نحو 2,601.0 مليار رمز مكتوب بالخطوط الأصلية و224.6 مليار رمز مكتوب بالصيغة الرومانية اللاتينية، وذلك حسب إحصاءات مُرمز Gemma-4. وتنقسم تكوينات اللغات داخل المجموعة إلى مجموعتين رئيسيت، حيث تضم الأولى بيانات بالخط الأصلي والصيغة الرومانية لـ 12 لغة تشمل البنغالية، الغوجاراتية، الهندية، الكنادية، الماليالامية، المهاراتية، النوبية أو النيبالية، الأوديا، البنجابية، التاميلية، التيلوغوية، والأوردو. بينما تقتصر المجموعة الثانية على بيانات الخط الأصلي للغات أخرى مثل الأسامية، البودو، الدوغري، الكشميرية، الكونكانية، المايثيلي، المانيبورية، السنسكريتية، السانتالية، والسندية.
خطوط إنتاج مفتوحة ومسّرعة بالحواسيب الرسومية
إلى جانب مجموعة البيانات النصية، تشمل المبادرة إطلاق خط إنتاج مفتوح ومسّرع باستخدام وحدات معالجة الرسوميات لإنشاء وترجمة وتقييم وإصلاح البيانات. يتيح هذا النظام للمطورين إمكانية تكييف الوصفات والأدوات مع مصادرهم الخاصة لتوليد المزيد من البيانات حسب الحاجة. ويغطي سير العمل دورة حياة البيانات بالكامل ابتداءً من توجيهات النماذج اللغوية الكبيرة وحتى فحوصات الجودة الصارمة لضمان موثوقية المحنتوى الناتج ومطابقته للمواصفات التقنية.
يعتمد النظام على مصادر مستمدة من مجموعات فرعية متعددة تشمل نصوص الويب، ومحتوى الأسئلة والأجوبة، والرياضيات، والتعليمات البرمجية، وغيرها من المجالات المتخصصة. ومن خلال استخدام إطار العمل المفتوح، يمكن تتبع كل سجل بياني وصولاً إلى مستنده الأصلي، مما يمنح المطورين شفافية كاملة وقدرة عالية على التدقيق والتحسين المستمر لجودة النماذج اللغوية المدربة.
معايير دقيقة لضمان جودة الترجمة والمحتوى
تعتمد عملية بناء النصوص على منهجية متعددة المراحل تبدأ بترجمة المستندات الإنجليزية بالكامل لتمكين النماذج من استغلال السياق عبر الفقرات والجداول والمعادلات الرياضية. وقد تم اختيار نموذج معين بعناية بعد مقارنة النماذج المختلفة من حيث جودة الترجمة والحفاظ على المحتوى التقني مثل الأكواد البرمجية والروابط والتنسيقات. كما تُستخدم معايير تقييم مستوحاة من مقاييس الجودة متعددة الأبعاد لتصنيف أخطاء الترجمة من حيث النوع والشدة.
تتطلب عملية القبول حصول المخرجات على الحد الأدنى من الدرجات المحددة، بينما تخضع المخرجات الأقل درجات لعمليات إصلاح موجهة تستند إلى ملاحظات التقييم قبل إعادة فحصها. هذه المنهجية المتقدمة ساهمت في استعادة مئات المليارات من الرموز اللغوية المفيدة، مما يعزز من كفاءة البيانات الجاهزة للتدريب المسبق ويقلل من الأخطاء والشوائب الناتجة عن عمليات الترجمة الآلية التقليدية.
آفاق مستقبلية لتطوير النماذج اللغوية الكبيرة
أسفرت هذه الجهود عن دمج نحو 10 مليارات رمز هندي إضافي في عمليات التدريب المستمر لنموذج Nemotron 3.5 Super VL، مستمدة من مجموعة فرعية تضم اثنتي عشرة لغة إلى جانب النصوص الهندية الطبيعية. وتخطط الفرق القائمة على المشروع لتوسيع هذه المبادرة والبناء على هذا الأساس المتين في إصدارات نماذج Nemotron المستقبلية، مما يمهد الطريق لظهور جيل جديد من أنظمة الذكاء الاصطناعي القادرة على التعامل بكفاءة تامة مع التعقيدات اللغوية والثقافية لشعوب شبه القارة الهندية.
تؤكد هذه التحركات التزام الشركات الكبرى والمؤسسات الأكاديمية بتوفير بنى تحتية مفتوحة تعزز من الابتكار المجتمعي. من خلال إتاحة البيانات وخطوط الإنتاج البرمجية للعامة، يمكن للمطورين الصغار والكبار على حد سواء المساهمة في بناء نماذج ذكاء اصطناعي أقوى وأكثر دقة تفهم التنوع الثقافي واللغوي الغني والمتفرد في المنطقة الهندية.
المصادر
- Hugging Face BlogScaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
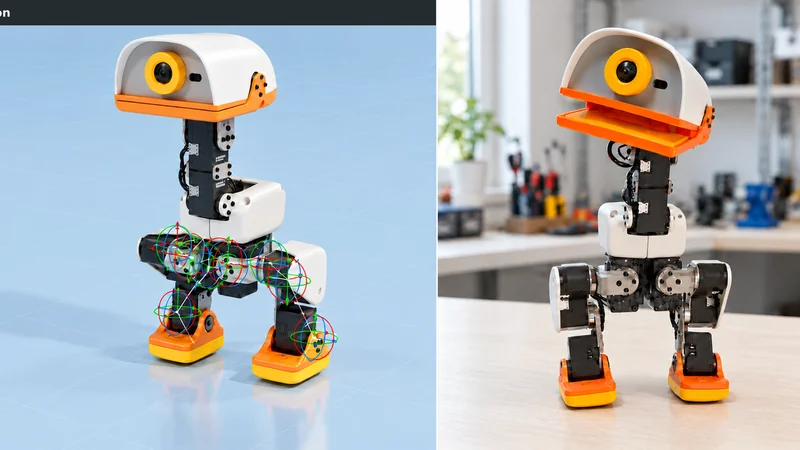
NVIDIA وHugging Face يطلقان روبوت Microduck مع Isaac Lab 3.0
يتيح إطار عمل Isaac Lab 3.0 تدريب روبوت Microduck ثنائي القوائم على المشي في المحاكاة ثم نقله فعلياً، مع تصدير السياسات بصيغة ONNX للمشاركة على Hugging Face Hub.
غياب OpenAI عن تحالف Nvidia لوقف وكلاء الذكاء الاصطناعي الخارجين عن السيطرة
تعمل OpenAI سرًا مع Nvidia رغم غيابها العلني عن منصة Open Agent Safety Platform، في خطوة تهدف إلى معالجة أزمات الوكلاء الخارجين عن السيطرة.
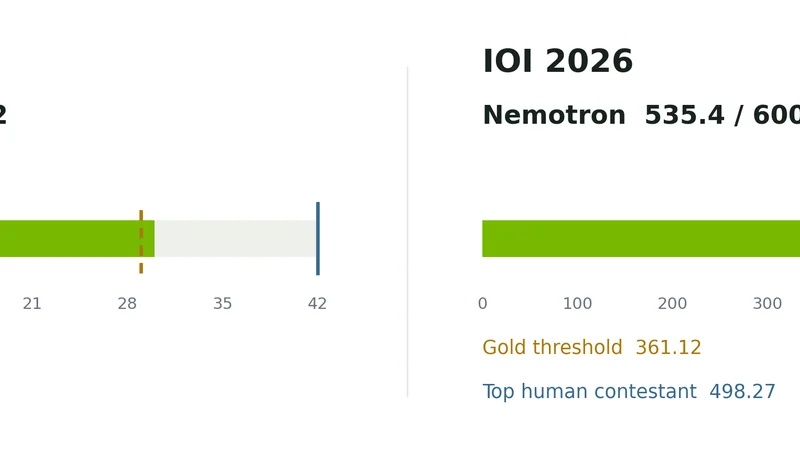
إنفيديا: نموذج Nemotron يتفوق في أولمبيادتي البرمجة والرياضيات
تُظهر نتائج جديدة أن نماذج Nemotron من إنفيديا قادرة على تحقيق مستوى الميدالية الذهبية في أولمبيادتي المعلومات والرياضيات الدوليتين عبر الضبط الدقيق.
مشروع MonsterHouse: مرآب ذكي بصوت سفينة قرصنة
استكشف كيف ابتكر مهندس في نيفيديا مشروع MonsterHouse التفاعلي لعيد الهالوين باستخدام وكيل الصوت Nemotron ونماذج ذكاء اصطناعي متطورة.