OpenAI توسّع نظام Habitat لتخزين بيانات مليار مستخدم ChatGPT
تواجه OpenAI تحدياً هندسياً ضخماً في إدارة بيانات أكثر من مليار مستخدم عبر 40 منطقة جغرافية، مما دفعها لإعادة تصميم بنيتها التحتية للتخزين.
 رضوان عبدالهاديمحرر وكاتب تقني
التحدي الهندسي: استجابة فورية لمليار مستخدم
تتطلب جميع منتجات OpenAI وصولاً سريعاً وموثوقاً للبيانات، وهو ما توفره منصة التخزين الداخلية المعروفة باسم Habitat. يجب أن تستجيب هذه المنصة خلال أجزاء من الثانية لأكثر من مليار مستخدم موزعين على 40 منطقة جغرافية حول العالم. واجهت فرق البنية التحتية تحدياً استثنائياً يتمثل في دعم النمو المتسارع وظهور حالات استخدام جديدة، مع الحفاظ في الوقت نفسه على الموثوقية والأداء وسرعة تطوير المنتجات. لحل هذه المعادلة، اضطرت الشركة إلى إعادة التفكير في تصميم وتشغيل منصة التخزين السحابي الخاصة بها، مع تقييم مستمر للمقايضات التقنية بين الموثوقية والسرعة وإدارة الحجم الضخم.
يأتي هذا التطور كجزء من سلسلة مقالات تقنية من قسم الهندسة في OpenAI. في الجزء الأول من هذه السلسلة، تم التركيز على تطور Habitat من مجرد مكتبة عميل بسيطة إلى خدمة متكاملة، وكيف تم دفع حدود ما كان يُعتبر عملياً لخدمة مبنية على لغة Python. أما في هذا الجزء الثاني، فيتم التعمق في كيفية توسيع نطاق مكوّن التخزين الأساسي، وهو قاعدة بيانات Azure Cosmos DB، من خلال شراكة عمل وثيقة مع فريق Azure للوصول إلى نهج متعدد المستأجرين قابل للتطبيق.
من العزلة إلى تعدد المستأجرين
مع نمو الشركات، تتطور فرق البنية التحتية غالباً من تشغيل أنظمة مخصصة لمستأجر واحد (Single-tenant) إلى أنظمة متعددة المستأجرين (Multi-tenant). في نموذج المستأجر الواحد، يحتفظ كل فريق منتج بنظامه الخاص، مما يقلل من نطاق الأخطاء ويوفر حدود ملكية واضحة وعزلاً تاماً للأحمال. ومع ذلك، يصبح هذا النموذج مكلفاً للغاية عند توسع الفرق وزيادة أسطح المنتجات، حيث يتحمل كل فريق مسؤولية تخطيط السعة، مما يؤدي غالباً إلى تخصيص موارد زائدة عن الحاجة بشكل كبير.
في المقابل، يمنح نموذج تعدد المستأجرين السيطرة لفريق مركزي لقواعد البيانات، يتمتع بخبرة أكبر في تخصيص الموارد. لكن هذا النموذج يخلق تحدياته الخاصة، أبرزها مشكلة الجار الصاخب (Noisy-neighbor)، حيث يستهلك مستأجر واحد حصة غير متناسبة من الموارد على حساب المستأجرين الآخرين. في منصة Habitat، اضطر فريق OpenAI إلى الموازنة بين هذه المقايضات لتصميم نظام تخزين موثوق وفعال. اليوم، تعمل Habitat كطبقة قاعدة بيانات متعددة المستأجرين لمنتجات OpenAI المختلفة، لكن الرحلة لم تكن خطية؛ فقد بدأت بحاوية واحدة متعددة المستأجرين، ثم انتقلت إلى حاويات مخصصة لكل مستأجر، قبل أن تعود في النهاية إلى اعتماد حاويات متعددة المستأجرين كخيار افتراضي.
آلية عمل حاويات Azure Cosmos DB
لفهم رحلة OpenAI التقنية، من الضروري فهم أساسيات عمل حاويات Azure Cosmos DB. تحدد كل حساب في Azure Cosmos DB مجموعة من الحاويات وسياسة التكرار (Replication Policy). يتم تخصيص كل حاوية لمعدل تدفق معين يُقاس بوحدات الطلبات في الثانية (RU/s). تُخزن البيانات داخل كل حاوية باستخدام تقسيم (Sharding) بناءً على مفتاح تقسيم منطقي محدد، مع وجود حدود موثقة لتخزين البيانات ومعدل التدفق لكل مفتاح منطقي.
تقوم Azure Cosmos DB بإدارة تقسيم المفاتيح المنطقية عبر عدد أقل من التقسيمات الفيزيائية الأساسية. تقوم الخدمة بتقسيم هذه المفاتيح إلى تقسيمات فيزيائية متعددة عندما تتجاوز البيانات حداً معيناً من التخزين، أو عندما تحتاج الحاوية إلى المزيد من التقسيمات الفيزيائية للحفاظ على معدل التدفق المخصص. هذا الهيكل يسمح بالمرونة في إدارة الأحمال، لكنه يتطلب فهماً دقيقاً لكيفية توزيع الموارد على المستوى الفيزيائي لضمان الأداء الأمثل.
المرحلة الأولى: الاعتماد على الأدوات الأساسية
في البداية، سمحت OpenAI لأي حمل عميل بالمرور، معتمدين على حد 10,000 RU/s المعلن لكل مفتاح تقسيم منطقي لتوفير ضغط رجعي (Back pressure). كما استخدموا حاوية Azure Cosmos DB واحدة افتراضية في كل حساب. على الرغم من أن هذا الحل كان كافياً في البداية، إلا أنه أثبت وجود عدة مشاكل جوهرية. أولاً، بسبب اختيارات واجهة برمجة التطبيقات (API) المبكرة، تم كشف اختيار مفتاح التقسيم المنطقي مباشرة للعملاء، مما أدى إلى تصادمات متكررة على مفاتيح شائعة الاستخدام مثل معرّف المستخدم (user_id) أو معرّف مساحة العمل (workspace_id) عبر حالات استخدام مختلفة.
ثانياً، واجهت الشركة مشكلة قديمة كانت تعاني منها عند توسيع نطاق قواعد بيانات Postgres قبل الانتقال إلى Habitat، وهي قدرة الطلبات الكثيفة من منظمة ساخنة أو مفتاح واحد على إغراق قاعدة البيانات بأكملها. تم بذل جهد جماعي كبير لتخزين هذه المفاتيح مؤقتاً (Caching) وبناء إيجارات (Leases) عند فشل التخزين المؤقت، لضمان عدم انهيار قاعدة البيانات الأساسية تحت وطأة الطلبات المتكررة.
تحديات التقسيم الفيزيائي والأداء
ثالثاً، على الرغم من أن حدود حجم البيانات ومعدل التدفق الموثقة تنطبق على المفاتيح المنطقية، إلا أن الحدود الفعلية تُفرض على مستوى التقسيم الفيزيائي. عملياً، هذا يعني أن التقسيمات المنطقية لا تستطيع الوصول إلى 10,000 RU/s، بل تتشارك حدود التقسيم الفيزيائي مع كل المفاتيح المنطقية الأخرى الموجودة على نفس التقسيم الفيزيائي. سمح هذا الوضع لـ"الجيران الصاخبين" بالتأثير على العديد من المفاتيح المنطقية غير ذات الصلة، حيث كانت الأحمال العاملة على بيانات ميزات منتج متخصصة تعطل تدفقات تسجيل الدخول وإنشاء الحساب الأساسية.
أخيراً، حد معدل التدفق لتقسيم فيزيائي معين متغير ويعتمد على إجمالي معدل التدفق المخصص للحاوية. يتم توزيع معدل التدفق المخصص للحاوية بشكل متساوٍ تقريباً عبر التقسيمات الفيزيائية. مع نمو حجم البيانات، تنقسم التقسيمات الفيزيائية، مما يزيد من إجمالي عدد التقسيمات بينما يبقى معدل التدفق المخصص ثابتاً. النتيجة هي أن حد معدل التدفق الفعال لكل تقسيم يتقلص كلما زاد حجم البيانات. لحالات الاستخدام الأكثر كثافة في التخزين، مثل الملفات الثنائية (Blobs)، يخلق هذا نمط فشل حيث يؤدي نمو التخزين وحده إلى تقليل سعة معدل التدفق للأحمال النشطة، حتى لو بقيت معدلات الطلب والاستخدام مستقرة.
المرحلة الثانية: العزل والتخصيص
لمعالجة هذه المشاكل، انتقلت OpenAI في المرحلة الثانية إلى تجربة عزل الأحمال ونموذج المستأجر الواحد. ساعدت الحاويات المنفصلة في حل بعض هذه المشاكل جزئياً، حيث سمحت بعزل الأحمال الثقيلة عن الأحمال الحرجة. ومع ذلك، كان هذا الحل مكلفاً من حيث التكلفة والتعقيد التشغيلي، مما دفع الفريق إلى البحث عن حل وسط يجمع بين كفاءة تعدد المستأجرين وموثوقية العزل.
من خلال الشراكة الوثيقة مع فريق Azure، توصلت OpenAI إلى نهج متعدد المستأجرين قابل للتطبيق يعتمد على حاويات مشتركة الإدارة (Co-managed containers). هذا النهج سمح بتحقيق أداء قراءة ممتاز على نطاق عالمي ضخم، مع الحفاظ على الموثوقية المطلوبة لمنتجات الحساسة. وقد أثمر هذا التعاون عن تحسينات جوهرية أدت إلى تسريع عمليات القراءة بنسبة 12 ضعفًا، مما عزز تجربة المستخدم النهائي لـ ChatGPT.
المصادر
- OpenAI NewsRapidly scaling online storage to serve over 1 billion ChatGPT users (Part II)
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
كيف بنت OpenAI نظام الإعلانات المدعوم بالنماذج الكبيرة لـ ChatGPT
استكشف كيف طورت OpenAI نظام إعلانات مخصصاً لـ ChatGPT يعتمد على نموذج لغوي كبير مخصص، مع فصل كامل عن مسار توليد الإجابات لضمان ثقة المستخدم.
ChatGPT Ads توسّع نطاقها إلى 26 دولة جديدة بعد تجاوز 100 ألف إعلاني
أعلنت OpenAI عن توسيع خدمة الإعلانات في ChatGPT لتشمل 26 دولة إضافية، ليصل إجمالي التغطية إلى 89 دولة حول العالم، في خطوة تهدف لدعم الوصول المجاني للذكاء الاصطناعي.
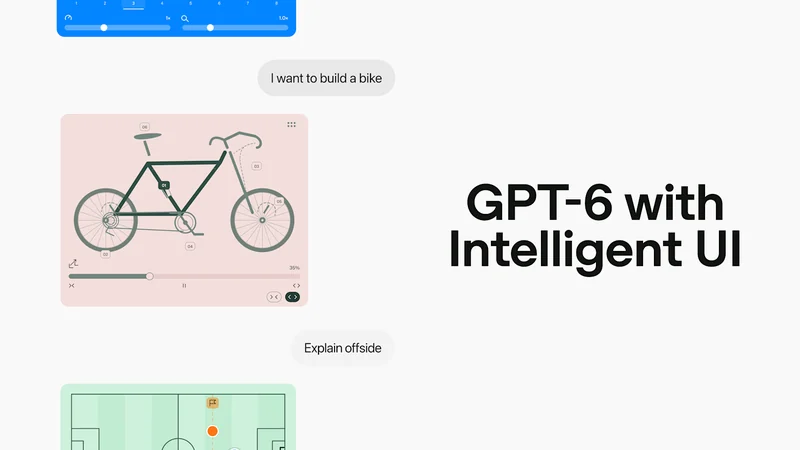
OpenAI تطلق GPT‑6 عالمياً مع واجهة ذكية في ChatGPT
GPT‑6 متاح الآن في ChatGPT عالمياً بواجهة ذكية تدمج النصوص والرسوم والتفاعلية، مما يوفر إجابات أسرع وأكثر فائدة عبر الويب والجوال.
OpenAI تطلق إعلانات مرئية تظهر بجانب نتائج توليد الصور في ChatGPT
أعلنت OpenAI عن إضافة إعلانات مرئية تظهر إلى جانب الصور المولّدة في ChatGPT، مع توسيع أدوات القياس والشراكات مع منصات إعلانية عالمية لتعزيز تجربة المعلنين.