شركة TwelveLabs تكشف عن نموذج Pegasus 1.6 لفهم الفيديو في الذكاء الاصطناعي المادي
تسعى شركة TwelveLabs إلى سد الفجوة بين الفيديو الخام والبيانات القابلة للتدريب عبر إطلاق نموذج جديد يركز على فهم المشاهد المعقدة من منظور الشخص المنفذ للمهمة.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق نموذج جديد للذكاء الاصطناعي المادي
أعلنت شركة TwelveLabs عن إطلاق أحدث إصدار من نموذجها Pegasus 1.6، والذي يضيف قدرات متقدمة لفهم البيئات الواقعية المعقدة والتنقل فيها. يأتي هذا الإطلاق في وقت تشهد فيه رقمنة العالم المادي تسارعاً، مما يؤدي إلى تجميع كميات هائلة من الفيديو المعقد، بينما تظل تحويل هذه اللقطات الخام إلى نماذج قابلة للتنفيذ تحدياً حاسماً أمام فرق الذكاء الاصطناعي.
أكد جاي لي، المؤسس المشارك والرئيس التنفيذي للشركة، أن مهمتهم الدائمة هي مساعدة الآلات على فهم كيفية عمل العالم من خلال الفيديو. وأوضح أن الذكاء الاصطناعي المادي يمثل التعبير التالي عن هذه المهمة، مشيراً إلى أن معظم المعرفة البشرية المتعلقة بالأعمال المادية، مثل تغيير قبضة اليد أو التعافي بعد انزلاق جسم، لم تُلتقط من قبل في شكل يمكن للآلة أن تتعلم منه.
من منظور الشخص الأول: فهم الفيديو الذاتي
يمثل إصدار Pegasus 1.6 أول نموذج ذكاء اصطناعي من الشركة مصمم خصيصاً لفهم الفيديو الذاتي (Egocentric video)، وهو النوع الملتقط من وجهة نظر الشخص المنفذ للعمل. يمكن أن يكون هذا الشخص طاهياً يعد وجبة، أو عاملاً يجمع قطعاً في خط إنتاج، أو مشغلاً يتحكم في روبوت عن بُعد. يهدف هذا النهج إلى تحويل تلك اللقطات إلى معرفة منظمة وقابلة للمراجعة، مما يتيح لفرق الروبوتات التدريب على التجربة البشرية الحقيقية بدلاً من البدء من الصفر.
شدد جاي لي على أن النظام لا يتطلب استخدام كاميرات محددة أو أجهزة مملوكة من قبل الشركة لالتقاط اللقطات. وأوضح أن الأهم هو القدرة على التقاط التفاعلات والأفعال من وجهة نظر المشغل. كما أشار إلى أن الفيديو الذاتي أسهل في الجمع والتوسع مقارنة ببيانات التشغيل عن بُعد، مما يجعله مصدراً قيماً لبناء مجموعات بيانات ضخمة للتدريب.
خمس مسارات عمل لتحسين البيانات
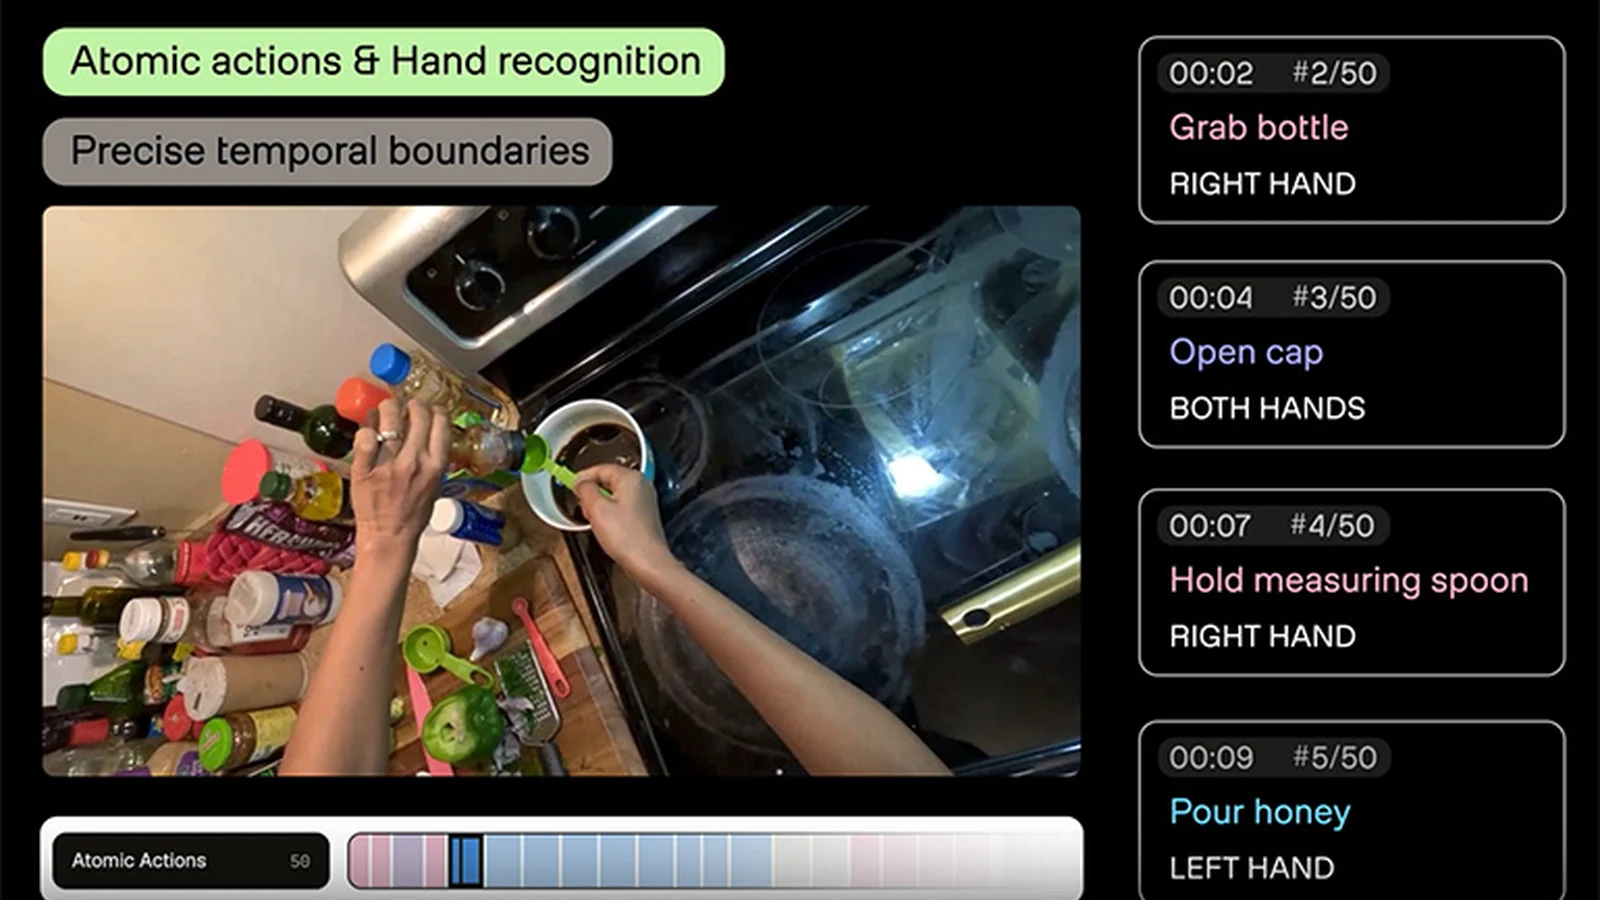
يدعم Pegasus 1.6 حالياً خمسة مسارات عمل مدعومة بنموذج أصلي للفيديو. تشمل هذه الميزات تقسيم الإجراءات وتسميتها، حيث يقوم النظام تلقائياً بتوليد تسميات زمنية دقيقة للمهام والخطوات والتفاعلات بين اليد والكائنات، مما يسرّع تدريب النماذج عبر مجموعات بيانات قياسية. كما يوفر النظام تسمية وصفية كثيفة تتيح للروبوتات فهم العلاقات المكانية وسياق المشهد بلغة طبيعية، مما يدعم تدريب سياسات روبوتية متقدمة تعتمد على اللغة.
تتضمن الميزات الأخرى تقييم الجودة، حيث يقوم النظام بتقييم مقاطع الفيديو تلقائياً من حيث وضوح الإجراء والإطار والاستقرار، مما يوفر وقت المراجعين البشريين. كما يوفر النظام قدرات بحث وتنظيم تتيح اكتشاف الحالات الحرجة والنادرة عبر مستودعات الفيديو باستخدام استعلامات لغة طبيعية، بالإضافة إلى إشارات الامتثال والموافقة التي تكشف عن الوجوه والبيانات الحساسة لضمان الخصوصية قبل إدخال اللقطات في خطوط التطوير.
تعزيز الفهم المكاني والزمني
يوفر نموذج Pegasus 1.6 سياقاً زمنياً واستدلالاً مكانياً، بالإضافة إلى حكم حول ما إذا كانت المهمة مكتملة. وأوضح جاي لي أن النظام يركز على طبقة فهم الفيديو، مشيراً إلى أنه لا يمكن ببساطة ضخ ملايين الساعات من الفيديو في نموذج روبوتي والتوقع الحصول على بيانات تدريب مفيدة دون فهم ما يحدث أولاً. يجب تحديد الإجراء، وتوقيته، والكائنات المتفاعلة، وكيفية تغير السلوك مع مرور الوقت.
أضاف لي أن النموذج الجديد يوفر فهماً أدق يتيح لفرق الروبوتات والبيانات تحويل هذا الفهم إلى البيانات التدريبية المطلوبة. كما أشار إلى أن النظام يضيف فهم الفيديو إلى حساسات أخرى، حيث يمكنه تحديد الإجراء، وتقسيمه زمنياً، وفهم ما تفعله اليدان اليمنى واليسرى، وكيف يتغير المحيط. ورغم قدرته على تقديم فهم خشن لحركة الأطراف، إلا أن الشركة تؤكد أنها لا تسعى لاستبدال استشعار الروبوت على مستوى المحركات أو اللمس، بل تهدف إلى تزويد الفرق بفهم أغنى لسلوك الفيديو يمكن دمجه مع بيانات الحساسات الخاصة بهم.
تحسينات على الإصدارات السابقة والتعاون الصناعي
يبني Pegasus 1.6 على قدرات فهم الفيديو التي طورتها TwelveLabs للمؤسسات التي تحتفظ بمكتبات فيديو ضخمة. يمتد الإصدار الجديد عن وظائف Pegasus 1.5 التي جذبت عملاء جدد، مثل ميزة البيانات الوصفية الزمنية (TBM) التي تتيح للمستخدمين تعريف مخطط مخصص واستلام بيانات وصفية منظمة تلقائياً. كما يحسن النموذج الجديد التعرف على الكيانات لتتبع أكثر اتساقاً لليد والأدوات عبر المقاطع، مع توفير معالجة أسرع وأكثر كفاءة من حيث التكلفة لأحمال الفيديو عالية الحجم.
أفادت الشركة بأن Pegasus 1.6 يوسع نطاق تعاونها الحالي مع مطوري الروبوتات. وأوضح جاي لي أنهم يعملون مع مختبرات روبوتية وفرق بيانات تستخدم الفيديو لتوسيع نطاق البيانات المتاحة لتدريب الروبوتات. تركز العديد من هذه الجهود على المهام المتعلقة بالمهارة والتلاعب، مثل التغليف والتجميع والتنظيف، بالإضافة إلى تطبيقات صناعية متخصصة مثل مراقبة جودة أشباه الموصلات. الهدف الأوسع هو مساعدة هذه الفرق على التعامل مع كميات أكبر من البيانات لبناء مسارات تعلم أكثر دقة.
المصادر
- The Robot ReportPegasus 1.6 brings video understanding to physical AI, says TwelveLabs
تابع التسلسل الزمني
أخبار مرتبطة
ويكي ميديا: روبوتات OpenAI قد تكون وراء انقطاع مايو
تؤكد مؤسسة ويكي ميديا اكتشاف نشاط لوكلاء OpenAI غير مصرح بهم، شمل تعديلات على ويكيات ومحاولات استغلال أدوات، مما قد يكون سبباً في انقطاع جزئي.
شركة REK تتلقى إنذاراً رسمياً من كاليفورنيا بعد نزال بشري ضد روبوت
أصدرت لجنة كاليفورنيا الرياضية أمراً بوقف نشاط شركة REK بعد تنظيمها نزالاً بين يوتيوبر وثلاثة روبوتات بشرية، مهددةً بمحاكمته جنائياً.
شركة Figure تذيب روبوتات F.02 في فرن فولاذي بوزن 75 طناً
اعتمدت شركة Figure الأمريكية طريقة غير تقليدية للتخلص من أسطول روبوتات F.02 القديمة عبر إذابتها في حديد سائل، بعد اقتراح من الممثل أرنولد شوارزنغر، مما وفر جهد التفكيك اليدوي.
روبوتات الذكاء الاصطناعي المادي تعيد تشكيل استراتيجيات الأمن الفيزيائي
تستثمر الشركات مليارات الدولارات في دمج الروبوتات مع الذكاء الاصطناعي المادي لمواجهة التهديدات السيبرانية والفيزيائية المتزايدة، مع التركيز على حماية الأصول الحرجة.