أوركا سيكيوريتي تخفض كلفة الاستعلامات السحابية 90% بالذكاء الاصطناعي
تسعى أوركا سيكيوريتي إلى تبسيط إدارة البنية التحتية السحابية عبر تحويل الأسئلة الطبيعية إلى استعلامات تقنية دقيقة، مستفيدة من نماذج الذكاء الاصطناعي.
 رضوان عبدالهاديمحرر وكاتب تقني
تحدي إدارة البنية التحتية السحابية
واجه محللو الأمن تحدياً كبيراً في الحصول على إجابات سريعة حول بنيتهم التحتية السحابية دون الحاجة إلى إتقان لغات الاستعلام المتخصصة. تغطي أداة أوركا سيكيوريتي أكثر من 900 نموذج سحابي، بما في ذلك موارد Amazon EC2 وAmazon S3، مما يتطلب أسماء دقيقة وتنقلاً معقداً بين العلاقات الهرمية واختياراً من 18 مشغلاً منطقياً. هذا التعقيد جعل عملية الاستعلام صعبة للمستخدمين العاديين.
إطلاق أداة Discovery AI
لحل هذه المشكلة، تعاونت أوركا سيكيوريتي مع AWS لتطوير Discovery AI، وهي وكيل استعلام بلغة طبيعية يعمل على Amazon Bedrock. تهدف الأداة إلى تحويل أسئلة اللغة الإنجليزية البسيطة إلى استعلامات Sonar صالحة. توفر أوركا سياقاً أمنياً للبيانات السحابية والكود والذكاء الاصطناعي، بينما يمثل Sonar نظام الاستعلام الخاص بها الذي يتيح البحث والتصفية عبر شبكة البيانات الكاملة.
قيود النموذج الأولي
بدأ فريق أوركا بنموذج تجريبي يحمّل مخطط Sonar الكامل في موجه واحد على أكبر نموذج متاح. على الرغم من جودة المخرجات، ظهرت ثلاث عوائق رئيسية عند التوسع: استهلاك غير فعّال للرموز بلغ حوالي مليوني رمز لكل عملية، مما رفع التكاليف؛ وزمن استجابة عالٍ بلغ 60 ثانية لكل عملية؛ ودقة محدودة في الاستعلامات المعقدة متعددة النماذج. أثبت الفريق جدوى الفكرة، لكن التحدي كان في جعلها سريعة ورخيصة ودقيقة بما يكفي للإنتاج.
البنية متعددة المراحل
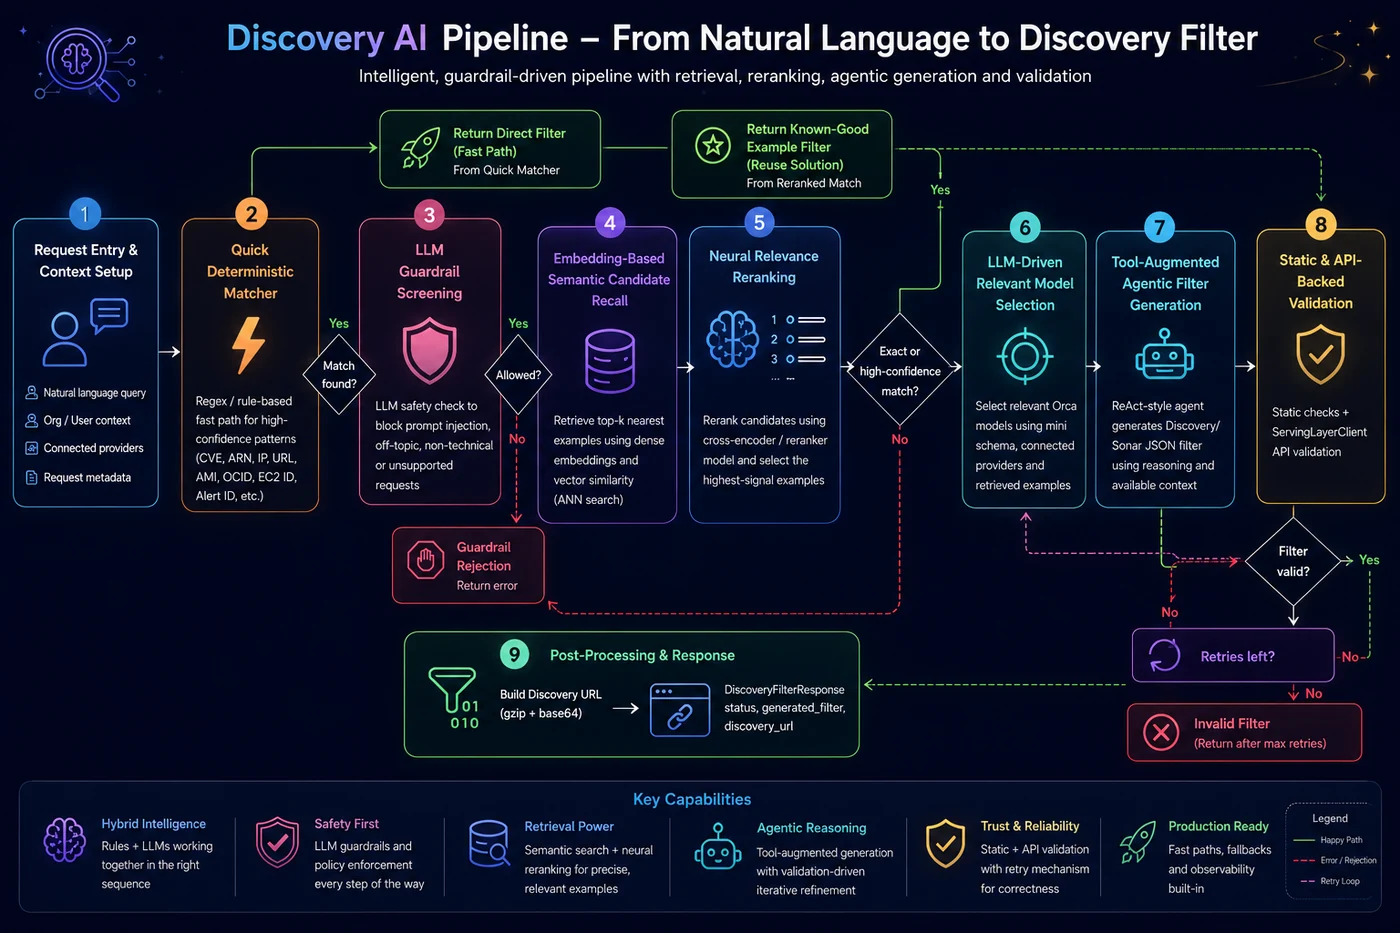
صممت أوركا حلًا هجينًا على Amazon Bedrock يجمع بين توليد المعزز بالاسترجاع (RAG) وبناء الاستعلامات الواعية بالمخطط. تتكون البنية من تسع مراحل، حيث يُخصص لكل مرحلة نموذج أساسي مناسب. اختارت أوركا Amazon Bedrock لتوفير وصول متعدد النماذج عبر واجهة برمجة واحدة، مما يسمح بتوزيع نماذج مختلفة على مراحل خط الأنابيب دون إدارة تكاملات منفصلة. كما يوفر النظام ضوابط حوكمة AWS مثل IAM وVPC endpoints وCloudTrail، مما يلبي متطلبات الأمن الصارمة.
آلية عمل خط الأنابيب
تبدأ العملية بدمج طلب المستخدم مع السياق التنظيمي والمزودين السحابيين المتصلين. ثم يمر الطلب عبر مطابقة حتمية سريعة للكشف عن أنماط محددة مثل عناوين IP أو CVEs. إذا لم يتم العثور على تطابق، يتم فحص الطلب عبر حواجز حماية (Guardrails) لمنع حقن الموجهات والطلبات غير ذات الصلة. بعد ذلك، يستخدم النظام Amazon Titan Text Embeddings لاسترجاع 20 مثالًا سابقًا ذا صلة، ثم يعيد ترتيبها باستخدام Cohere Rerank 3.5 لاختيار أفضل خمسة أمثلة.
توليد الاستعلام والتحقق
يقوم نموذج الاختيار بتضييق نطاق أكثر من 900 نموذج Sonar إلى مجموعة صغيرة ذات صلة بالطلب، مما يقلل السياق غير الضروري. يستخدم المولد وكيلًا معززًا بالأدوات لبناء فلتر Discovery النهائي، مع إمكانية التحسين التكراري. أخيرًا، يخضع الفلتر المولد لاختبارات التحقق الثابتة والتحقق عبر واجهة برمجة Sonar لضمان الصحة النحوية والدلالية. عند الفشل، يُعاد الخطأ للمعالجة.
النتائج والأداء
أظهرت النتائج تحسناً كبيراً مقارنة بالأساس الأولي: انخفاض كلفة الاستعلامات بنسبة 90%، وتقليل الرموز المدخلة بنسبة 93%، وخفض زمن الاستجابة بنسبة 75% ليصل إلى 15 ثانية. يتيح هذا النظام معالجة آلاف الاستعلامات يومياً بكفاءة عالية. يعتمد النظام على نماذج مثل Anthropic Claude Haiku 4.5 وAmazon Nova 2 Lite، مع إمكانية استبدال النماذج بأحدث الإصدارات دون إعادة هندسة البنية.
المصادر
- AWS Machine Learning BlogNatural language security queries at Orca Security using Amazon Bedrock
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
أمازون تطلق بيئة تشغيل AgentCore الجديدة لتعزيز كفاءة وكلاء الذكاء الاصطناعي
أعلنت AWS عن بيئة تشغيل AgentCore الجديدة ضمن Amazon Bedrock، التي توفر إدارة ذاكرة مرنة وأوقات تشغيل ثابتة وسريعة للوكلاء الأذكياء في بيئات الإنتاج.
Worldwide Express تخفض استثناءات الشحن 75% عبر الذكاء الاصطناعي
اعتمدت Worldwide Express على Amazon Bedrock لأتمتة معالجة استثناءات الفوترة في الشحن، مما أدى إلى تحرير 10 ملايين دولار من التدفق النقدي وتحسين دورة التحصيل.
إطار AAIF يوازن بين النماذج المحلية والسحابية في AWS
يقدّم إطار AAIF الذكي، المبني على Strands Agents، حلاً لتقليل تكاليف الذكاء الاصطناعي عبر توجيه المهام الروتينية لنماذج محلية والمهام المعقدة لسحابة Amazon Bedrock.
أمازون تعلن عن Claude Haiku 5.5 على Bedrock بتكلفة أقل
أطلقت أمازون النموذج Claude Haiku 5.5 على Amazon Bedrock، وهو أسرع وأكثر كفاءة في عائلته، ويوفر خفضاً بنسبة 75% في التكاليف للمهام عالية الحجم والحساسة للتكلفة.