كيف حسّنت Deepgram كفاءة الذكاء الاصطناعي الصوتي باستخدام شرائح AWS Trainium
نجحت شركة Deepgram في تحسين كفاءة وأداء نماذج الذكاء الاصطناعي الصوتي وخفض التكاليف عبر نقل نموذجها للتخاطب إلى معالجات AWS المخصصة.
 رضوان عبدالهاديمحرر وكاتب تقني
تعاون هندسي لرفع كفاءة الاستدلال الصوتي
في ظل النمو المتسارع لتطبيقات الذكاء الاصطناعي الصوتي واستخداماته الواسعة في تحليل مراكز الاتصال والنسخ الطبي، تسعى الشركات التقنية باستمرار لخفض التكاليف التشغيلية ورفع القدرة الاستيعابية للبنية التحتية. في هذا السياق، تعاونت شركة Deepgram مع فريق هندسة AWS Forward Deployed لنقل وتكييف نموذج تحويل الكلام إلى نص الشهير Nova-3 للعمل على معالجات الأجهزة المتطورة، بهدف تحسين كفاءة الاستدلال في مهام الدفعات غير المتصلة بالإنترنت والتعامل مع الكثافة العالية للبيانات الصوتية بكفاءة اقتصادية عالية. ويمكن الرجوع إلى AWS Machine Learning Blog للاطلاع على التفاصيل الأصلية للمصدر.
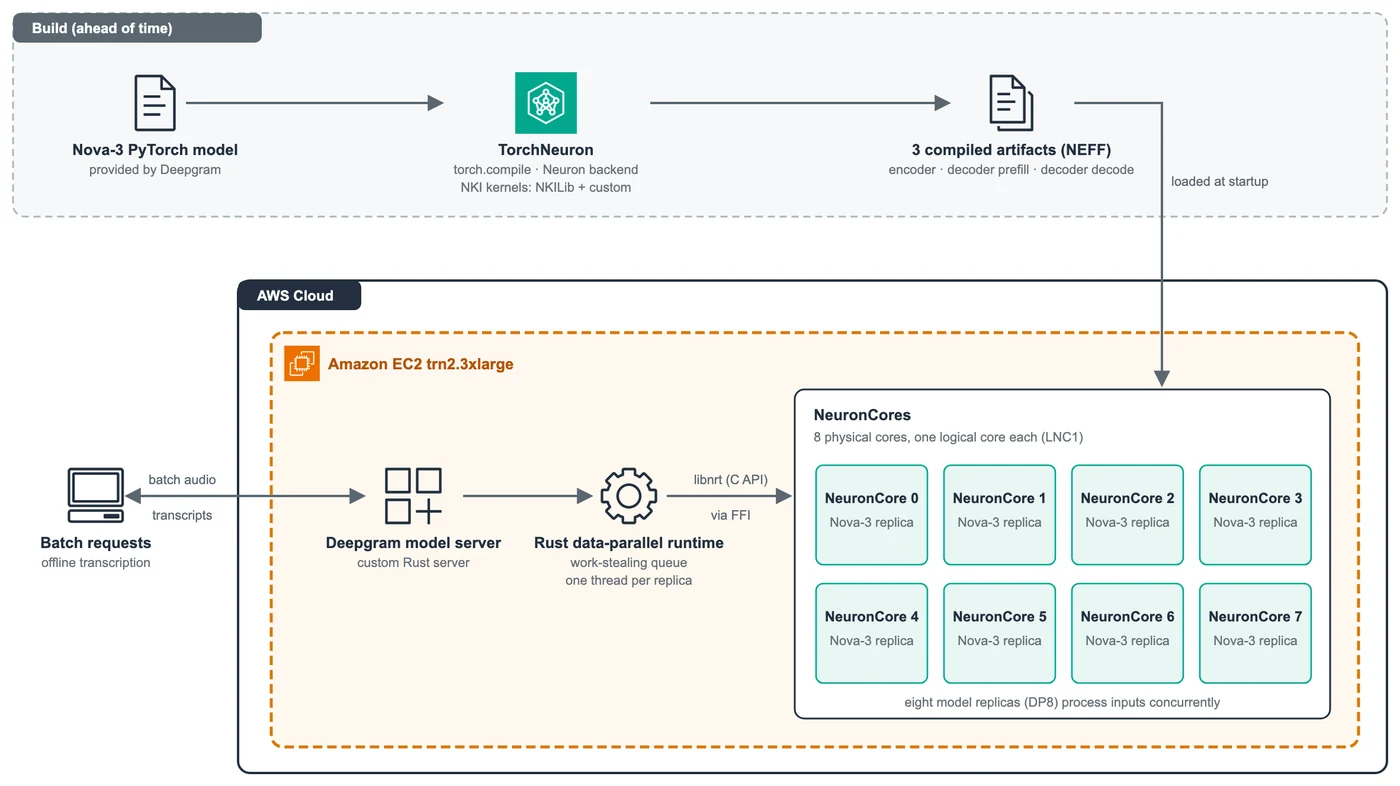
بدأ العمل بتسليم نموذج Nova-3 كرمز برمجي قياسي بلغة PyTorch، ليقوم الفريقان المشتركان بإعادة بناء النموذج وضبطه ليتوافق تماماً مع البيئة الهندسية لشرائح AWS Trainium2 الجديدة. ونتج عن هذه التحسينات تشغيل ثماني نسخ من النموذج بكفاءة عالية على مثيل حوسبي سحابي واحد، مما ساهم بشكل مباشر في معالجة كميات أكبر من الملفات الصوتية مقابل التكلفة المالية لكل ساعة تشغيل.
التحسين البرمجي باستخدام حزمة AWS Neuron
تم الاعتماد في عملية تحويل وتجميع النموذج على بيئة البرمجيات الخاصة بشريحة تريونيوم، حيث جرى استخدام أداة الترجمة المدمجة وتطبيق تقنيات الفحص الدقيق لضمان عدم حدوث أي تراجع في العمليات الحسابية والتحقق من دقة النتائج مقارنة بالمعالجات التقليدية. وقد تضمن العمل تفكيك المكونات الأساسية للنموذج إلى رسومات بيانية ثابتة الشكل، وتطبيق حزم برمجية مخصصة للعمليات الرياضية لضمان أعلى مستويات الأداء وسرعة المعالجة.
كما تم توظيف واجهات تشغيل النواة المخصصة للاستفادة القصوى من القدرات الحسابية الداخلية للمعالجات، مع إجراء اختبارات مكثفة عبر أحجام دفعات مختلفة لتحديد النقطة المثلى التي تضمن أعلى معدل إنتاجية ممكنة دون الإخلال بالدقة العامة للنموذج الصوتي.
التنفيذ عبر بيئة تشغيل Rust المخصصة
تطلبت عملية دمج النموذج في بيئة الإنتاج الخاصة بشركة Deepgram تجاوز الاعتماد التقليدي على لغة بايثون ومكتباتها الثقيلة داخل مسار خدمة الطلبات. لتحقيق ذلك، بنى الفريق بيئة تشغيل خفيفة الوزن ومكتوبة بلغة Rust تتولى التنسيق بين نسخ النموذج عبر طوابير عمل موزعة وفعالة، مما أدى إلى إلغاء الاختناقات الناتجة عن قيود المعالجة المتزامنة في اللغات الأخرى.
أثبتت الاختبارات المعيارية أن بيئة التشغيل الجديدة بلغة Rust نجحت في تقليل العبء على المضيف وتسريع استجابة النظام للطلبات المتزامنة، مسجلة تفوقاً واضحاً في الإنتاجية العامة مقارنة بالبدائل البرمجية التقليدية، وهو ما انعكس إيجاباً على إجمالي الأداء وسرعة إرجاع النصوص للمستخدمين.
النتائج الاقتصادية وكفاءة الأداء
أظهرت قياسات الأداء مقابل التكلفة أن البنية المحسنة للنموذج على المعالجات الجديدة استطاعت معالجة كميات إضافية كبيرة من البيانات الصوتية لنفس الميزانية مقارنة بالخيارات الحوسبية السابقة التي كانت تعتمد عليها الشركة. هذه المكاسب المادية والفنية لا تقتصر على عمليات الشركة الداخلية فحسب، بل تمتد لتشمل العملاء الذين يشغلون هذه النماذج بأنفسهم ضمن بيئاتهم السحابية الخاصة.
تؤكد هذه التجربة نجاح استراتيجية تحسين الاستدلال الصوتي بالتعاون بين فرق الهندسة المتقدمة، مما يمهد الطريق أمام المزيد من التطورات في كفاءة تشغيل نماذج الذكاء الاصطناعي الضخمة وتقديمها بأسعار تنافسية للمطورين والمؤسسات حول العالم.
المصادر
- AWS Machine Learning BlogHow Deepgram optimized voice AI at scale with AWS Trainium
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
التدريب الموزع عبر Ray Train DLCs وEFA على EKS
استكشاف كيفية استخدام حاويات Ray Train لمواجهة تحديات التدريب الموزع لنماذج الذكاء الاصطناعي عبر EFA وAmazon EKS دون الحاجة لبناء صور.
أمازون تطلق TorchNeuron لكسر هيمنة إنفيديا على الذكاء الاصطناعي
أطلقت أمازون ويب سيرفيسز أداة TorchNeuron التي تتيح للمطورين نقل تطبيقات PyTorch إلى شرائح Trainium بتغيير بسيط، في محاولة لخفض التكاليف وكسر الاحتكار.
ضبط نموذج GPT-OSS-20B للاستدلال متعدد اللغات على SageMaker
تعرف على كيفية ضبط نموذج GPT-OSS-20B للاستدلال متعدد اللغات باستخدام Amazon SageMaker HyperPod وتحقيق دقة كاملة بلغة الاستدلال.
TorchNeuron يسهّل تشغيل نماذج Hugging Face على AWS Trainium
أطلقت Hugging Face وAWS تقنية TorchNeuron لتوفير واجهة برمجية أصلية لنماذج الذكاء الاصطناعي على معالجات Trainium، مما يرفع نسبة دعم البنى المعمارية ويحسّن كفاءة التدريب والاستدلال.