كيف تغلبت Property Finder على تحيز تقييم الذكاء الاصطناعي
أظهرت تجربة عملية لشركة بروبرتي فايندر أن الاعتماد على مخرجات النماذج القديمة لتقييم النماذج الجديدة يخلق تحيزاً خفياً، وتمكنت الشركة عبر إعادة هندسة بيانات التحقق من خفض التكاليف بشكل قياسي.
 رضوان عبدالهاديمحرر وكاتب تقني
اكتشاف التحيز الخفي في التقييم
واجه فريق الهندسة في شركة Property Finder تحدياً تقنياً كبيراً عند محاولة تحديث نظام الرؤية الحاسوبية الخاص بهم، حيث تبين أن نسبة هائلة بلغت 96.8 بالمئة من بيانات التقييم والوسوم كانت موروثة مباشرة من التنبؤات السابقة للنموذج القديم، وليس عبر التدقيق البشري المستقل.
هذا الاعتماد الدائري أدى إلى تحيز نظام الحقائق الأساسية لصالح النموذج الحالي، مما جعل أي نموذج بديل يظهر بمظهر الضعيف أو غير القادر على المنافسة، بغض النظر عن كفاءته الفعليّة، وهو ما عطل الجهود المبكرة لمقارنة النماذج بشكل موضوعي ودقيق.
طبيعة العمليات والتحديات التشغيلية
تقوم المنصة بمعالجة عشرات الآلاف من صور العقارات يومياً في منطقة الشرق الأوسط وشمال أفريقيا، حيث يخضع كل عقار لعملية تقييم تشمل 11 سمة مرتبطة بالجودة لكل صورة يتم رفعها، مما يولد حجماً هائلاً من البيانات التي تتطلب تقييماً دقيقاً وسريعاً قبل نشرها.
تتنوع هذه السمات لتشمل كشف العلامات المائية، وتصنيف الغرف، وحالة الأثاث، وجودة الصور، ومؤشرات البناء، ومع وجود متوسط 15 صورة لكل إعلان عقاري، أصبحت الحاجة ملحة للبحث عن خيار أكثر كفاءة من حيث التكلفة، دون الإخلال بمعايير الدقة والاعتمادية.
بناء أساس حقائق بشري غير متحيز
لكسر هذه الحلقة المفرغة، قام الفريق الهندسي بالاستعانة بخبراء بشريين متخصصين لإجراء عمليات تقييم ووسم مستقلة بالكامل دون الرجوع إلى مخرجات النماذج السابقة، وشمل ذلك وسم مئات الصور من الإمارات ومصر لضمان تمثيل واقعي وموضوعي لمختلف القطاعات الصناعية.
تولى خبراء الاستراتيجيات والتحليل عملية الوسم استناداً إلى معايير جودة إعلانات العقارات، بينما قام فريق مركز ابتكار الذكاء الاصطناعي التوليدي لدى AWS بإجراء مراجعات جودة منهجية وجلسات توضيحية لضمان تطابق المعايير وتقليل الحالات الغامضة عبر مجموعة البيانات بأكملها.
دورة تحسين التوجيه لتحقيق الكفاءة
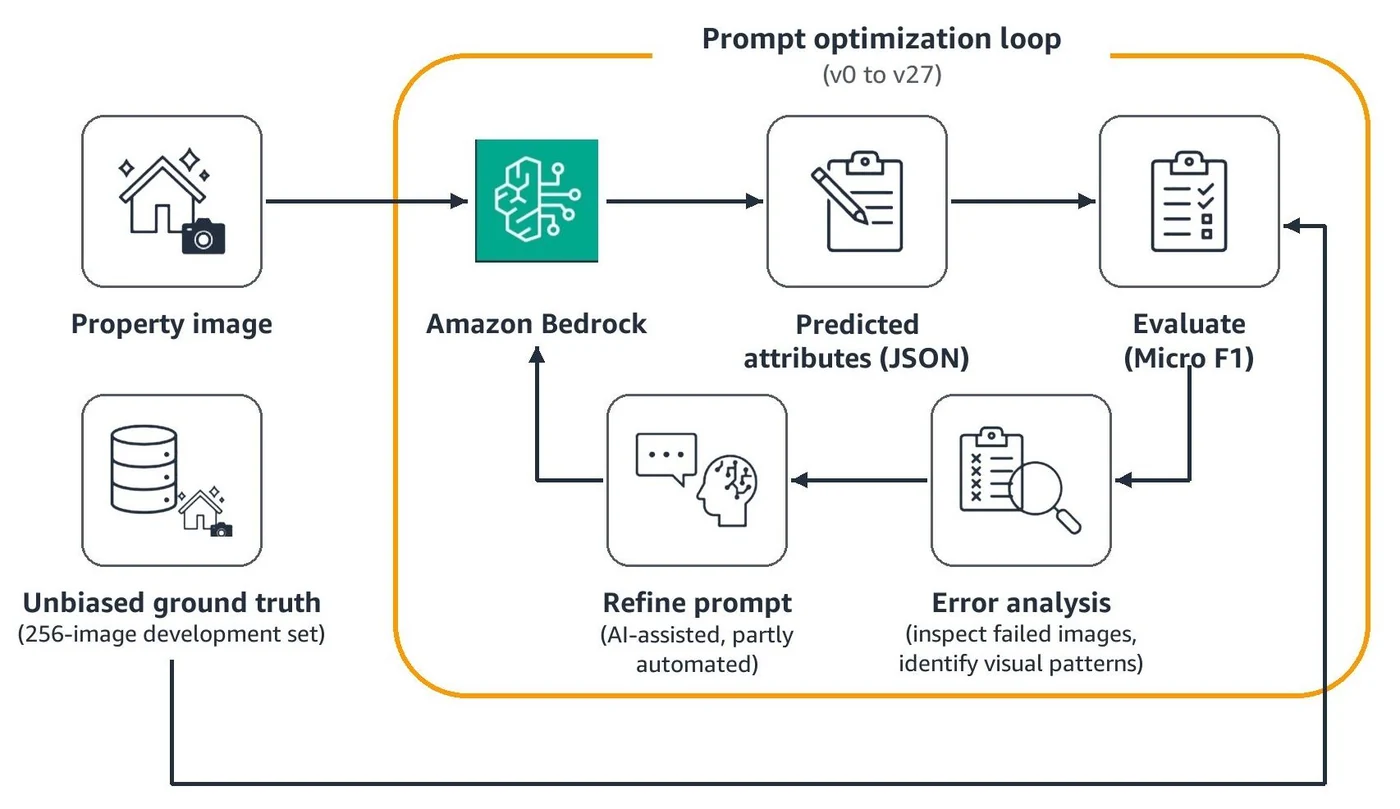
بعد تصحيح منهجية التقييم وإزالة التحيز، انتقل العمل إلى مرحلة تحسين الأداء باستخدام حلقة تحسين مشابهة للتعلم التعزيزي، حيث تم التعامل مع كل إصدار توجيهي كوكيل ذكي يتم قياس أدائه وتطويره باستمرار بناءً على نتائج التحليل الدقيق للأخطاء.
أثمرت هذه الجهود عن اختيار نموذج أحدث وأكثر كفاءة على منصة Amazon Bedrock، مما مكن الشركة من تحقيق زيادة ملحوظة في دقة التصنيف مع خفض التكاليف التشغيلية بنسبة وصلت إلى 86 بالمئة عبر جميع سمات جودة الصور.
المقاييس المعتمدة في تقييم الأداء
اعتمد الفريق مقياس Micro F1 كمؤشر رئيسي لتقييم الأداء لأنه يمنح وزناً متساوياً لكل تنبؤ، مما يتطابق مع الأهداف التجارية العامة لصحة الوسوم، إلى جانب استخدام مقياس Macro F1 لمراعاة الفئات النادرة التي قد تختفي وسط البيانات الضخمة المتكررة.
كما تم استخدام مقاييس الدقة والاسترجاع لكل تسمية على حدة لتحديد أنماط الإخفاق بدقة، واستخدام مؤشر التقاطع على الاتحاد لقياس مدى تداخل التنبؤات مع وسوم الخبراء البشريين، مما ضمن تقييماً شاملاً يمنع أي تضليل إحصائي مستقبلاً.
المصادر
- AWS Machine Learning BlogFix evaluation bias to unlock better models on Amazon Bedrock
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
أمازون تطلق بيئة تشغيل AgentCore الجديدة لتعزيز كفاءة وكلاء الذكاء الاصطناعي
أعلنت AWS عن بيئة تشغيل AgentCore الجديدة ضمن Amazon Bedrock، التي توفر إدارة ذاكرة مرنة وأوقات تشغيل ثابتة وسريعة للوكلاء الأذكياء في بيئات الإنتاج.
Worldwide Express تخفض استثناءات الشحن 75% عبر الذكاء الاصطناعي
اعتمدت Worldwide Express على Amazon Bedrock لأتمتة معالجة استثناءات الفوترة في الشحن، مما أدى إلى تحرير 10 ملايين دولار من التدفق النقدي وتحسين دورة التحصيل.
إطار AAIF يوازن بين النماذج المحلية والسحابية في AWS
يقدّم إطار AAIF الذكي، المبني على Strands Agents، حلاً لتقليل تكاليف الذكاء الاصطناعي عبر توجيه المهام الروتينية لنماذج محلية والمهام المعقدة لسحابة Amazon Bedrock.
أمازون تعلن عن Claude Haiku 5.5 على Bedrock بتكلفة أقل
أطلقت أمازون النموذج Claude Haiku 5.5 على Amazon Bedrock، وهو أسرع وأكثر كفاءة في عائلته، ويوفر خفضاً بنسبة 75% في التكاليف للمهام عالية الحجم والحساسة للتكلفة.