CWE-bench v2 يوسّع تغطية اختبارات الأمان للذكاء الاصطناعي
تهدف النسخة الجديدة إلى رفع معايير الشفافية والجودة في تقييم النماذج اللغوية على مهام الأمن السيبراني المعقدة، مع توفير أدوات تقييم برمجية حتمية.
 رضوان عبدالهاديمحرر وكاتب تقني
إطلاق CWE-bench v2 لتوسيع آفاق التقييم
أعلنت شركة Collinear AI عن إطلاق النسخة الثانية من منصة CWE-bench، وهي مخصصة لاختبار حدود القدرات السيبرانية للنماذج المتقدمة. تتيح هذه النسخة الوصول إلى مجموعة عامة من 100 مهمة يمكن لأي مطور أو باحث تشغيلها وتقييم نماذجه عليها. يعتمد التصميم على تسليم وكيل ذكاء اصطناعي نسخة من مستودع مفتوح المصدر حقيقي مع تعليمات موجزة، بهدف العثور على نقطة ضعف أمنية وإصلاحها دون كسر الوظائف الحالية.
منهجية التقييم والشفافية
تتميز المنهجية الجديدة بتقييم برمجياً كاملاً، مما يجعل النتائج حتمية وقابلة لإعادة الإنتاج من قبل أي شخص دون تكاليف إضافية. تم صياغة الفحوصات البرمجية بمساعدة لجان تحكيم تعتمد على نماذج لغوية كبيرة، مع التركيز على صعوبة المهام وعادلتها. كما تحتفظ الشركة بمجموعة مهام محجوزة (held-out set) لم يرها أي نموذج سابقاً، لمتابعة التقدم المستمر. يمكن للباحثين طلب تقييم نماذجهم على هذه المجموعة المحجوزة عبر التواصل المباشر مع فريق الأمن في الشركة.
التغطية الشاملة لنقاط الضعف
تسعى المنصة إلى تحقيق شمولية تامة في التغطية، حيث تغطي المهام المئة 91 نوعاً مختلفاً من نقاط الضعف (CWE). هذا التنوع يتطلب من النموذج فهم أسطح الضعف المتعددة التي قد يستغلها المهاجم، وليس مجرد التعرف على الأنماط المألوفة. يؤكد المطورون أن الدفاع الناجح يتطلب توقع طرق الاختراق المحتملة والتعامل معها بدقة في كل مرة، مما يجعل هذا المعيار اختباراً حقيقياً للقدرات التحليلية للذكاء الاصطناعي.
معايير الجودة والمراجعة اليدوية
خضعت كل مهمة في المجموعة لمراجعة دقيقة لضمان الجودة، حيث تم التحقق من عدة معايير: هل تبدو التعليمات واقعية؟ هل يمكن استنتاج السلوك المطلوب من التعليمات؟ هل يتحقق المقيس من السلوك الصحيح وليس البنية المحددة للإصلاح؟ كما تم التأكد من أن الكود الأصلي يفشل وأن الإصلاح المرجعي يمر، مع الحفاظ على عمل الوظائف الأصلية. تمت مراجعة كل مهمة يدوياً، وتُرحب الشركة بالملاحظات والمساهمات في المجموعة العامة لتحسينها باستمرار.
نتائج التقييم والأداء
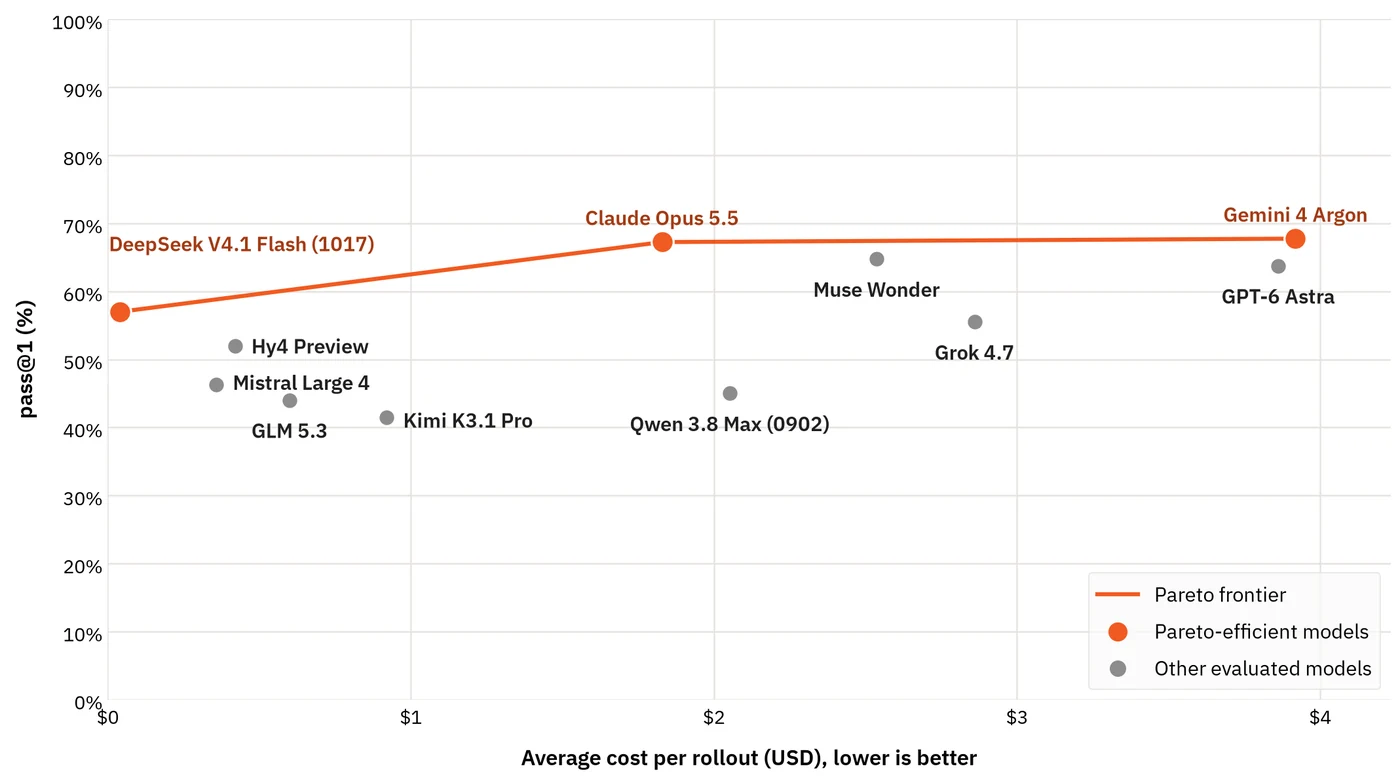
تُتتبع النتائج في مكانين على منصة Hugging Face: لوحة قيادة تغطي النماذج مفتوحة الوزن، ولوحة قيادة شاملة تشمل النماذج المتاحة عبر الواجهات البرمجية فقط. من بين 11 نموذجاً تم تقييمها، تصدر Gemini 4 Argon بنسبة نجاح 67.8% في المحاولة الأولى (pass@1)، متقدماً بفارق ضئيل على Claude Opus 5.5 بنسبة 67.3%. حلّت 95 مهمة على الأقل بنجاح بواسطة نموذج واحد، مما يؤكد قابلية حل المهام، لكن حتى النموذج المتصدر فشل في 19% من المجموعة في كل محاولة، مما يشير إلى أن التحديات ما زالت صعبة.
التكلفة والكفاءة الاقتصادية
من حيث التكلفة، تشكل ثلاثة نماذج جبهة باريتو (Pareto frontier): DeepSeek V4.1 Flash، وClaude Opus 5.5، وGemini 4 Argon. حقق DeepSeek نسبة نجاح 57.0% بتكلفة 0.04 دولار لكل عملية تنفيذ، بينما أضاف Opus 10 نقاط مئوية بتكلفة 1.83 دولار، وتقدم Gemini قليلاً بتكلفة 3.92 دولار. هذا التوازن بين الأداء والتكلفة يوفر خيارات متنوعة للمطورين حسب ميزانياتهم وأهدافهم.
الأدوات التقنية والتكامل
تعمل كل مهمة كبيئة Harbor مستقلة، وتتكون من بيئة Docker، تعليمات، ومقيس حتمي. يأتي مجموعة البيانات مع سجل registry.json، مما يتيح لأداة Harbor تشغيل الاختبار الكامل مباشرة من مستودع Hugging Face دون الحاجة إلى استنساخ يدوي. كما تم وسم المهام بعلامة rl-environment، مما يعني أن نفس البيئات والمقيسات يمكن استخدامها لتقديم مكافآت لتدريب الوكلاء الدفاعيين، وليس فقط لتقييمهم.
المصادر
- Hugging Face BlogCWE-bench v2: More coverage, quality, and transparency
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
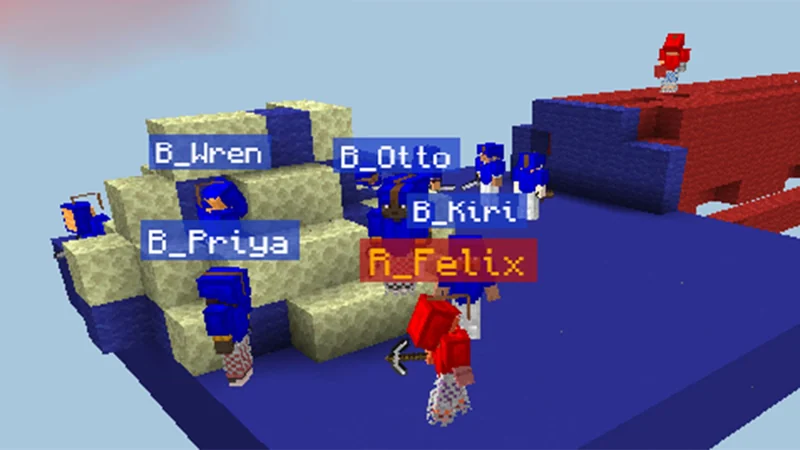
عقبات بيروقراطية تعيق بناء مدنية من 50 وكيل ذكاء اصطناعي في ماينكرافت
اختبر باحثون أسراباً من وكلاء الذكاء الاصطناعي في ماينكرافت لبناء حضارة، لكن الفرق المكونة من 50 عنصراً فشلت بسبب البيروقراطية المفرطة وسلوكيات الجمود.
مايكروسوفت تحوّل تدرّب الوكلاء عبر مكافآت قواعد البيانات
تقدّم مايكروسوفت نظام ThinkingBox الذي يحوّل التحقق من حالة قاعدة البيانات إلى مكافآت للتدريب، مما رفع دقة نموذج Qwen3.8-27B بنسبة ملحوظة.
عقود تكامل نماذج ترانسفورمرز لتعزيز جودة الذكاء الاصطناعي
تستعرض مدونة Hugging Face معايير جديدة لعقود تكامل نماذج الذكاء الاصطناعي تسمى Transformers Model Integration Contracts لاكتشاف الأخطاء.
أداة جديدة لمعرفة توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium
تتيح مساحة تفاعلية جديدة على منصة Hugging Face للباحثين والمطورين التحقق بسهولة من توافق نماذج الذكاء الاصطناعي مع شرائح AWS Trainium.