شركة CedarDB تدمج قواعد البيانات بدعم الذكاء الاصطناعي
تسعى شركة CedarDB الناشئة من ميونخ إلى كسر الحاجز التقليدي بين قواعد البيانات التشغيلية والتحليلية، مستفيدة من الطفرة الكبيرة التي أحدثها وكلاء الذكاء الاصطناعي.
 رضوان عبدالهاديمحرر وكاتب تقني
تجاوز الانقسام التقليدي في عالم قواعد البيانات
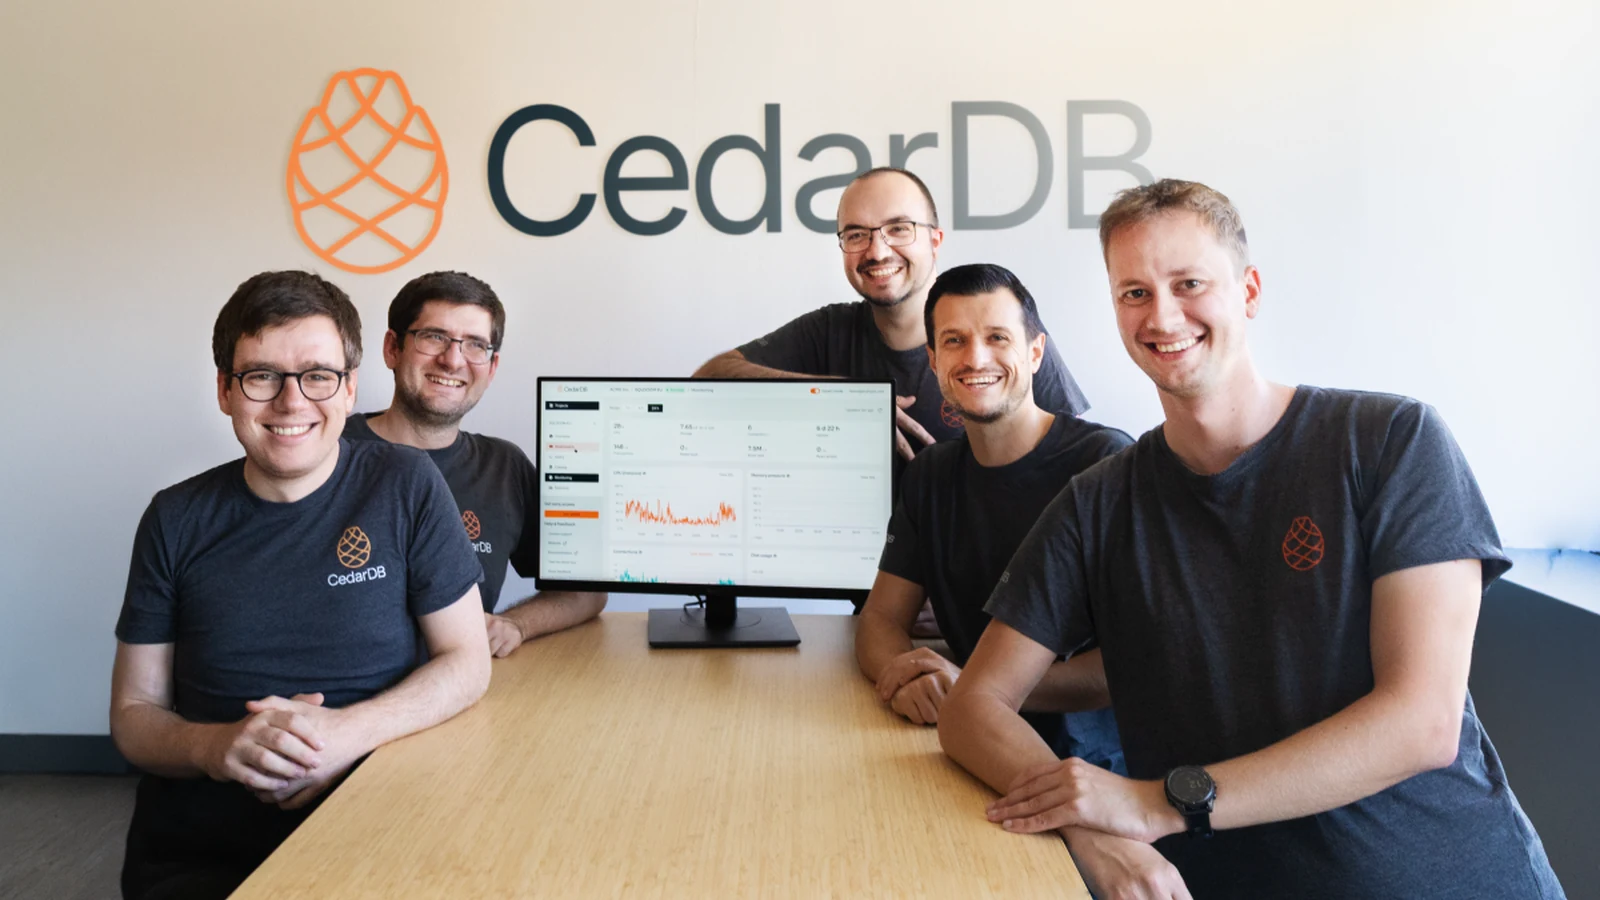
اعتادت المؤسسات والشركات تاريخياً على تصميم قواعد البيانات لأداء مهمة واحدة محددة؛ إما مساعدة الشركات على اكتشاف الاتجاهات وتحليل البيانات، أو تخزين سجلات المعاملات اليومية مثل الأوامر ومدفوعات العملاء. ومع ذلك، فإن محرك قواعد البيانات الناشئ <CedarDB>، الذي يتخذ من مدينة ميونخ مقراً له، يدعم الوظيفتين معاً في نظام موحد، وفقاً لما صرح به المؤسس المشارك والرئيس التنفيذي موريتز سيشيرت لمنصة <TechCrunch>.
وقد اكتسب هذا النهج المبتكر أهمية مضاعفة مع الصعود السريع لوكلاء الذكاء الاصطناعي، حيث واجهت الشركات الكبرى تحديات حقيقية تتمثل في امتلاك بنى بيانات مناسبة لتخزين سنوات من المعاملات، لكنها تعجز عن الاستجابة السريعة للأسئلة التحليلية المعقدة التي تطرحها الأنظمة الذكية باللغة الطبيعية.
الجذور الأكاديمية والتركيز المطلق على الكفاءة
يعود تطوير نظام <CedarDB> إلى عقد كامل من الزمن، وهو نتاج شركة ناشئة منبثقة عن جامعة ميونخ التقنية مستندة في أساسها إلى مشروع بحثي يحمل اسم <Umbra>. وقد جرى تصميم هذا المشروع من الصفر للتفوق على محركات قواعد البيانات القديمة من حيث سرعة معالجة البيانات والاستفادة القصوى من عتاد الأجهزة الحديثة.
حافظ الفريق، الذي يضم خمسة باحثين من مشروع Umbra كمؤسسين مشاركين، على هذا النهج الهندسي <promising faster performance> دون الحاجة إلى موارد إضافية من وحدات المعالجة المركزية أو الذاكرة، مع تقليل التعديلات التي يتعين على العملاء إجراؤها على تطبيقاتهم.
ولتحقيق ذلك، حرص فريق العمل على ضمان أن يكون النظام <compatible with PostgreSQL>، وهو نظام قواعد بيانات مفتوح المصدر واسع الانتشار، مما يسهم في خفض تكاليف الانتقال والتبديل على المستخدمين.
التوافق مع المعايير ومواءمة الذكاء الاصطناعي
أوضح سيشيرت أن التوافق مع هذا النظام <popular database> لا يقتصر فقط على تقليل التكاليف وتجنب إعادة بناء التطبيقات، بل يمنح ميزة إضافية تتمثل في اتباع المنطق البرمجي الذي تدربت عليه نماذج اللغة الكبيرة وألفته تماماً.
وفي <blog post> نشره المؤسس المشارك كريستيان وينتر، استعرض الفريق الأولويات الرئيسية التي وضعت بعد مغادرة المجال الأكاديمي، والتي تركزت على الموثوقية، وتحمل الأعطال، والتوافق مع الأدوات البرمجية الشائعة.
محطات التمويل وإطلاق الإصدار السحابي
شهد شهر مايو من العام الماضي محطة هامة تمثلت في <announced> الإصدار المؤسسي CedarDB Enterprise إلى جانب النسخة المجانية CedarDB Community Edition، بالتزامن مع جولة تمويلية أولية بلغت <€5.3 million> (ما يعادل تقريباً 6 ملايين دولار أمريكي).
ورغم تأجيل إطلاق النسخة السحابية في البداية وعدم طرحها فوراً، فقد قامت الشركة باختبارها عبر نسخ تجريبية مع المستخدمين المسجلين في قائمة الانتظار، لتعلن رسمياً عن التوافر المحدود لخدمة السحابة خلال فعاليات <TechCrunch Disrupt>، حيث تتنافس الشركة ضمن مسابقة <Startup Battlefield>.
التنافس في سوق البيانات وعصر الوكلاء الذكية
من المرجح أن تساعد النسخة المُدارة بالكامل والمستضافة سحابياً <CedarDB> على توسيع قاعدة مستخدميها لتتجاوز نطاق الشركات الكبرى وحدها، مما يضعها في منافسة مباشرة مع شركات بيانات كبرى أخرى مثل Databricks التي اتجهت نحو رؤية مشابهة.
وتعتمد الشركة الناشئة حالياً على فريق يضم 14 فرداً لخدمة مستخدمي الخدمة السحابية الأوائل، مع توقعات بالتوسع وزيادة حجم الفريق عند تحقيق مزيد من الزخم ونمو قاعدة العملاء.
المصادر
- TechCrunchCedarDB wants one database to handle both transactions and analytics, as AI agents raise the stakes
تابع التسلسل الزمني
أخبار مرتبطة
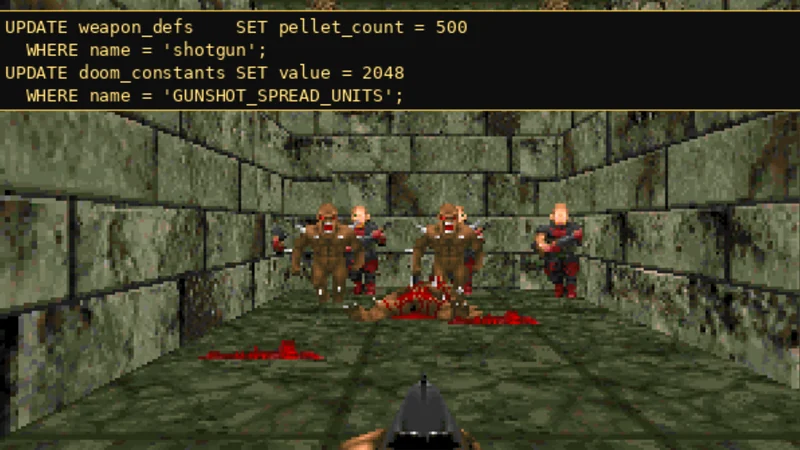
خبير قواعد البيانات يشغّل لعبة Doom عبر SQL في 5900 سطر
نجح مشروع SQLDoom في تشغيل لعبة Doom داخل قاعدة بيانات CedarDB باستخدام 5900 سطر من الكود، مع دعم الرسوميات والصوت والعبث الجماعي بكفاءة عالية.
قمة TechCrunch للمؤسسين 2026: من Toast إلى Bessemer في بوسطن
تستضيف TechCrunch قمة المؤسسين 2026 في بوسطن بمشاركة قادة من Toast وBessemer، للبحث في تحديات التوسع، بناء الفرق، والذكاء الاصطناعي.
آبل تطلق نظام Minions لتحويل أجهزة ماك الخاملة إلى سحابة GPU افتراضية
كشفت أبحاث آبل عن نظام Minions الذي يستغل أجهزة ماك الخاملة لتنفيذ مهام الاستدلال الذكي، مما يقلص أوقات الانتظار من ساعات إلى دقائق ويخفف الضغط على خوادم GPU.
داون مايرز تطلق أداة ريتشوالست لتسهيل العناية بالشعر المجعد
تقدم شركة ريتشوالست أداة Mint التي تختصر وقت تصفيف الشعر المجعد إلى 10 دقائق، مستخدمة تقنية تدفئة وقطع غيار قابلة للتعبئة.