ميتا توسع نموذج GEM للإعلانات بمعمارية Kunlun ومحرك حوسبة مركزي
أعلنت ميتا عن الجيل الجديد من نموذج GEM التوليدي، الذي يمثل نقلة نوعية في أنظمة التوصية عبر دمج التعلم العميق على نطاق واسع لتحسين أداء الإعلانات.
 رضوان عبدالهاديمحرر وكاتب تقني
نموذج مركزي لتوحيد نظام التوصية
أطلقت شركة ميتا الجيل الجديد من نموذجها التوليدي للإعلانات (GEM)، الذي يمثل أكبر نموذج أساسي لنظام التوصية في القطاع. يهدف هذا التحديث إلى الانتقال من التحسينات المعزولة لكل منصة على حدة إلى نموذج أساسي مركزي واحد يتعلم من البيانات والإشارات عبر جميع منصات الإعلانات التابعة لميتا. يهدف هذا النموذج إلى منح منحنى التوسع في الحوسبة انحناءً يشبه النماذج اللغوية الكبيرة، مما يتيح تحقيق نتائج إعلانية قوية عبر تقنيات ما بعد التدريب التي تمنح ميزانية زمنية أكبر دون الحاجة إلى تقييم فوري لجميع المرشحين الإعلانيين.
يتميز الجيل الجديد من النموذج بأنه يعمل على بنية تدريب أكثر كفاءة بشكل كبير، مما يؤدي إلى مكاسب متزامنة في أداء الإعلانات عبر كل سطح إعلاني ومرحلة من مراحل مسار التحويل. كما يوفر فهماً أعمق لمحتوى الإعلانات مما يساعد في مطابقتها بشكل أفضل مع ما يبحث عنه المستخدمون، مما يعزز العائد على الاستثمار للمعلنين.
مكاسب ملموسة في الأداء
أظهرت البيانات التي أعلنتها ميتا أن نموذج GEM حقق تحسناً بنسبة 18.9% في التحويلات و12% في معدل النقر (CTR) عبر أسطح وأهداف إعلانات ميتا المختلفة. بالإضافة إلى ذلك، ساهم النموذج في رفع التحويلات بنسبة 5.8% على فيسبوك، و4.1% على إنستغرام، و1.6% في التحويلات خارج الموقع للمستخدمين المستهدفين خلال العام الماضي. تغطي هذه المكاسب أسطح المسار العلوي وأهداف التحسين العميق، مما يؤدي إلى تحقيق عوائد أقوى للمعلنين.
معمارية Kunlun وانحناء منحنى التوسع
تواجه أنظمة التوصية تحدياً في تطبيق قوانين التوسع التجريبية التي تظهر في النماذج اللغوية، بسبب الميزات غير المتجانسة الضخمة وتوزيعات البيانات المتغيرة. لحل هذه المشكلة، طورت ميتا معمارية جديدة بنمط النماذج اللغوية تسمى Kunlun، تم تصميمها بالتعاون مع أحدث أجهزة معالجة الرسومات (GPU). تهدف هذه المعمارية إلى جعل النماذج الأكبر والأعمق أكثر كفاءة من حيث التكلفة، وتمكين التعلم السياقي الطويل لتاريخ تفاعل المستخدمين.
لاحظت ميتا قانون توسع يشبه النماذج اللغوية على أكبر نطاق تدريب مسبق لها، مع نمو في تعقيد النموذج بمقدار 2.5 مرة مقارنة بالإصدارات السابقة. يعكس هذا النمط سلوك النماذج اللغوية الرائدة، حيث تؤدي السعة الأكبر والسياق الأطول إلى مكاسب ناشئة في جودة الترتيب تتحول مباشرة إلى نتائج تجارية ملموسة.
نقل الذكاء بكفاءة عالية
تواجه أنظمة التوصية تحدياً في تقديم نماذج بهذا الحجم في الوقت الفعلي، حيث أن التكلفة prohibitive والزيادة في زمن الاستجابة تؤثر سلباً على تجربة المستخدم وعائد المعلنين. لحل ذلك، طورت ميتا تقنية ما بعد التدريب المتقدمة تسمى LoopFM، التي تنقل التمثيلات الداخلية والذاكرة التاريخية التسلسلية لنموذج GEM إلى النماذج الفرعية.
من خلال مشاركة الحسابات، تضاعف هذه التقنية نقل الذكاء مع تقطير المعرفة المستخدم في الإصدار السابق، دون أي تكلفة حوسبة إضافية أو تأخير. كما قدمت ميتا تقنية الحساب المسبق المرن (Solaris) لجمع المكاسب من النموذج العلوي، مما يضمن تقديم النتائج بكفاءة عالية.
محرك حوسبة موحّد عبر المنصات
تمتد تطبيقات ميتا عبر عشرات الأسطح، بما في ذلك فيسبوك وإنستغرام وReels وStories، ويستخدمها 3.6 مليار شخص يومياً على الأقل. كان كل سطح أو هدف تحسين يملك سابقاً نظام تنبؤ مستقلاً، مما جعل التحسين المتزامن لأداء الإعلانات تحدياً متزايداً مع نمو المنصة. يسرّع GEM محرك حوسبة موحداً واحداً من خلال النموذج الأساسي المركزي الذي يتنبأ بالنقرات والتحويلات عبر جميع الأسطح والأهداف الرئيسية للمعلنين.
تنتقل التمثيلات القابلة للتعميم التي تتعلمها على مهام النقر الغنية بالبيانات إلى مهام التحويل الفقيرة بالبيانات. كما يجعل وصفة تدريب جديدة مع خلط البيانات المجاني وإطار عمل الخبراء في المجال هذا التعلم غير المتجانس واسع النطاق قابلاً للتنفيذ، مع نطاق قابل للتنبؤ وموثوقية معززة.
تسريع التدريب على نطاق واسع
يتطلب تدريب نموذج أساسي لنظام التوصية عبر آلاف وحدات معالجة الرسومات تنسيقاً دقيقاً للحوسبة والتوازي والاتصال والذاكرة. نظراً لأن وحدات معالجة الرسومات في مراكز البيانات اليوم معتمدة بشكل أساسي على أعباء عمل النماذج اللغوية، فإن أعباء عمل التوصية لها ملف مختلف جذرياً بسبب خصائص البيانات الفريدة، مما يجعل تحقيق استخدام عالٍ لوحدة المعالجة صعباً مع التوسع.
طورت ميتا نوى مخصصة بدقة منخفضة واستراتيجيات توازي خماسية الأبعاد جديدة، تم تصميمها بالتعاون مع أحدث أجهزة معالجة الرسومات وعناقيد التدريب الخاصة بالشركة. كما تم تحسين معمارية النموذج مع البنية التحتية معاً للتوسع بكفاءة عبر آلاف وحدات المعالجة. تضاعفت كفاءة التدريب الشامل لتصل إلى 20-25% من استخدام FLOPS للنموذج (MFU) مع 4 أضعاف إجمالي FLOPS للتدريب، مما يتيح لنموذج GEM التدريب على نطاق النماذج اللغوية في ميتا.
المصادر
- Meta EngineeringMeta’s Generative Ads Model (GEM): Scaling the Central Model and Compute Engine for Frontier Ads AI
تابع التسلسل الزمني
تغطية الكيانات المرتبطة
أخبار مرتبطة
ميتا تكشف عن GEM: نموذج إعلانات توليدي يرفع التحويلات 18.9%
تعلن ميتا عن الجيل الجديد من نموذج GEM، الذي يجمع بين البنية المعمارية Kunlun وتوزيع الموارد الحاسوبية لرفع كفاءة الإعلانات عبر منصات فيسبوك وإنستغرام.
ميتا تختبر تحويل فيسبوك وإنستغرام إلى فيديوهات عمودية شاملة
تختبر شركة ميتا واجهات جديدة تجعل فيسبوك وإنستغرام يفتحان مباشرة على فيديوهات عمودية شاملة، في خطوة نحو تقليد تجربة تيك توك وتغيير جذري في نمط التفاعل الاجتماعي.
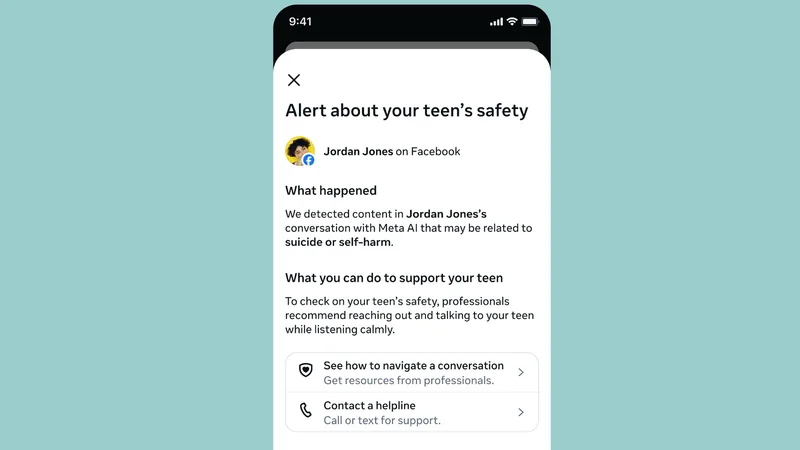
ميتا توسع نطاق تنبيهات الأهل على فيسبوك بشأن إيذاء النفس
تطلق شركة ميتا ميزة تنبيه أولياء الأمور حال بحث المراهقين المتكرر عن محتوى إيذاء النفس عبر فيسبوك ومحادثات المساعد الذكي Meta AI.
زوكربيرغ: ميتا تدخل مرحلة جديدة مع وكيل Muse الذكي
كشفت ميتا عن خطط لتحويل وكيل Muse الذكي إلى محرك إيرادات رئيسي، متجاوزاً تطبيقاتها الحالية. زوكربيرغ يؤكد على نمو المستخدمين والأرباح.